《大模型应用开发极简入门》:GPT-4 与 ChatGPT 应用开发指南
综述由AI生成本书《大模型应用开发极简入门》面向普通开发者,系统介绍了 GPT-4 和 ChatGPT 的基本原理及在 Python 中的应用方法。内容涵盖 Transformer 架构演进、OpenAI API 使用策略、应用安全与密钥管理、提示工程及微调技术,并探讨了 LangChain 框架。书中强调理解大模型基本架构而非细节,提供从入门到进阶的完整知识体系,适合希望快速构建智能应用的开发者参考。

综述由AI生成本书《大模型应用开发极简入门》面向普通开发者,系统介绍了 GPT-4 和 ChatGPT 的基本原理及在 Python 中的应用方法。内容涵盖 Transformer 架构演进、OpenAI API 使用策略、应用安全与密钥管理、提示工程及微调技术,并探讨了 LangChain 框架。书中强调理解大模型基本架构而非细节,提供从入门到进阶的完整知识体系,适合希望快速构建智能应用的开发者参考。

综述由AI生成详细阐述了利用 Python 进行图像背景抠图的三种技术路径。首先介绍了针对纯色背景的像素级透明度处理;其次探讨了通过采样学习多色背景颜色的方法;最后提出了一种基于 RGB 最大最小值范围的统计阈值法。文章通过代码示例和效果对比,分析了各方案的优缺点,展示了如何通过简单的编程逻辑解决图像处理中的自动化需求,并总结了代码化处理工具在缺乏专业软件时的替代优势及性能优化方向。
综述由AI生成使用 Python 构建垂直爬虫系统的核心架构与实现细节。通过下载器、解析器、URL 管理器和输出器四个模块的协作,实现了网页数据的抓取与存储。内容涵盖模块功能设计、关键代码逻辑、数据清洗流程以及基础的反爬策略,为开发者提供了一套完整的爬虫框架参考方案。
综述由AI生成Python 常见报错涵盖属性访问、文件操作、缩进、索引越界、类型转换等多个方面。详细解析了 AttributeError、FileNotFoundError、IndentationError、IndexError、TypeError、ValueError 等核心异常的触发原因与修复方法,并补充了 ImportError、MemoryError 等场景。通过规范命名、检查路径、统一缩进、验证数据类型及使用 try-except 结构,可…

综述由AI生成Ollama 是一个用于本地部署和管理开源大语言模型的框架,极大简化了安装和配置流程。在 Linux、Mac 和 Windows 系统上安装 Ollama 的方法,包括 Docker 支持。内容涵盖如何启动服务、下载并运行 Llama 2、Mistral 等模型,以及通过 REST API 进行交互。此外,还讲解了如何配置局域网访问、指定 GPU 设备、修改模型存储路径等高级设置,并提供 Python 客户端示例,帮助用户快速构建本地…

综述由AI生成AI 模型组合是一种结合多个模型解决复杂问题的策略,利用各模型优势提升准确性与分析深度。常见实现方式包括顺序处理与并行处理,适用于多模态应用、集成建模及文档分析流水线等场景。该方案能显著提高系统性能,优化资源分配,并提供定制灵活性。文章探讨了使用 BentoML 进行多模型服务编排的实践,涵盖代码示例与部署架构,并分析了生产环境中面临的复杂性挑战,如配置管理、资源调度及版本控制,为构建高效的多模型 AI 系统提供指导。

综述由AI生成在 AI 大模型时代,个人搭建工作站进行模型训练所需的硬件成本。重点介绍了 GPU 选型(如 NVIDIA A100、RTX 4090)、系统配置建议及具体组件价格估算。通过对比美元与人民币汇率,提供了约 6.6 万元人民币的高性能训练主机预算参考,帮助开发者评估入行门槛与资源投入。文章还提及了硬件兼容性、散热及功耗等关键考量因素,为个人构建 AI 训练环境提供实用指南。

综述由AI生成详细梳理了人工智能从 1950 年至今的发展历程,涵盖连接主义与符号主义两大流派。重点解析了注意力机制的演进、Transformer 架构的核心原理(Self-Attention、位置编码、多头机制),以及 GPT 与 BERT 在预训练范式上的差异。文章还阐述了语言模型从规则驱动到预训练的演变,深入探讨了词嵌入与表示学习技术,并介绍了 ChatGPT 的三段训练法及 GPT-4 的多模态能力。最后总结了当前大模型面临的幻觉、安全等挑战…

综述由AI生成详细介绍如何利用大语言模型自动化构建垂直领域数据集,并结合 PEFT 技术对 Phi-3 等开源模型进行低成本微调。内容涵盖从原始文本到 Alpaca 格式的数据转换流程、LangChain 链式调用实现、训练参数配置及推理部署步骤。文章重点解决了数据集生成中的 Prompt 设计、数据清洗、LoRA 微调参数调优以及推理性能优化等关键问题,旨在帮助开发者在有限算力下快速构建专属大模型应用。

综述由AI生成梳理了 AI 大模型的核心概念与架构演变。涵盖大模型定义、分类及与大语言模型的区别。详解 Transformer 架构原理,包括 Self-attention、残差连接、Layer normalization 等关键技术。回顾 GPT 系列发展历程,从 GPT-1 到 GPT-4 的迭代,重点分析 ChatGPT 基于人类反馈强化学习(RLHF)的训练范式。对比主流大模型厂商产品,探讨技术优缺点及社会影响。最后介绍微调方法与 Self-…

综述由AI生成Meta 发布的新一代开源大语言模型 Llama 3。文章涵盖了 Llama 3 的两个主要版本(8B 和 70B)及其指令调优版,重点分析了其架构改进,包括扩展至 128k 的词汇表、分组查询注意力(GQA)机制以及 8000 Token 的上下文窗口。文中提供了基于 Transformers 库的代码示例,展示了如何进行基础推理、量化部署(4-bit)以及使用 TRL 进行微调。此外,还介绍了在 Hugging Face 推理端点、…

综述由AI生成基于 PaddleNLP 的 UIE 通用信息抽取框架。该框架统一了实体、关系、事件等抽取任务,支持零样本和小样本微调。内容涵盖开箱即用示例、基座模型选择、数据标注与模型微调流程、以及部署方案。通过自然语言定义 Schema,开发者可快速构建定制化信息抽取应用,无需大量训练数据即可实现冷启动。

综述由AI生成深入分析了 AI Agent 在企业应用中的六种基础类型及其技术架构。涵盖创作与生成类助手、企业知识助手(RAG 方案)、数据分析助手(Text-to-SQL/Code)、应用/工具助手(Function Calling)、Web 操作助手(类 RPA)以及自定义流程助手。文章对比了各类型的适用场景、实现框架(如 LangChain、AutoGen、MetaGPT)及实施挑战,强调了企业应用中可控性与安全性的平衡,并为技术选型与基础设施…

综述由AI生成Langfuse 是一款开源的 LLM 应用工程化平台,支持完全本地化部署。其三种部署方式(Docker Compose、独立数据库、本地开发)及健康检查步骤。内容涵盖与 LangChain 框架的深度集成方法,包括通过 CallbackHandler 实现追踪调试、利用 Prompts 管理功能进行模板版本控制、以及通过 SDK 上报用户评分以优化模型表现。此外,还展示了基础 SDK 集成方案及仪表盘数据分析功能,帮助开发者构建生产就…

综述由AI生成AI 大模型技术涵盖预训练、微调及中间件开发。解析了 Transformer 架构原理,包括自注意力机制与位置编码。阐述了生成式预训练流程及 GPT 系列演进。深入探讨了有监督微调(SFT)与人类反馈强化学习(RLHF),特别是 PPO 算法的应用。介绍了低算力场景下的模型迁移策略,如 LoRA 与量化剪枝。最后分析了 LangChain 等中间件框架在构建智能代理中的作用,并展望了具身智能等未来方向。

综述由AI生成国产大语言模型 ChatGLM3 的本地部署流程。内容涵盖环境配置、源码与模型下载、依赖安装及显存优化方案。重点讲解了如何通过量化技术降低显存占用,以及 Gradio 和 Streamlit 两种 Web 演示模式的启动方法。此外,文章还说明了如何搭建 OpenAI 兼容 API 服务,实现第三方应用集成,并介绍了通过自定义 Tool 扩展模型功能的方法。最后提供了常见 GPU 识别问题排查及 API 参数调优指南,帮助开发者快速构建本…

综述由AI生成主成分分析(PCA)是一种常用的无监督学习降维技术,通过正交变换将相关变量转化为线性不相关的主成分。其核心思想是方差最大化,旨在保留数据最大信息量的同时降低维度。详细阐述了 PCA 的数学原理、计算步骤及优缺点,并通过 Python sklearn 库结合鸢尾花数据集与人脸图像数据进行了实战演示,展示了如何确定主成分数量及可视化降维效果,适用于图像处理、金融分析及生物信息学等领域。

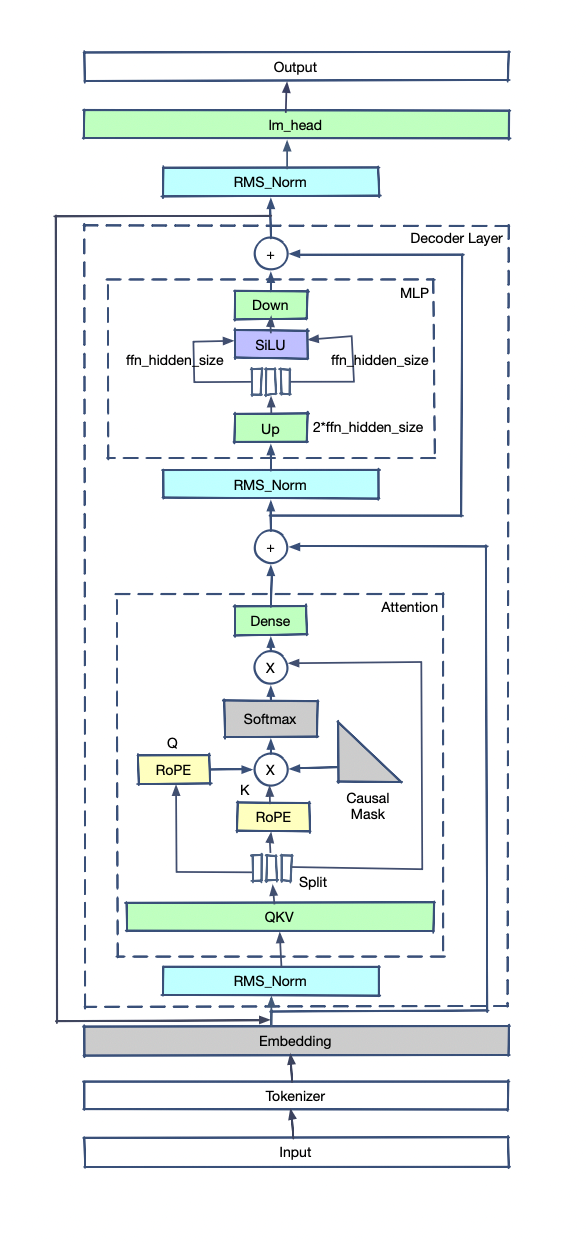
综述由AI生成LLM 大模型训练的基础概念,涵盖预训练、微调和人类对齐三种范式及其适用场景。内容详述了 PyTorch 框架下的张量操作、自动求导及模型构建流程,并深入解析了 Transformer 架构原理。文章对比了 Transformer 与 CNN、LSTM 的差异,重点讲解了 LLaMA2 和 ChatGLM2 模型的关键组件改进,包括 RMSNorm 归一化、RoPE 位置编码、SwiGLU 激活函数以及 GQA 注意力机制,为理解大模型…

综述由AI生成检索增强生成(RAG)技术通过引入外部知识库,有效缓解大语言模型在敏感问题上的知识幻觉。幻觉产生的原因及传统 RAG 的局限,提出了多路召回、重排序及安全对齐的综合解决方案,并探讨了实施细节与优化策略,旨在提升大模型回答的准确性与安全性。

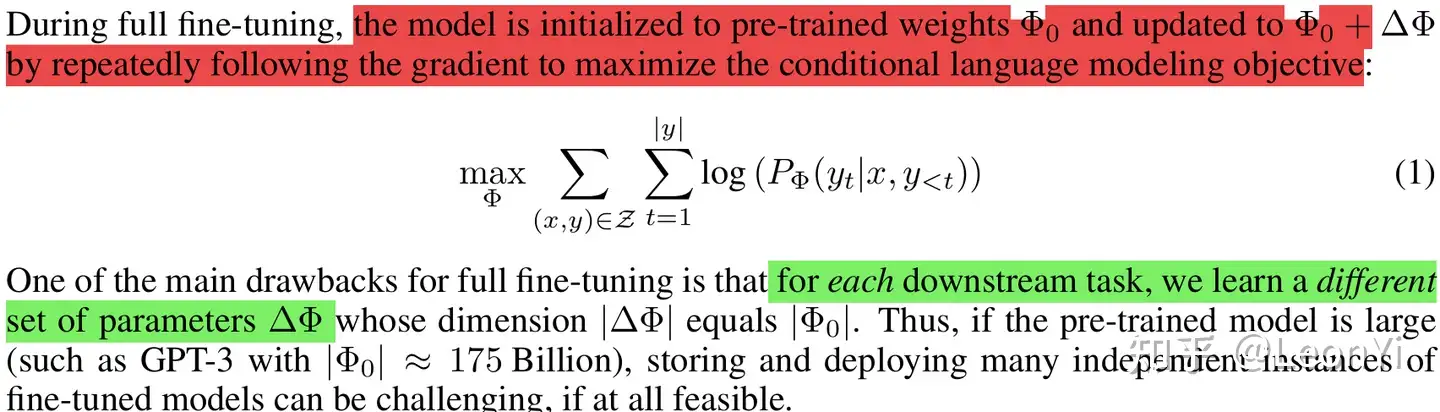
综述由AI生成详细解析了低秩适应(LoRA)在大模型高效微调中的核心原理,包括其通过低秩分解近似增量参数的机制、显存优化策略及梯度计算过程。文章阐述了为何 LoRA 能减少训练参数量而不影响推理性能,分析了秩 r 和系数 alpha 的选择对微调效果的影响,并对比了不同微调方法的硬件需求。最后总结了 LoRA 在实际应用中的参数配置建议,为开发者提供从理论到实践的完整指导。