
基于知识图谱的 GraphRAG 非结构化数据处理:LlamaIndex 与 Neo4j
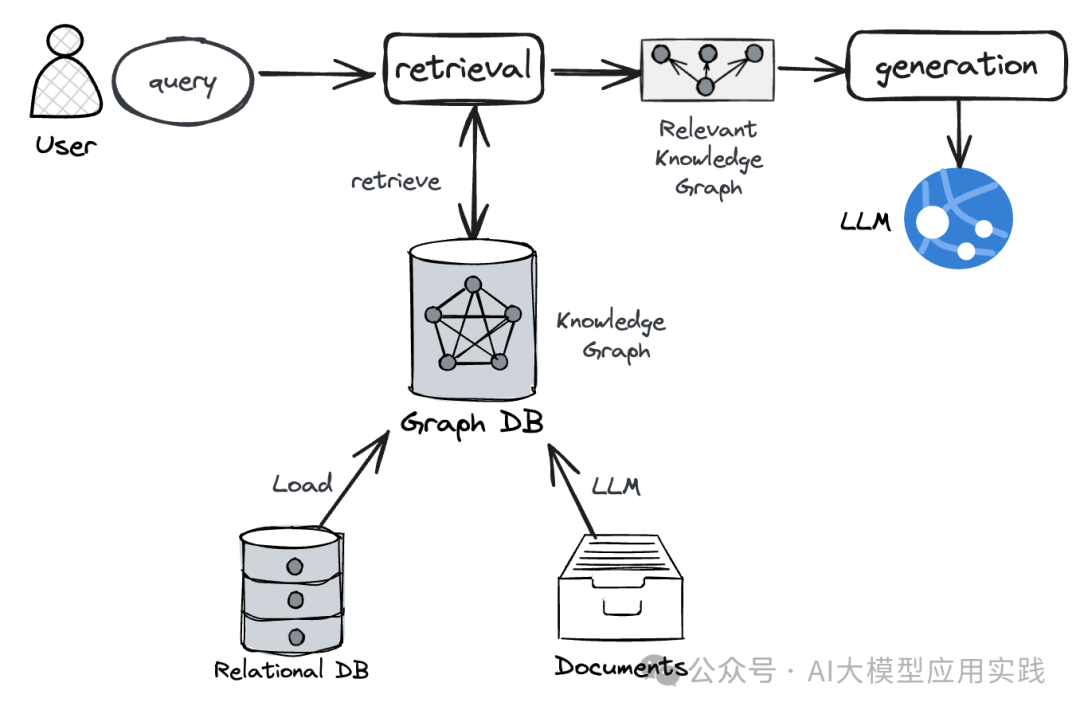
上篇简单介绍了构建 GraphRAG 的动机与架构。GraphRAG 的基础架构源自基于向量的经典 RAG 的转换。我们已经演示了如何把传统关系型数据库中的结构化知识转为知识图谱并用于 RAG 查询。本篇我们将关注非结构化数据,以一个简单的自然语言文本为例,了解如何借助 LLM 的开发框架来构建 GraphRAG 应用。
生成基于 Graph 的知识图谱
构建一个非结构化数据的 GraphRAG 应用,首要任务是把非结构化数据转换成以图结构表示的知识图谱,并存储到 GraphDB 如 Neo4j,用来提供后续检索与生成的基础。从非结构化文本到知识图谱,借助 LLM 是一种常见的也是最高效的方法:利用 LLM 强大的语义理解与推理能力,从非结构化文本中抽取大量的类似实体 - 关系 - 实体的三元组,并借助必要的接口(如 GraphDB 支持的查询语言)导入到 GraphDB 中创建对应的实体、关系与属性,形成知识图谱。
这里的核心是基于 LLM 而实现的 Extractor,即 Graph 结构的抽取组件。在不同的框架中有不同的组件实现,这里我们以 LlamaIndex 框架为例,其实现的核心组件为 LLMPathExtractor,一般用最简单的 SimpleLLMPathExtractor 进行代码实现即可(如果你熟悉 LangChain,可以研究类似的 LLMGraphTransformer 组件)。
为了更好的测试效果,我们用 LLM 生成了一个架空世界的城市故事作为构建知识图谱的非结构化数据来源。
from llama_index.core import SimpleDirectoryReader, PropertyGraphIndex, StorageContext, load_index_from_storage
from llama_index.graph_stores.neo4j import Neo4jPropertyGraphStore
from llama_index.core.indices.property_graph import SimpleLLMPathExtractor
from openai import OpenAI
import os

llm = OpenAI(model="gpt-4o")
embed_model = OpenAIEmbedding(model_name="text-embedding-3-small")

# 加载数据
documents = SimpleDirectoryReader(input_files=['./dreamcity.txt']).load_data()

# 图数据库
graph_store = Neo4jPropertyGraphStore(
    username="neo4j",
    password="Unycp123!!",
    url="bolt://localhost:7687",
)

# 知识抽取的提示词
prompt = '''
下面提供了一些文本。根据文本,提取最多 {max_knowledge_triplets} 个知识三元组,形式为(实体,关系,实体或属性)。避免使用停用词。仅输出三元组,不要有多余解释和说明。
---------------------
示例:
文本:Alice 是 Bob 的母亲。
三元组:Alice,母亲,Bob
文本:Philz 是 1982 年在伯克利创立的咖啡店。
三元组:
Philz,是,咖啡店
Philz,创立于,伯克利
Philz,创立于,1982 年
--------------------
文本:{text}
三元组:
'''

# 抽取结果的解析
def parse_fn(response_str: str) -> List[Tuple[str, str, str]]:
    lines = response_str.split("\n")
    triples = [line.split(",") for line in lines]
    return triples

# 定义知识抽取器
kg_extractor = SimpleLLMPathExtractor(
    llm=llm,
    extract_prompt=prompt,
    max_paths_per_chunk=50,
    parse_fn=parse_fn,
)

# 抽取创建图知识库索引(本地化做持久,避免反复抽取)
if not os.path.exists(f"./index_storage"):
    index = PropertyGraphIndex.from_documents(
        documents,
        embed_model=embed_model,
        kg_extractors=[kg_extractor],
        property_graph_store=graph_store,
        show_progress=True,
    )
    index.storage_context.persist("./index_storage")
else:
    print('Loading index...\n')
    storage_context = StorageContext.from_defaults(persist_dir="./index_storage",property_graph_store=graph_store)
    index = load_index_from_storage(storage_context=storage_context)
代码中已经包含了较为详细的注释说明,这里可以注意的是:
- 抽取过程最重要的工具是 LLM 与对应的提示词,这里用了少量示例提示模式(few-shot prompt),你可以根据不同语言的需要做优化。
- 借助于 PropertyGraphIndex 组件,可以快速的基于文档与抽取器生成知识图谱并存储到图数据库中(通过 Property_graph_store 指定)。
- 在生成知识图谱时,需要指定嵌入模型,这是为了在生成 Graph 的节点时,对节点的内容或者名称生成向量,用于后续的向量检索。
现在,运行这段代码,完成后登录到 Neo4j 的后端控制台,可以看到基于该文本的知识图谱已经生成。原始的文本将被分割成多个 chunk,并用来创建 label 为"chunk"的多个知识图谱节点,这个节点的 text 属性用来存放原始的文本,同时 embedding 属性用来存放生成向量。原始文本的 chunk 节点和其他抽取生成的节点关系是'MENTIONS'(提到)。
查看其详细的关联关系,可以看到整个知识图谱的构建情况。现在你可以使用 Cypher 语言查看抽取的实体节点及其关系,可以看到抽取工作完成的还不错。如果深入观察,可以发现实体节点也对名字生成了向量(比如下面的亚特兰斯),这也是为后续检索做准备。
基于 Graph 知识图谱的检索与生成
现在我们已经把非结构化的文本转化为基于 Graph 的知识图谱进行存储,并构建了必要的索引。那么如何基于这个知识图谱来完成检索与生成呢?这里有三种常见的知识图谱检索方法:
- Text-to-Cypher(或其他 Graph 查询语言)。这在上一篇介绍结构化数据的知识图谱检索时已经介绍,即把自然语言用 LLM 转化为 GraphDB 能够理解的查询语言(比如 Neo4j 的 Cypher)后进行检索。
- Vector Search。这需要 Graph 数据库有对应的向量检索技术支持,即在创建 Graph 时能够对节点或关系做 embedding(作为属性);在检索时再根据向量检索相似的节点与关系作为上下文。
- Keywords Search。借助 LLM 从自然语言的输入提取关键词或者同义词,然后使用提取的关键词借助 GraphDB 的能力检索出关联的节点与关系作为后续生成的上下文。
我们延续上面创建的知识图谱,基于 LlamaIndex 框架构建 RAG 检索与生成阶段的程序。这里先创建一个基于关键词的检索器,注意这里的 prompt,是用来抽取输入中的关键词:
def parse_fn(output: str) -> list[str]:
    matches = output.strip().split("^")
    keywords=[x.strip().capitalize() for x in matches if x.strip()]
    print(keywords)
    return keywords

prompt = (
        "给定一些初始查询,提取最多 {max_keywords} 个相关关键词,考虑大小写、复数形式、常见表达等。\n"
        "用 '^' 符号分隔所有同义词/关键词:'关键词 1^关键词 2^...'\n"
        "注意,结果应为一行,用 '^' 符号分隔。"
        "----\n"
        "查询:{query_str}\n"
        "----\n"
        "关键词:"
    )

synonym_retriever = LLMSynonymRetriever(
    index.property_graph_store,
    llm=llm,
    include_text=False,
    output_parsing_fn=parse_fn,
    max_keywords=10,
    synonym_prompt=prompt,
    path_depth=1,
)
检索器的参数通常包括使用的大模型、提取关键词的提示词、最大提取的关键词数量、检索的路径深度等。需要注意的是 include_text 参数,由于节点与关系都是从自然语言文本中提取,该参数代表在检索到相关的节点与关系后,是否同时将其原始的文本(也就是关联的 chunk 节点文本)包含进来作为上下文。
再创建一个向量的检索器,注意向量检索器需要指定的是嵌入模型而非大模型,因此也无需指定提示词参数:
vector_retriever = VectorContextRetriever(
    index.property_graph_store,
    embed_model=embed_model,
    include_text=False,
    similarity_top_k=2,
    path_depth=1,
)
在 LlamaIndex 中,可以将创建的两种类型检索器作为子检索器进行融合检索,从而形成更加丰富的上下文。借助 PGRetriever 这个组件即可实现:
retriever = PGRetriever(sub_retrievers=[synonym_retriever,vector_retriever])
retrieve_nodes = retriever.retrieve("梅林发现的东西最后运用到哪里了?")
for node in retrieve_nodes:
    print(node.text)
现在你可以首先对这个检索器的效果进行测试与观察,可以看到知识图谱检索器的检索结果是一些相关的"三元组",即节点 - 关系 - 节点;如果指定了 include_text,那么还会同时带出生成这些三元组的原始文本。
你可以直接基于上述检索器创建查询引擎(类似于 Langchain 的 Chain),即可用来生成查询响应:
query_engine = index.as_query_engine(
    sub_retrievers=[synonym_retriever,vector_retriever]
)

# 查询
response = query_engine.query("梅林发现的东西最后运用到哪里了?")
print(response)
观察后台的 LLM 调用跟踪信息,可以看到输入的完整上下文,以验证检索与生成过程的正确性。
优化建议与最佳实践
在实际应用中,基于 Graph 的 Index 与检索技术也可以结合传统向量检索以实现融合检索,用来适应更多样的应用场景。以下是一些优化建议:
- Chunk 策略调整:非结构化文本切分的大小直接影响知识图谱的粒度。过大的 chunk 会导致三元组过于宽泛,过小则可能丢失上下文。建议根据业务场景尝试不同的 chunk size,并结合 overlap 保持连续性。
- 嵌入模型选择:虽然默认使用 OpenAI Embedding,但在私有化部署场景下,可选择轻量级开源模型(如 BGE-M3)以降低延迟和成本,同时保证检索精度。
- 路径深度控制:在检索时,path_depth 决定了遍历图谱的广度。对于深层关系查询,适当增加 depth 有助于发现隐含关联,但会增加计算开销。
- 混合检索权重:当同时使用关键词和向量检索时,可调整两者的权重比例,针对特定查询类型(如事实性查询 vs 语义性查询)动态平衡。
以上就是一个基于非结构化文本的 GraphRAG 的构建过程。借助于如今的大模型,可以更加快速的抽取非结构化文本中的实体与关系以生成知识图谱,并进而结合向量、关键词等技术进行检索与生成,这对于一些涉及复杂实体间关系理解的查询可以很好的提升生成质量并减少幻觉。
GraphRAG 并非万能,它更适合处理具有强关联性的领域知识。对于纯事实性问答,传统向量检索可能更高效;而对于多跳推理问题,GraphRAG 优势明显。开发者应根据具体业务需求选择合适的检索架构。