
PythonAI算法
RAG 评估指南:从检索到生成的 LLM 性能评估方法
RAG 评估涉及检索与生成两个核心环节。检索评估关注召回率、准确率等指标,生成评估则涵盖基于参考(如 BLEU、ROUGE)和无参考(如语义相似度、事实一致性)的多种方法。LLM 作为评估器提供了可扩展性,而代码生成需关注功能正确性与语法规范。选择合适的评估框架(如 RAGAS)结合具体业务场景,能有效优化系统性能并保障输出质量。
发布于 2025/2/771 浏览0 点赞

博客作者
自由如风
353
已发布文章
11K
博客获赞
805K
博客浏览
第 17 页
RAG 评估涉及检索与生成两个核心环节。检索评估关注召回率、准确率等指标,生成评估则涵盖基于参考(如 BLEU、ROUGE)和无参考(如语义相似度、事实一致性)的多种方法。LLM 作为评估器提供了可扩展性,而代码生成需关注功能正确性与语法规范。选择合适的评估框架(如 RAGAS)结合具体业务场景,能有效优化系统性能并保障输出质量。

针对 DeepSeek 官方服务拥堵问题,通过微软 Azure、英伟达 NIM、AWS Bedrock 等第三方平台接入 DeepSeek-R1 模型的多种方案。内容涵盖各平台注册流程、API 调用方法及 Python 代码示例,帮助用户在官方服务不稳定时快速找到替代路径,实现低成本、高效的模型体验。

详细阐述了大语言模型(LLM)的入门路径,涵盖 Python 编程、线性代数与微积分等数学基础,以及 PyTorch 框架下的代码实战。内容深入解析了 Transformer 架构的核心机制,包括自注意力与位置编码,并系统介绍了提示工程、RAG 检索增强、参数高效微调及模型部署优化等进阶技术。文章旨在帮助初学者建立完整的技术认知体系,从理论到实践全面掌握 L…

本书《AI 大模型项目实战:多领域智能应用开发》面向大语言模型应用的使用者和开发者。全书共 18 章,分为基础篇、操作篇和开发篇。基础篇讲解大语言模型基础知识、应用架构及工作模式;操作篇涵盖环境搭建、模型安装微调与量化、多模态模型应用;开发篇详细讲述 Chat、编程、RAG、翻译、AI Agent、语音、数字人等 9 个领域的开发过程,包含源代码与运行方法。…

深入探讨了 LangChain 框架及其在构建智能 Agent 中的应用。通过类比乐高积木,我们理解了 LangChain 如何将复杂的 LLM 应用解构为可复用的模块。在实际案例中,展示了如何利用 LangChain 构建人脸识别问题的智能排查助手,通过定义工具、配置 Agent 和执行链式调用,实现了自动化诊断。此外,分析了智能体技术的发展趋势,包括工具…

如何使用 LangChain 构建智能代理。通过结合语言模型的工具调用能力,代理可以执行搜索、检索本地知识库及自定义函数等操作。教程涵盖了环境安装、工具定义(如 Tavily 搜索和 FAISS 向量检索)、LLM 绑定、代理创建、流式响应处理以及基于检查点的内存持久化。最终实现了一个能够自主决策并记忆上下文的多工具交互系统。

深入解析了大模型(Large Model/Foundation Model)的核心概念、技术原理及发展趋势。文章首先定义了大模型及其与小模型的区别,重点阐述了涌现能力、巨大规模和泛化性能等特点。接着详细介绍了基于Transformer架构的大模型基本原理,包括Encoder-Decoder、Encoder-Only和Decoder-Only三种主流框架。在训…

详细阐述了 AI Agent 框架中 Runtime 模块的核心设计与实现方案。内容涵盖 Workflow 与 Multi-agent 的典型场景分析,提出了基于 Service、Plan、Context 和 Scheduler 的四层架构模型。重点介绍了 Rust 语言下的 Trait 抽象、异步执行流程、JSON 序列化封装以及异常处理与性能优化策略。此…

详细讲解如何从零开始预训练一个大语言模型,涵盖环境配置、数据清洗、分词器训练、模型训练及推理测试全流程。通过基于《三国演义》文本的实战案例,演示如何使用 Python 生态中的 Transformers 和 Tokenizers 库构建自定义模型,帮助开发者深入理解大模型底层原理与训练细节。内容包括依赖安装、BPE 分词器构建、GPT2 架构模型训练循环编写…

详细解析了 AI 产品经理与通用型产品经理的异同,明确了两者在思考框架上的共性以及在技术思维上的差异。文章阐述了 AI 产品经理所需的核心技能,包括对 AI 应用场景、算法原理、数据质量及评价指标的理解。提供了从全局认知、Python 基础、机器学习理论到大模型应用开发的完整学习路径,并给出了新晋从业者在提问、实践、倾听及轮岗方面的具体建议。最后总结了大模型…

大文本分块是构建 LLM 应用的关键步骤,旨在将长文档分解为语义连贯的片段以优化向量检索效果。详细阐述了分块的核心原理,对比了固定大小、递归、语义等多种分块方法的优缺点及适用场景。通过介绍基于 LangChain 的代码实现示例,指导开发者根据内容性质、嵌入模型特性及查询复杂度选择合适的分块策略。此外,文章还探讨了如何评估不同块大小的性能,并提供了预处理数据…

探讨了大模型训练中流水线并行(PP)的性能评价指标与分析方法。核心指标包括端到端耗时、正反向耗时及 Bubble Ratio(气泡率)。文章详细解析了 Native、GPipe、1F1B、PipeDream 及 Virtual Pipe 五种主流算法的优缺点,指出 1F1B 在显存与效率间的平衡优势。同时强调了张量并行(TP)与流水并行(PP)的配置原则,建…

Reflexion 框架通过引入自我反思机制改进 LLM Agent 的推理能力。文章分析了 ReactReflectAgent 的工作流程,包括 Prompt 设计、迭代逻辑及反思策略实现。重点探讨了如何在 ReAct 基础上增加记忆层防止循环推理,并讨论了 is_correct() 判断在不同任务场景下的适用性。此外,还补充了工程化落地中的 Token…

大型语言模型(LLM)的基本概念及其在自然语言处理中的应用。详细阐述了基于魔搭社区平台的开发环境搭建方法,并通过情感分析案例演示了模型推理的具体代码实现。文章进一步探讨了预训练模型的局限性,提出了微调(Fine-tuning)的必要性及标准流程,包括数据准备、LoRA 适配及评估部署。最后分析了端侧模型、多模态融合等技术趋势,以及 LLM 对开发者工作模式和…

本书通过问答与图解形式,梳理自然语言处理技术发展脉络,涵盖从 N-Gram、Word2Vec 到 Transformer 及 GPT 的核心原理。作者黄佳结合实战项目,指导读者从零搭建语言模型,适合初学者及从业者深入理解大模型构建逻辑与技术细节。

Python 集合与字典是两种重要的内置数据结构。集合用于存储无序且唯一的元素,支持去重及数学集合运算;字典用于存储键值对,通过键快速查找值,适用于配置管理或对象映射。详细讲解了它们的创建方式、常用操作方法(增删改查)、遍历技巧以及性能特点,帮助开发者高效利用这两种结构处理数据。

系统介绍大模型技术的核心概念、学习路径及实战方法。涵盖 Transformer 架构原理、预训练与微调策略、分布式训练方案(如 DeepSpeed)、指令数据构建及行业应用开发。内容包含从数学基础到 LangChain 框架应用的全栈知识,旨在帮助读者掌握大模型全链路开发能力,提升在人工智能领域的竞争力。
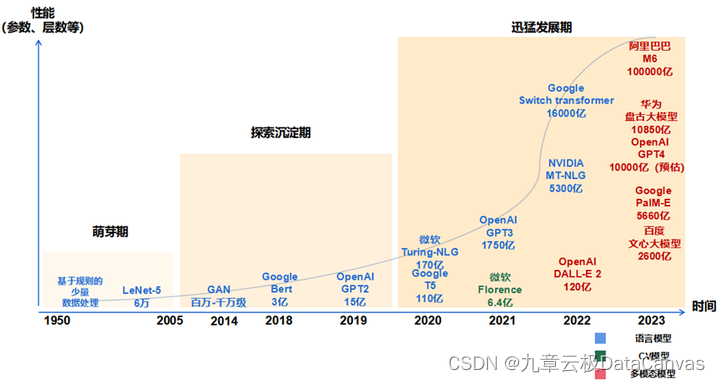
大模型是具有大规模参数和复杂计算结构的机器学习模型。文章阐述了其与小模型的区别,梳理了从 CNN 到 Transformer 再到预训练大模型的发展历程。介绍了语言、视觉及多模态大模型的分类,以及通用、行业、垂直大模型的层级。重点解析了泛化能力与微调技术,包括全量微调与参数高效微调(PEFT),为理解人工智能核心技术提供基础参考。

网络安全入门所需的核心工具安装流程,涵盖 Kali Linux 虚拟机部署、phpStudy 本地环境搭建、Pikachu 漏洞靶场配置以及 BurpSuite 抓包工具的 JDK 环境设置与激活步骤,旨在帮助初学者快速构建安全的渗透测试学习环境。内容包含具体的参数配置、常见问题排查及操作注意事项,适合零基础用户参考。

渗透测试是通过模拟攻击评估系统安全性的方法。涵盖渗透测试标准流程、常用工具(如 Nmap、Burp Suite)、接口与前后端测试方法,以及 SQL 注入、XSS、CSRF、SSRF 等常见漏洞的原理、实例与修复方案。内容包含代码示例、防御最佳实践及伦理规范,旨在帮助技术人员理解安全测试核心概念及应对面试常见问题。