
Stable Diffusion 人物三视图制作教程:三种主流实现方案详解
在角色设计、游戏开发及动画制作中,人物三视图(正面、侧面、背面)是基础且关键的需求。随着生成式 AI 技术的发展,Stable Diffusion (SD) 已成为实现这一需求的高效工具。本文将详细探讨三种主流的三视图制作方法,涵盖提示词工程、LoRA 模型应用以及 ControlNet 姿态控制,帮助创作者根据实际需求选择最佳方案。
一、实现方式一:通过提示词直接生成
这是最基础的方法,完全依赖文本提示词引导模型生成三视图。虽然操作简便,但对模型的语义理解能力要求较高。
1. 提示词格式规范
标准的三视图提示词通常包含视角描述、主体特征及质量修饰词。建议格式如下:
(three views of character:1.2), (three views of the same character in the same outfit:1.2), full body, front view, side view, back view, [主体描述], simple background, white background, masterpiece, best quality
参数说明:
(keyword:1.2):权重提升,确保模型重视该概念。full body:强调全身构图。simple/white background:减少背景干扰,便于后期抠图。
2. 具体配置示例
- 大模型:IP DESIGN | 3D 可爱化模型 V4.0(或类似擅长角色生成的 Checkpoint)
- 正向提示词:
1girl, blonde hair, long hair, princess peach, blue eyes, lips, eyelashes, earrings, crown, hood, casual - 反向提示词:
nsfw, lowres, bad anatomy, bad hands, text, error, missing fingers, extra digit, fewer digits, cropped, worst quality, low quality, normal quality, jpeg artifacts, signature, watermark, username, blurry, artist name - 采样器:Euler a
- 迭代步数:25
- 图片尺寸:768x512
- CFG Scale:7
3. 效果分析与优化
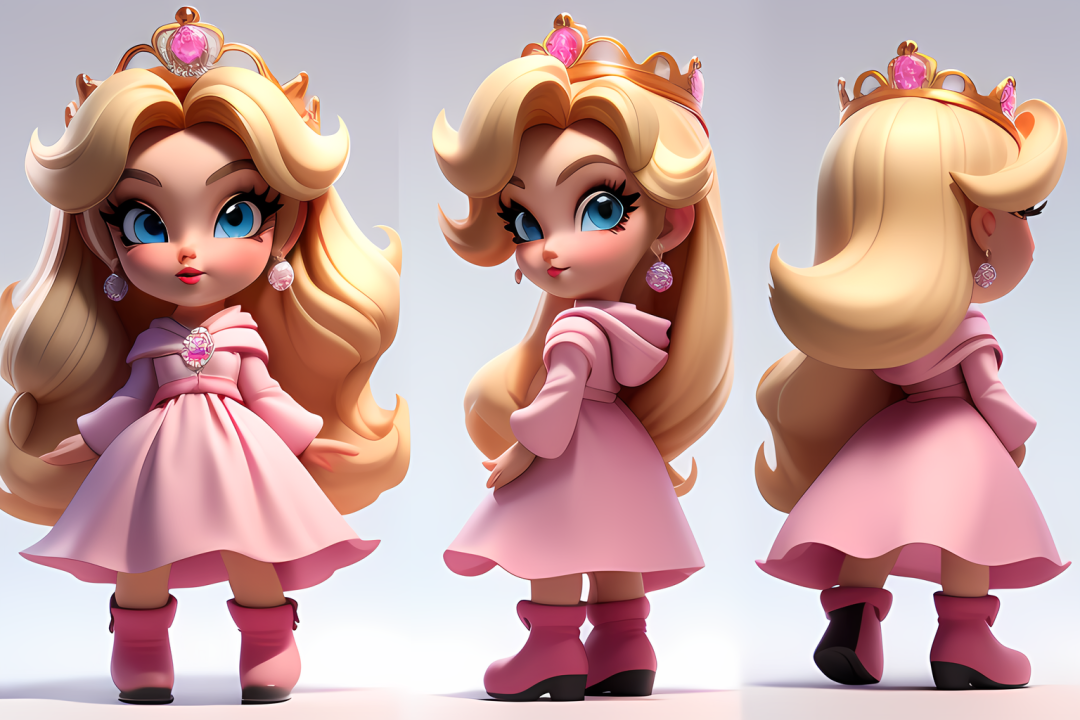
局限性说明:
- 可控性较弱:基于 SD1.5 或 SDXL 的基础模型对'三视图'这一特定构图的准确理解有限,往往需要多次随机生成(抽签)才能找到符合要求的图片。
- 视角偏差:部分模型可能无法同时呈现完美的正侧背三个角度,或者导致服装细节不一致。
- 优化策略:如果某个视图缺失,可适当提高该视图关键词的权重,例如将
side view调整为(side view:1.3)。
二、实现方式二:借助三视图 LoRA 模型
为了弥补基础模型在三视图生成上的不足,社区开发了专门的 LoRA 模型。这类模型经过特定数据集微调,能显著降低生成难度。
1. 资源获取与选择
在各大模型社区平台搜索关键词'三视图',可以找到多种风格的 LoRA。推荐使用使用量较大且维护良好的模型,例如支持 SDXL 和 SD1.5 双版本的通用型三视图 LoRA。
- 推荐模型:mw_3d 角色 ip 三视图 q 版
- 版本说明:
- V2.0.1:基于 SDXL 1.0 底模,对动物及复杂生物支持更好。
- V1.1:基于 SD1.5 底模,兼容性更强,推理速度更快。
2. 配置示例(以 SDXL 为例)
- 大模型:SDXL_1.0
- 触发词:
mw_sanshitu,three view,full body - 正向提示词:
mw_sanshitu, full body, mermaid, simple background, standing, lora:mw_3d 角色 ip 三视图 q 版_2.0.1:0.9 - 反向提示词:
easynegative, dark, bad hands, bad feet, worst quality, low quality, normal quality, bad artist, bad anatomy, blurry - 采样器:Euler a
- 迭代步数:25
- 图片尺寸:1024x768
- CFG Scale:7
3. 视角控制技巧
虽然 LoRA 提升了成功率,但视角仍可能随机。建议在提示词中显式加入视角关键词:
mw_sanshitu, full body, front view, side view, back view, mermaid, simple background, standing
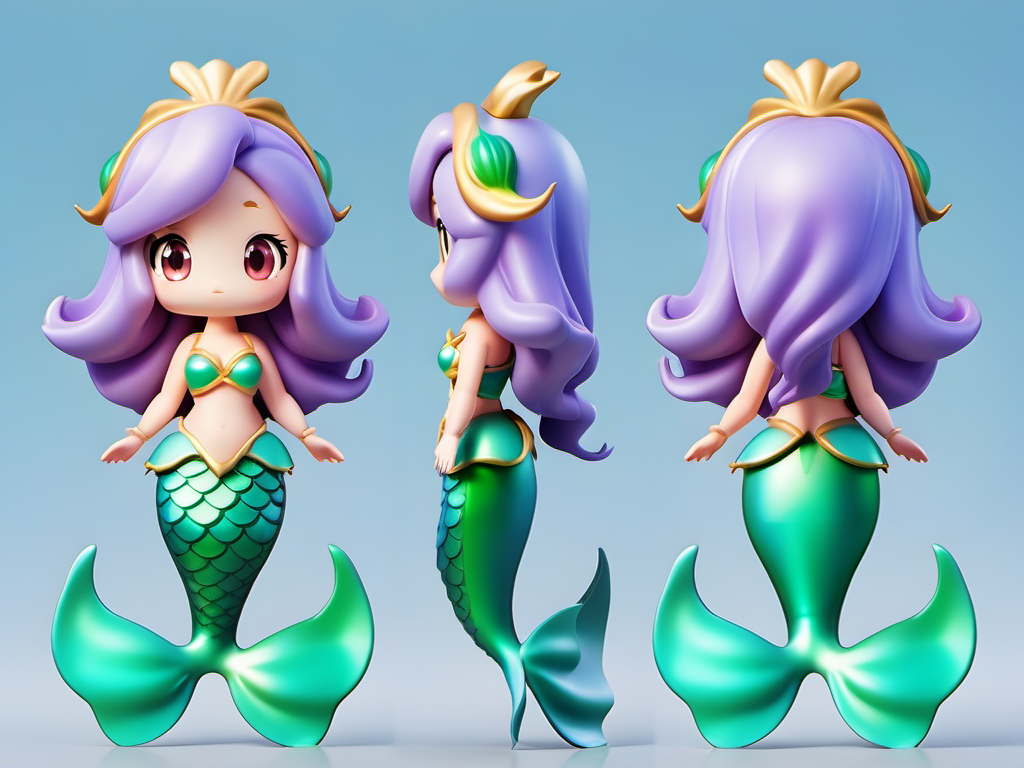
优缺点总结:
- 优点:生成速度快,三视图结构稳定,无需大量抽签。
- 缺点:主体姿势控制依然受限,若需特定动作(如奔跑、跳跃),仍需配合其他工具。
三、实现方式三:使用 ControlNet OpenPose 模型
这是目前可控性最强的方法。通过 ControlNet 插件加载 OpenPose 预处理器,可以精确指定人物的骨架姿态,从而强制模型生成指定视角的三视图。
1. 准备工作:特征图片制作
首先需要一张包含正、侧、背三个视角的人物骨架图或参考图。可以通过以下方式获取:
- 在模型库寻找现成的三视图真人照片。
- 使用绘图软件绘制简易骨架图。
- 利用 ControlNet 的 Openpose 预处理器提取现有图片的姿态信息。
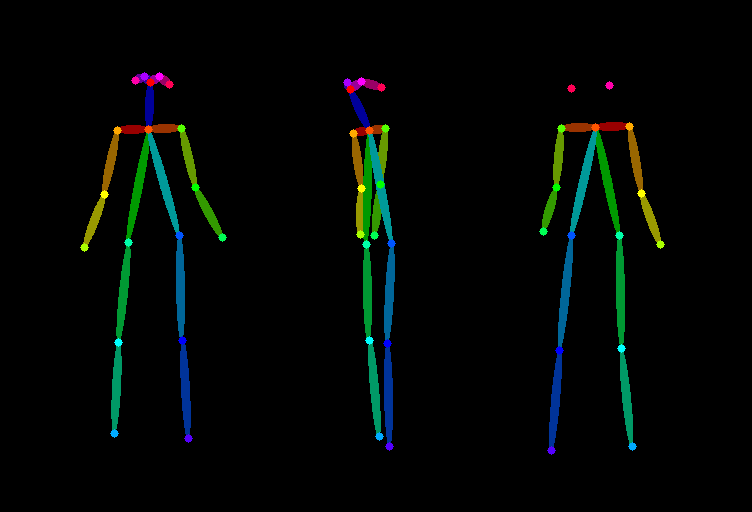
2. 详细操作步骤
第一步:大模型与参数设置
- 大模型:AWPortaint V1.4(或其他写实风格模型)
- 正向提示词:
(three views of character:1.2), (three views of the same character in the same outfit:1.2), 1girl, long hair, wear school uniform, a proud and confident smile expression, studio fashion portrait, studio light, pure white background - 反向提示词:
ng_deepnegative_v1_75t, (badhandv4:1.2), (worst quality:2), (low quality:2), (normal quality:2), lowres, bad anatomy, bad hands, ((monochrome)), ((grayscale)) watermark, moles, large breast, big breast - 采样器:DPM++ 2M Karras
- 迭代步数:30
- 图片尺寸:768x512
- 高分辨率修复:放大算法 Lanczos,重绘幅度 0.4,重绘采样步数 30
- Adetailer 插件:脸部模型 face_yolov8n
第二步:ControlNet 设置
启用 ControlNet 单元,配置如下:
- 控制类型:OpenPose(姿态)
- 预处理器:none(因为已上传三视图特征图,无需再次预处理)
- 模型:control_v11p_sd15_openpose
- 权重:1.0
- 结束步数:1.0
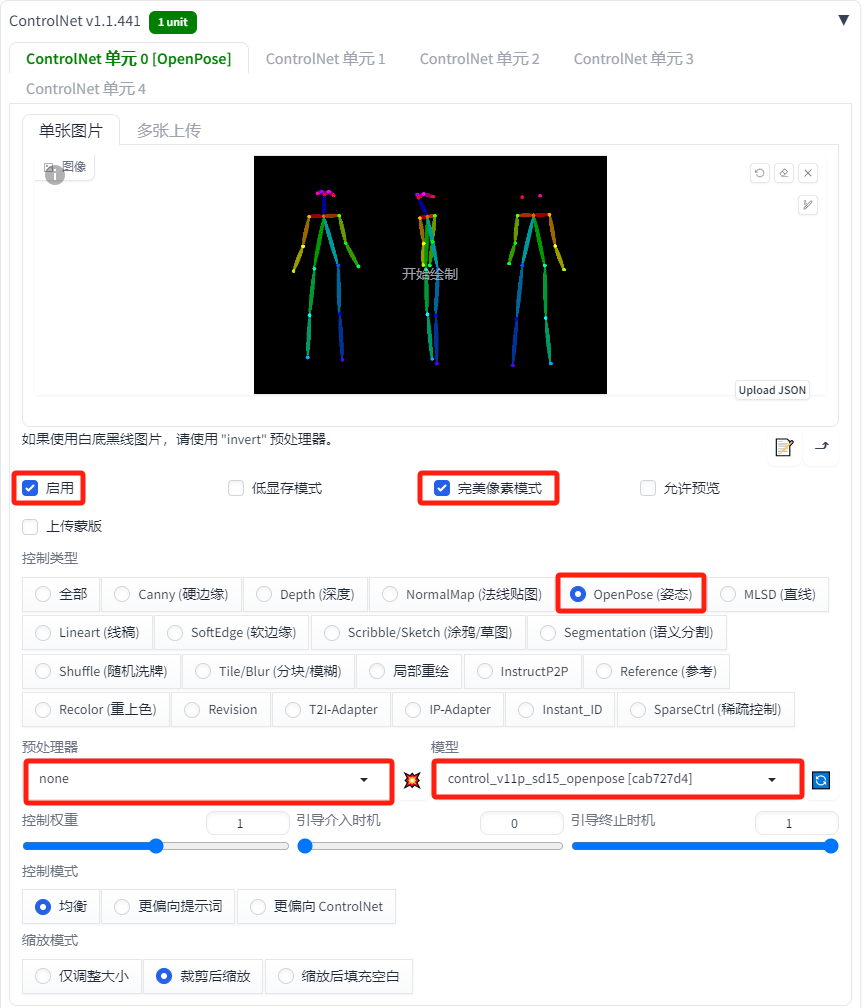
第三步:生成与调整
点击生成后,模型将严格遵循骨架图的姿态分布。若发现细节失真,可调整重绘幅度(Denoising strength)或尝试更换不同的 OpenPose 模型版本。
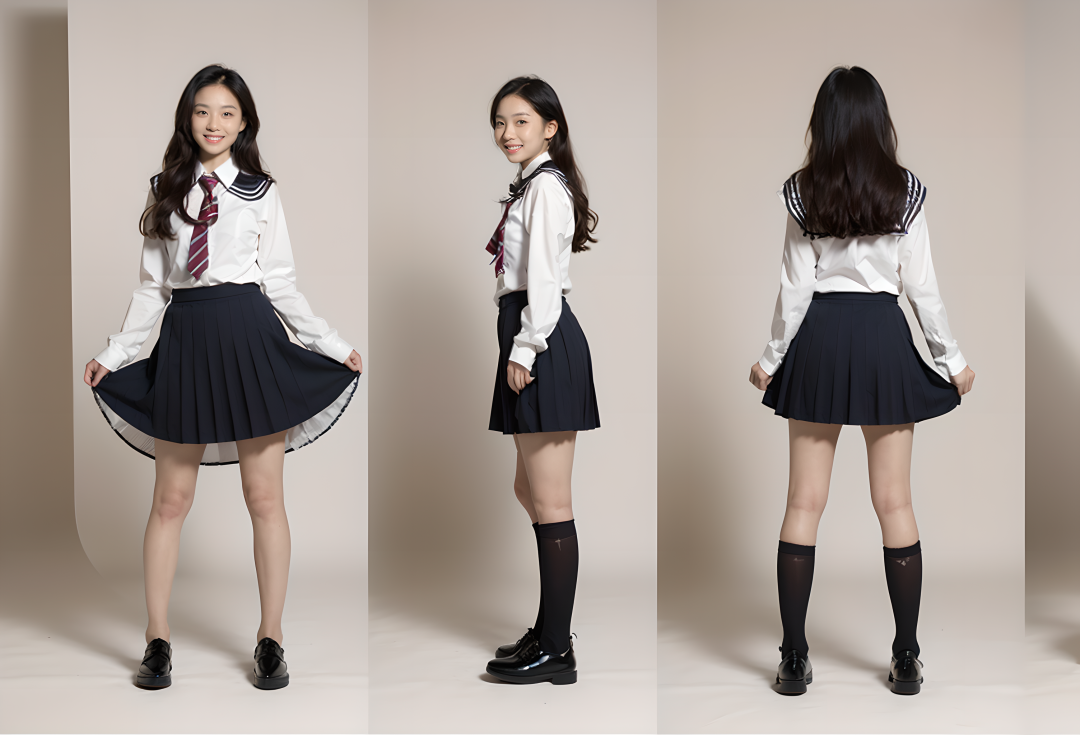
3. 优势分析
- 稳定性极高:每次生成均能保证三视图结构完整,无需反复抽签。
- 扩展性强:不仅限于三视图,可生成任意视角组合(如四分之三侧面 + 背面)。
- 姿势精准:适合需要特定动作设计的场景。
四、方案对比与选择指南
| 特性 | 提示词法 | LoRA 模型法 | ControlNet 法 |
|---|---|---|---|
| 操作难度 | 低 | 中 | 高 |
| 生成速度 | 快 | 快 | 中 |
| 姿势可控性 | 差 | 中 | 优 |
| 一致性 | 不稳定 | 较稳定 | 非常稳定 |
| 适用场景 | 快速原型、风格探索 | 批量生产、固定风格 | 商业交付、精准设计 |
五、常见问题与解决方案
1. 三视图中某一面模糊或缺失
- 原因:提示词权重不足或模型理解偏差。
- 解决:增加该视角关键词权重,或使用 ControlNet 强制指定骨架。
2. 服装在不同视图中不一致
- 原因:SD 模型在处理多视角时容易产生幻觉。
- 解决:使用 IP-Adapter 保持角色特征,或在 Inpaint 区域进行局部重绘修正。
3. 手部细节崩坏
- 原因:三视图导致手部位置复杂,易被遮挡。
- 解决:开启 Adetailer 插件,专门针对手部进行修复;或在反向提示词中加入
bad hands。
六、结语
Stable Diffusion 在人物三视图生成方面已经具备了相当高的实用性。提示词法适合初学者快速体验,LoRA 法适合追求效率的日常创作,而 ControlNet 法则适合对精度有严格要求的专业工作流。在实际应用中,建议结合多种方法,例如先用 ControlNet 确定骨架,再用 LoRA 增强风格,最后通过高清修复完善细节。随着 AIGC 技术的持续演进,未来在角色资产自动化生产领域将有更广阔的应用前景。