
Javajava算法
实战:Protobuf 对象序列化在多模块依赖中的反序列化陷阱
Protobuf 序列化在多模块微服务架构中易因类定义缺失导致反序列化为 HashMap。基于 Dubbo 与 Redis 场景,分析对象存储时类型丢失的根本原因,即反序列化端缺少对应的 proto 类或编译产物,最终通过完善 Maven 依赖关系确保类型可见性来解决该问题。
Protobuf 序列化在多模块微服务架构中易因类定义缺失导致反序列化为 HashMap。基于 Dubbo 与 Redis 场景,分析对象存储时类型丢失的根本原因,即反序列化端缺少对应的 proto 类或编译产物,最终通过完善 Maven 依赖关系确保类型可见性来解决该问题。
介绍基于逻辑回归模型的银行个人贷款违约风险预测系统。针对人工审核效率低、主观性强及漏判率高的问题,构建自动化评估流程。通过清洗多源数据(信贷申请、征信、社保等),进行特征工程(还款能力、意愿、稳定性),使用 SMOTE 处理类别不平衡。模型训练采用 Scikit-learn,评估指标包括 AUC-ROC 与 KS 值。最终通过 Flask 提供 API 服务,实现从申请到风险评级的全流程自动化,旨在降低违约损失并提升审核效率。
海南超级 AI 医院依托自贸港政策于 2025 年获批互联网医院资质,采用虚拟与实体服务孪生模式,整合悦尔 AI、清华大学及微医等资源构建国际医疗协作网络。项目旨在打破跨境医疗壁垒,推动疾病防治从被动治疗向主动防御转变,同时面临数据合规、临床验证及商业模式可持续性等挑战,未来将深化技术体系与合规监管探索。
综述由AI生成Prompt 提示词管理是大模型应用的核心环节,涉及版本控制、上下文整合及成本监控。探讨了提示词的构成要素如指令与输入数据,介绍了 Humanloop 和 Langfuse 等管理工具,并强调了模块化设计与持续评估的重要性,旨在帮助开发者构建高效稳定的大模型交互系统。
介绍如何在 SpringBoot 微服务中集成 Stable-Diffusion-3.5 图像生成能力。通过 RESTful API 实现通信,使用 WebClient 进行异步调用,结合异步任务处理、连接池优化及负载均衡策略提升性能。内容涵盖环境搭建、架构设计、配置管理、异常处理、健康检查及监控指标部署,提供完整的代码示例与最佳实践建议,帮助开发者构建高可用的 AI 图像生成服务。
综述由AI生成这篇内容围绕二叉树上的 DFS、回溯和剪枝展开,先把 BFS、DFS、暴搜和回溯的关系讲清楚,再用 6 道 LeetCode 题串起常见写法:后序遍历做布尔树求值和剪枝,中序遍历验证 BST、找第 K 小元素,递归累加处理根到叶数字之和与所有路径。整体思路是把树题拆成'遍历顺序 + 递归出口 + 是否需要剪枝'三件事,代码实现都保持了典型模板,但更强调按题意选择遍历方式。
综述由AI生成红黑树是一种自平衡二叉搜索树,通过颜色标记和旋转操作保证最长路径不超过最短路径的两倍。详细讲解了红黑树的五条规则、插入算法的三种调整情况(变色、单旋、双旋)以及验证方法。相较于 AVL 树,红黑树在插入删除时旋转次数更少,更适合频繁变动的数据场景。文中提供了完整的 C++ 实现代码,涵盖节点结构、查找、插入及平衡性校验逻辑,适合希望深入理解平衡树机制的开发者阅读。
二分查找算法利用数据二段性将时间复杂度优化至对数级别。示例涵盖整数平方根计算与山脉数组峰顶索引,演示非朴素模板的应用。平方根问题需注意 long long 防溢出,山脉数组问题通过比较中间元素与前驱元素确定方向。代码采用 C++ 实现,展示边界条件处理与循环逻辑。
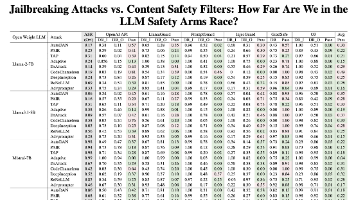
综述由AI生成该论文探讨了大语言模型(LLM)安全领域的对抗性攻防现状。文章重点分析了针对内容安全过滤器的越狱攻击(Jailbreaking Attacks),并评估了当前防御技术与攻击手段之间的差距。通过对比现有安全机制与新型攻击策略,揭示了 LLM 安全面临的主要挑战及未来发展方向。
综述由AI生成从单值二叉搜索树到键值对二叉搜索树的演进,通过停车场车牌识别与计费系统的案例,解释了 Key 搜索与 Key/Value 搜索的区别。文中提供了 C++ 模板实现的 BST 节点类及插入、查找功能源码,阐述了关联容器底层数据结构的基础原理。
介绍基于树的集成学习方法及大规模在线学习算法。涵盖随机森林、极端随机树和旋转森林的原理与实现,重点讲解如何使用 scikit-learn 构建模型、调参及特征重要性分析。随后深入在线学习场景,演示感知机算法、随机梯度下降在回归与分类任务中的应用,包括正则化处理及流数据模拟。适合希望掌握集成策略与大规模数据处理的技术人员。
综述由AI生成CPU 的局部性原理是计算机体系结构的核心思想,分为时间局部性和空间局部性。时间局部性指近期访问的数据可能再次被访问,空间局部性指访问某地址后可能访问邻近地址。CPU 利用这一原理通过缓存(Cache)机制减少内存访问延迟。文章通过行优先与列优先遍历的代码对比,展示了内存访问模式对缓存命中率及程序性能的显著影响。理解局部性有助于进行代码层面的性能优化,如循环优化、数据结构布局调整等。
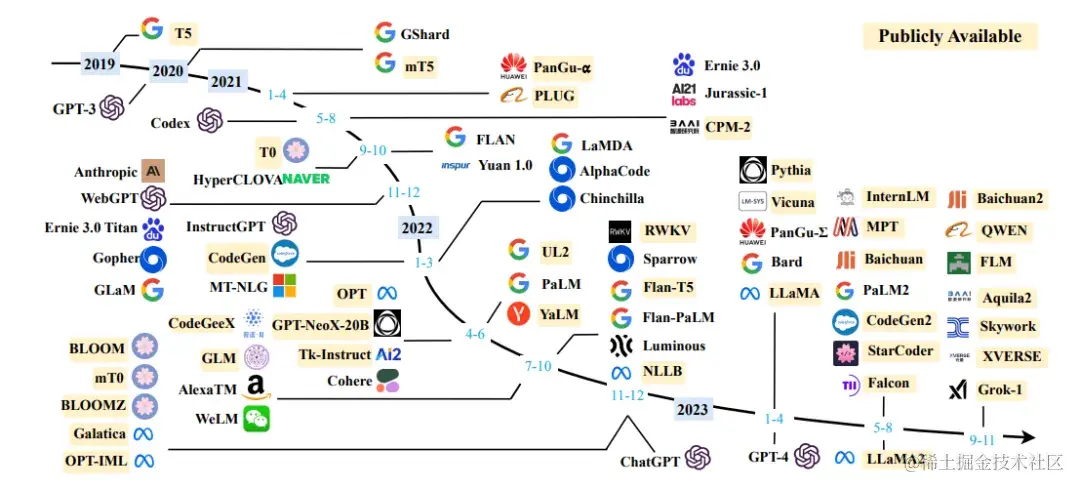
综述由AI生成中国人民大学团队发布的《A Survey of Large Language Models》综述论文在业界引起广泛关注,随后推出了中文书籍。该书共 391 页,涵盖大模型基础、预训练、微调、提示词工程、智能体及应用等五大板块。适合具备深度学习基础的高年级本科生和研究生阅读。书中包含 LLaMA 系列进化图、混合专家模型详解及多领域代表性模型介绍。配套提供 LLMBox 工具库及 YuLan 模型资源,旨在为初学者提供全面的技术框架指引。…
datastream.io 是一个基于 Python 的开源框架,专为实时异常检测设计。它支持从多种数据源消费流数据,通过无监督机器学习建立行为基线,并实时评分新事件。可视化方面提供轻量级仪表板或对接 Elasticsearch 与 Kibana。安装推荐使用虚拟环境配合 pip 进行,既可通过命令行操作,也能嵌入 Python 代码或 Jupyter 笔记本中灵活调用。
双指针算法包含对撞指针与快慢指针两种模式,常用于数组或链表处理。针对移动零问题,利用快慢指针将非零元素前置并补零;针对复写零问题,先计算有效长度后倒序遍历填充。示例提供 C++ 原地操作方案,确保空间复杂度为 O(1),避免额外数组分配。
深入探讨决策树与随机森林的核心原理及实现细节。涵盖基尼不纯度与信息熵等分裂准则,通过从零构建简易决策树代码解析递归逻辑。对比单棵树与集成模型的过拟合风险,介绍 Bagging 机制与特征重要性评估。结合 scikit-learn 实战演示建模流程,并辩证分析模型可解释性的局限,引入 SHAP 工具辅助解读黑箱预测。总结线性模型与树模型的适用场景,为后续梯度提升树学习奠定基础。
综述由AI生成Python 属性描述符是控制属性访问的核心机制,解决了 property 在多字段场景下的代码冗余问题。文章深入解析了数据描述符与非数据描述符的定义及优先级差异,梳理了从 __getattribute__ 到实例属性的完整查找流程。结合 ORM 框架案例,展示了如何利用描述符实现字段校验与数据库映射,帮助开发者掌握 Python 面向对象编程的底层原理。
好莱坞演员罢工期间,Netflix 开出 90 万美元年薪招聘 AI 产品经理,显示流媒体巨头正将 AI 深度整合至内容创作领域。生成式 AI 技术虽能大幅降低制作成本与时间,但也引发演员、编剧对数字肖像权及工作被取代的担忧。迪士尼等公司面临知识产权管理挑战,行业正处于效率提升与伦理规范的博弈阶段。未来几年,AI 将重塑电影制作流程,创作者需掌握新工具以应对变革。
Spring AI 是 Spring 生态中集成大模型能力的框架。涵盖环境搭建、DeepSeek 集成、ChatClient 与 ChatModel 使用、函数调用、Ollama 本地部署、阿里云 DashScope 接入,以及图像、语音模型和 RAG 检索增强生成的实战示例。通过具体代码演示,帮助开发者快速掌握在 Java 应用中构建 AI 功能的方法。
综述由AI生成利用 Rust 语言的高性能特性结合 PostgreSQL Wire Protocol 构建数据库代理层,集成 DeepSeek 大模型实现自然语言到 SQL 的转换。项目通过 Tokio 运行时处理高并发,支持无缝接入现有客户端。配置管理采用 TOML 格式,核心模块涵盖配置加载、数据库交互及大模型集成。测试验证了自然语言查询的准确性与系统稳定性,为数据中台建设提供参考。