
PythonAI算法
机器学习常见名词与核心概念汇总
综述由AI生成机器学习作为人工智能的核心分支,涵盖从数据驱动到模式识别的多种技术。文章梳理了机器学习与深度学习的区别,详解神经网络结构、NPU 及 CUDA 等硬件加速原理。重点解析了 PyTorch 框架特性、FT 与 SFT 微调流程,以及超参数调优中的激活函数、权重偏置等关键概念。内容还涉及梯度下降、过拟合处理及模型量化技术,为理解大模型训练提供基础术语参考。
综述由AI生成机器学习作为人工智能的核心分支,涵盖从数据驱动到模式识别的多种技术。文章梳理了机器学习与深度学习的区别,详解神经网络结构、NPU 及 CUDA 等硬件加速原理。重点解析了 PyTorch 框架特性、FT 与 SFT 微调流程,以及超参数调优中的激活函数、权重偏置等关键概念。内容还涉及梯度下降、过拟合处理及模型量化技术,为理解大模型训练提供基础术语参考。
综述由AI生成Biopython 是 Python 生态中用于生物信息学分析的工具包,支持多种序列格式读写。文章详解了 FASTA 和 GenBank 文件的结构解析方法,包括提取基因特征、CDS 编码区及物种注释。通过 SeqIO 模块实现批量读取、质量评估及自动化工作流构建,结合 Trimmomatic、BEDTools 等工具完成从数据预处理到变异检测的完整流程,提升基因数据分析效率。
综述由AI生成通义千问 Qwen2.5 模型支持多种部署方式,包括本地推理与云端 API。了基于 Python 的集成流程,涵盖环境搭建、模型加载(Transformers)、流式生成、API 调用(DashScope/OpenAI 兼容)及函数调用能力。内容包含 vLLM 部署优化、参数配置详解及常见错误处理方案,适合开发者快速上手应用。
综述由AI生成测试了腾讯 HunyuanOCR 模型与 UiPath、影刀 RPA 的集成方案。通过 Python 脚本调用本地部署的 OCR API,实现屏幕截图文字识别,解决传统 RPA 无法处理非结构化视觉数据的问题。文章详细阐述了架构设计、代码示例、发票录入场景及部署建议,强调内网部署的安全性与成本优势。
综述由AI生成解读 LLaMA 论文,介绍了首个完全开源且性能媲美闭源的大语言模型系列。研究使用 1.4 万亿 tokens 的纯开源数据训练了 7B 至 65B 参数的模型。架构上采用了 RMSNorm 预归一化、SwiGLU 激活函数及 RoPE 位置编码等优化,成为后续大模型设计的标配。实验表明,13B 模型性能优于 GPT-3,65B 模型达到当时最佳水平。文章还涵盖了分词器选择、优化器配置、高效实现细节及指令微调效果。
综述由AI生成DALL·E 3 是 OpenAI 推出的图像生成模型,具备强大的文本理解能力。其默认分辨率、WebP 格式优势及高分辨率选项。解析了基于 GANs 的生成机制,包括生成器与判别器的对抗训练。探讨了多图生成功能及其在创意、营销和教学中的应用。详细说明了编辑器界面的操作技巧,如区域选择、元素添加与移除。最后阐述了 DALL·E API 的获取步骤、功能概览、应用场景及最佳实践,帮助用户提升创意设计与生产力。
对 AMD 显卡在 llama.cpp 部署中遇到的 Vulkan 兼容性问题提供解决方案。涵盖启动崩溃、性能异常等症状识别,通过环境信息收集、驱动版本验证及日志分析定位问题。提供驱动升级、编译参数定制、后端切换等五种修复策略,并包含性能基准测试与稳定性压力测试方法。旨在帮助用户优化显存管理、着色器编译及系统监控,确保推理任务稳定运行。
如何在本地电脑通过 Ollama 工具部署并运行 Meta 的 Llama-3.2-3B 大语言模型。流程包括安装 Ollama、拉取模型文件、启动交互对话以及通过 API 调用。该方案无需复杂配置,适合个人学习、日常文字辅助及离线环境使用,对硬件要求较低,普通电脑即可运行。
综述由AI生成介绍 ClawdBot 插件开发,旨在为 Telegram 机器人扩展功能。ClawdBot 是基于 vLLM 的本地 AI 网关平台,支持模块化插件机制。文章通过编写 /summary 文本摘要插件为例,演示了从目录结构创建、核心逻辑编写、配置文件声明到加载验证的全过程。进阶部分涵盖多模态输入支持、限流缓存机制以及与 MoltBot 联动。最后介绍了 Web 控制台调试、文档编写及 Docker 打包发布方法。通过插件化开发,开发者可…
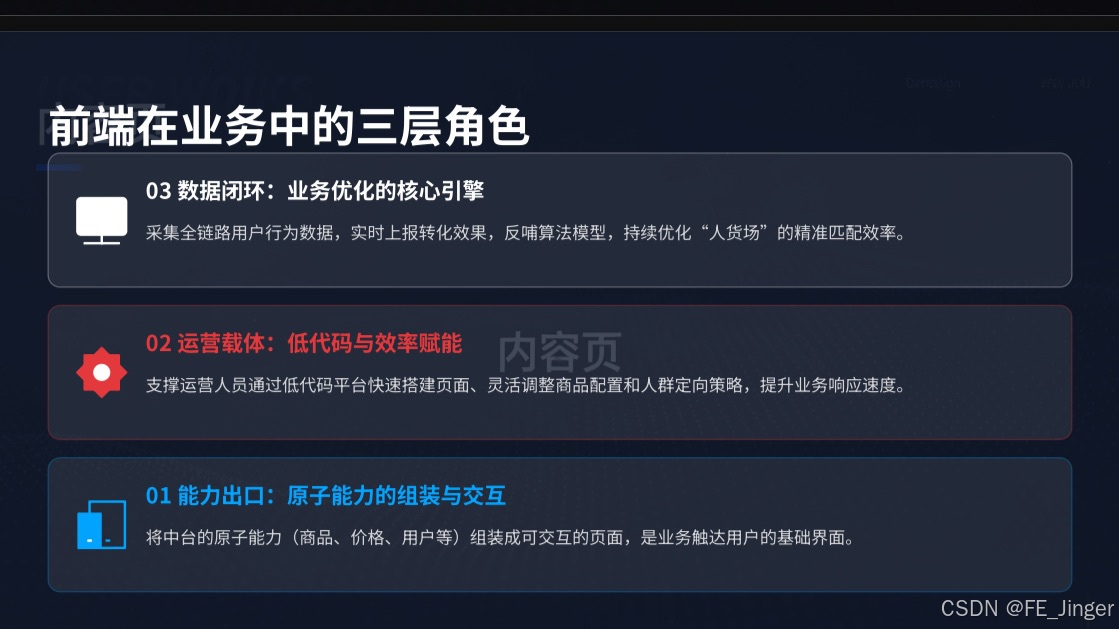
系统拆解京东营销前端的业务角色与技术架构。业务上,前端作为中台能力出口与运营载体,需整合人货场资源,支撑全链路营销场景。技术上,采用大中台小前台架构,通过微前端、低代码搭建、多端统一及高可用保障体系,实现快速迭代与性能优化。未来将结合 AIGC 走向智能化,成为营销决策的智能中枢。
LLaMA Factory 提供高效的大语言模型训练与微调解决方案。内容涵盖 CUDA 环境配置、依赖安装、数据集格式构建(Alpaca、ShareGPT 等)。教程详解 SFT 训练方法、LoRA 合并与量化技术,以及 WebUI 操作流程。同时包含推理配置、批量推理及模型评估方案,支持多种模型架构与优化算法,助力用户快速完成本地模型的微调与部署。
QGIS Python 编程涉及环境配置、自动化工作流、矢量与栅格数据处理、插件开发及调试技巧。内容涵盖 PyQGIS API 基础操作,包括数据加载、空间查询、几何编辑、投影转换、地图绘制及独立应用程序构建,通过代码示例展示地理空间任务的自动化实现方法。
综述由AI生成一种结合 AIGC 与 Adobe Photoshop 的 Spine 2D 角色动画拆件工作流。通过 Midjourney 生成底图,利用 Photoshop 的对象选择工具和创成式填充功能快速分离图层并修复遮挡区域,最后通过官方脚本导入 Spine 2D 进行骨骼绑定。该方法显著减少了传统手工补图和分层的时间成本,适用于二次元风格游戏的角色制作。
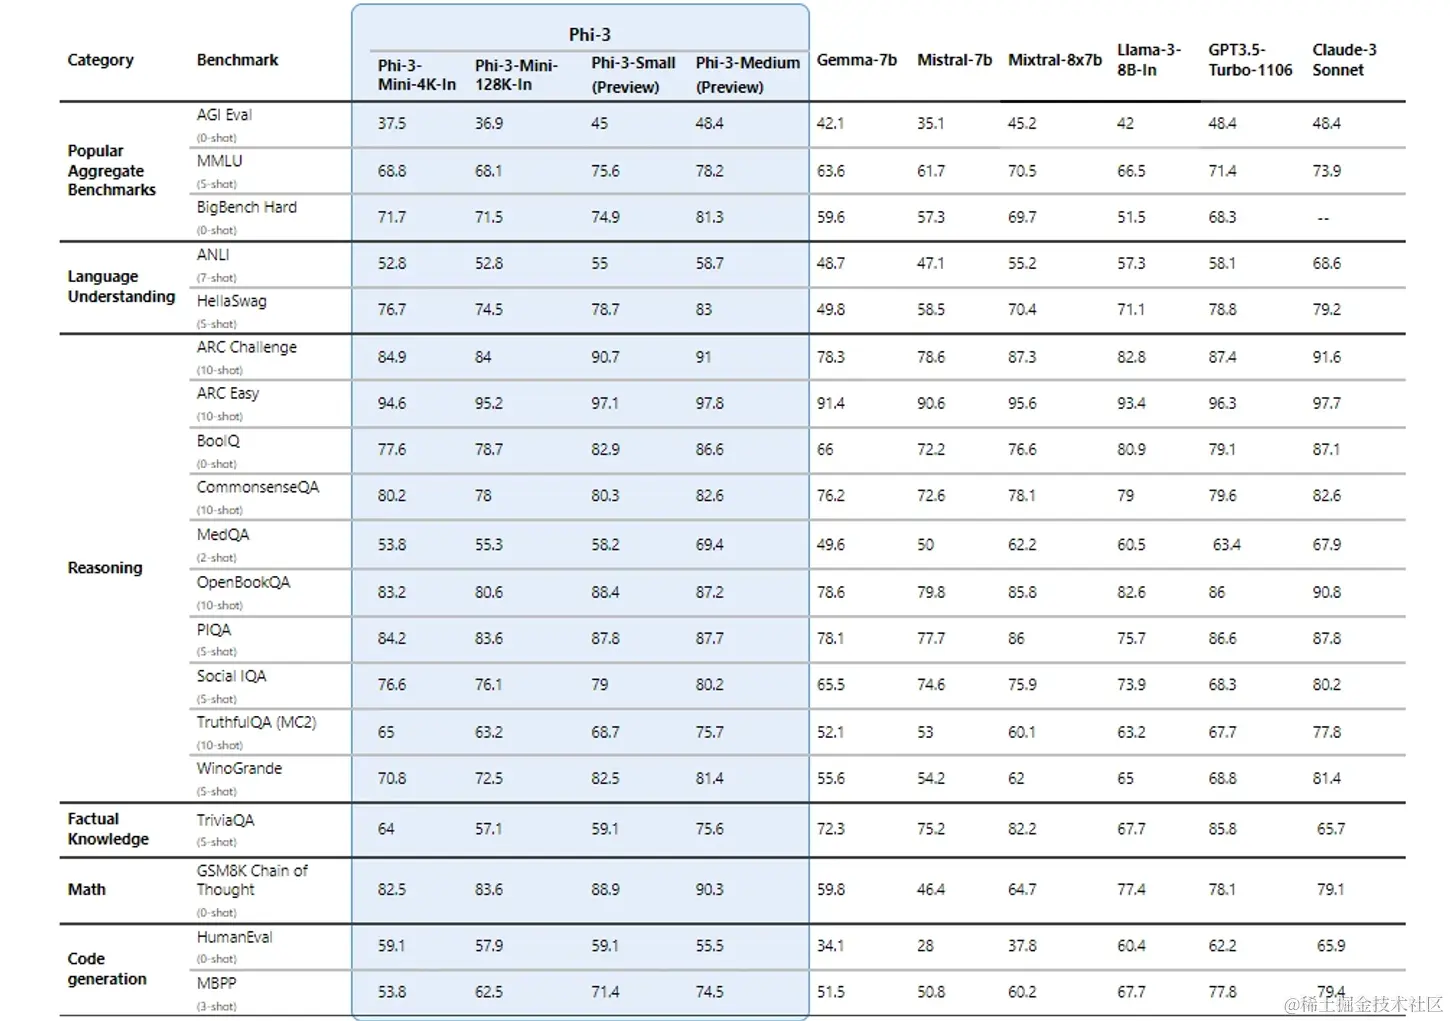
综述由AI生成探讨了小语言模型(SLM)在大型语言模型(LLM)普及背景下的兴起原因及代表产品。分析了微软 Phi-3、苹果 OpenELM 和谷歌 Gemma 系列模型的技术特点与优势,包括参数量优化、上下文长度扩展、架构创新(如分层缩放策略、Griffin 架构)以及在端侧设备上的部署能力。文章对比了不同 SLM 的性能表现,讨论了其在隐私保护、成本控制和低延迟场景下的应用价值,并展望了未来语言模型向更小、更灵活方向发展的趋势。
详细对比 GPT、LLaMA、DeepSeek、Qwen 四大主流大模型架构。内容涵盖 GPT 系列演进、LLaMA 的 RMSNorm 与 SwiGLU 优化、DeepSeek 的 MLA 与 MoE 创新、Qwen 的大词表策略。同时解析 MoE 路由机制、Scaling Laws 规律及 Tokenizer 原理,提供面试高频考点与选型指南,帮助理解设计权衡与工程实践。
通义万相 2.1 模型在 AIGC 领域表现强劲,支持文生图、图生图及视频生成,具备 4K 分辨率与多风格适配能力。实测显示,模型在中文与英文提示词下均能生成高质量图像,但在文化意象理解上存在差异。部署需关注 GPU 显存与算力资源,通过调节扩散步数、引导尺度等参数可优化出图效果。该模型适合广告创意、游戏设计及科研仿真等多场景应用。
2025至2026年初,全球AI行业从规模扩张转向质量跃升。中美大模型性能差距显著缩小,GPT-5.4、Claude Opus 4.6及国产Qwen3.5等旗舰模型能力接近。市场融资活跃,Anthropic估值达3800亿美元。应用端进入规模化生产阶段,AI Agent在多行业落地。商业化成为关键年,面临幻觉、成本及合规挑战。未来趋势指向架构革新、Agent爆发及全球监管框架成型。
综述由AI生成圣女司幼幽-Z-Turbo 是基于 Z-Image-Turbo LoRA 训练的专用角色生成模型。通过 Xinference 推理框架与 Gradio 界面,可快速部署本地 AI 画师工作流。文章详解了环境准备、服务启动验证及 Web 界面操作指南,提供了优化提示词的结构化建议与参数调整技巧。实测表明该方案能高效还原角色特征与光影氛围,适用于同人创作、角色设定可视化等场景,无需复杂配置即可实现高质量图像生成。
综述由AI生成基于 Spring Boot 和 Vue 构建实时对战匹配系统,涵盖 WebSocket 连接管理、JWT 身份验证、并发匹配池设计及 Java 迷宫算法实现。通过前后端协同,实现了从匹配请求到游戏地图生成的完整流程,解决了实时通信中的状态同步与安全问题。
综述由AI生成对 AMD 显卡在 llama.cpp 部署中遇到的 Vulkan 初始化失败、模型加载卡顿等兼容性问题提供解决方案。主要方法包括更新或回退显卡驱动版本以适应不同系列(如 RX 7000/6000/5000),调整编译参数启用 AMD 专用兼容性模式,以及采用 CPU+GPU 混合加速策略。完成修复后需进行推理速度、内存占用及输出质量验证。文章还列举了常见问题排查技巧,旨在帮助用户实现大语言模型在 AMD 硬件上的稳定本地化运行。