
编程语言AI大前端算法
辞职去韩国读研一年半,我决定重返前端
综述由AI生成前端开发三年后辞职赴韩读CS大数据硕士,复盘高密度学习、AI工具融入、博客带来的讲师机会等经历。GPA 4.5/4.5、优秀毕业生代表发言的背后是卷到极致的日常与期末高强度交付。最终决定重返前端,带着更强的学习能力、工程化思维和AI使用习惯,计划补齐知识并持续输出实战内容。
综述由AI生成前端开发三年后辞职赴韩读CS大数据硕士,复盘高密度学习、AI工具融入、博客带来的讲师机会等经历。GPA 4.5/4.5、优秀毕业生代表发言的背后是卷到极致的日常与期末高强度交付。最终决定重返前端,带着更强的学习能力、工程化思维和AI使用习惯,计划补齐知识并持续输出实战内容。
Qwen3-VL 基于 Llama-Factory 的 QLoRA 微调与部署全流程实战。内容涵盖环境配置、Open-EQA 数据集训练、评估指标分析、模型合并以及 Ollama 和 LMDeploy 两种部署方案。重点展示在 16GB 显存 T4 显卡上的实操细节,包括 Unsloth 加速、TensorBoard 监控及 PyTorch 后端推理优化,为具身智能多模态任务提供完整落地参考。
综述由AI生成时序数据具有高频写入、海量存储及独特查询模式等特点,传统数据库难以满足需求。选型需综合考量架构扩展性、数据模型、压缩效率、生态兼容性及运维成本。Apache IoTDB 作为 Apache 顶级开源项目,采用时间序列文件树模型契合物联网层级管理,支持端边云协同部署。其 TsFile 格式提供卓越压缩比与查询性能,并深度集成 Spark、Flink 等大数据生态。对于物联网及工业互联网场景,IoTDB 提供了从边缘采集到云端分析的完整解决…
综述由AI生成Ollama 是一款基于 llama.cpp 实现的本地大模型运行工具,支持在 CPU 上高效推理。详细讲解了 Ollama 的安装配置、命令行交互、Python 接口调用及 Jupyter Notebook 自定义魔法命令的实现方案。内容涵盖 Qwen2、Llama3 等模型的下载与运行,展示了如何通过 OpenAI 兼容接口集成第三方工具,并提供了完整的代码示例与性能优化建议。重点介绍了如何在本地环境中保障数据安全,解决内存瓶颈及常…
语义化 AI 驱动器在 AIGC 时代推动人机交互变革,技术演进呈现深度专业化与广泛民主化特征。文章解析多模态语义解析器架构,涵盖医疗诊断、法律文书生成及智能家居意图理解场景。探讨提示词工程的认知分层、自然语言交互进化及开发者能力升级路径。分析 2025 至 2030 年技术路线图,涉及对抗样本检测、跨语言语义对齐及因果推理集成。讨论动态伦理约束框架与提示词审计系统,为构建可信语义化 AI 提供治理方案。
综述由AI生成深入解析哈希(Hash)的核心概念,包括哈希函数、哈希表及冲突处理机制。详细对比了拉链法与开放寻址法的优劣,重点介绍了 C++ 标准库中 unordered_map 和 unordered_set 的使用方法及性能调优技巧。内容涵盖自定义类型作为 Key 的实现方案、常见坑点规避以及经典应用场景,旨在帮助开发者高效掌握哈希数据结构。
综述由AI生成基于 Rust 与 DeepSeek 构建高性能 Text-to-SQL 数据库代理服务。利用 Rust 语言的高性能特性结合 DeepSeek 大模型,构建了一个透明 PostgreSQL 代理层。通过实现 Wire Protocol,客户端无需修改即可连接。系统拦截自然语言请求,转换为 SQL 执行并返回结果。架构包含配置加载、数据库交互、模型集成及协议处理模块。支持高并发,具备 Schema 缓存机制。验证显示自然语言查询可准确转…
综述由AI生成探讨在 AI 代码助手普及背景下,程序员面临的认知负荷与记忆外包危机。引入 CRITIC 模型作为脑机协同时代的记忆决策协议,结合神经科学基础与企业级落地案例(如微软 CodeMind 项目),分析了如何通过非侵入式脑机接口与 AI 协作优化知识内化策略。文章提供了技术架构、算法实现及实施成果,强调动态权重调整与伦理边界,旨在帮助开发者在 AI 时代保持不可替代的认知能力。
Google 发布 Gemini Embedding 2 实现五模态统一向量空间,支持交错输入与俄罗斯套娃技术(MRL),降低存储成本并简化多模态管线。国内 MuleRun 推出'自进化'个人 AI 助手,提供 Super Agent 与 Computer 两种模式,具备记忆习惯与主动复盘能力。两者共同推动 AI 从极客玩具向平民化工具转变,降低开发者与普通用户的使用门槛。
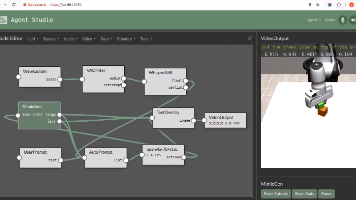
综述由AI生成在 Jetson AGX Orin 上部署 OpenVLA 模型的完整流程。涵盖 INT4/FP8/FP16 量化对比、基于 NanoLLM 的推理 API 实现、利用 MimicGen 进行仿真环境构建与数据生成、以及 LoRA 与全量微调策略。实验显示在积木堆叠任务中达到 85% 成功率,量化对精度影响小于 1%,为机器人 VLA 模型落地提供了参考方案。
综述由AI生成Whisper 和 Faster-Whisper 语音识别模型的分类、两种主要安装方式(pip 安装与 HuggingFace 下载)以及对应的代码运行示例。内容涵盖了基础环境配置、模型加载方法、GPU/CPU 运行选项及音频处理流程,旨在帮助开发者快速上手部署相关模型。
GESP C++ 四级 2025 年 12 月真题深度解析,涵盖指针操作、数组内存布局、排序稳定性及时间复杂度等核心考点。编程题部分详细拆解滑动窗口求最大海拔和策略,以及基于优先级、价格、字典序的多重条件贪心购买逻辑。通过代码实战演示,帮助读者掌握 C++ 基础语法与算法思维在竞赛中的应用。
AIGC 市场正经历快速扩张,涵盖文本、图像及多模态生成。核心挑战包括数据质量清洗、模型偏差缓解及内容真实性验证。通过 Transformers 与 Diffusers 库的实战代码,可掌握微调、生成及检索的关键流程。未来趋势指向垂直领域深化与多模态深度融合,技术落地需兼顾效率与伦理规范。
综述由AI生成人工智能发展历程涵盖三次浪潮,从符号主义到深度学习。文章解析了监督学习、无监督学习和强化学习三大范式,以及神经网络、CNN 和 RNN 的核心结构。探讨了 AI 在医疗、自动驾驶等领域的应用现状,并分析了数据依赖、可解释性、安全隐私及伦理挑战。最后展望了通用 AI 趋势与社会影响,倡导理性看待技术发展。
探讨企业级私有化大模型部署方案,解决数据隐私、云端成本及网络延迟问题。通过 Ollama 推理引擎与 Streamlit 前端框架,在本地硬件上构建安全可控的智能对话系统。内容涵盖开源模型选型、Ollama 安装与 API 调用实战、显存优化与量化技术、中文语境适配及推理延迟应对策略,旨在提供一套低门槛、自主可控的 AI 基础设施搭建指南。
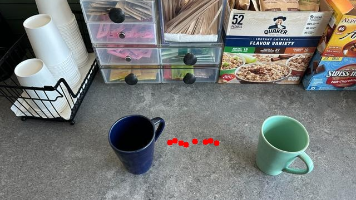
RoboBrain 2.0 是支持统一感知、推理和规划的具身大脑模型,提供 3B、7B、32B 版本。介绍环境搭建(Conda、依赖库、Torch)及多场景推理示例,包括图文问答(含思考模式)、目标检测、可供性预测、轨迹预测、指向预测及导航任务。
介绍 Logo.Redmond LoRA 模型,适用于 Stable Diffusion XL 基础模型。该模型专注于生成简洁精美的 Logo 图标,支持系统图标、产品标识及头像设计。提供详细的提示词配置与参数设置指南,帮助用户快速上手生成高质量矢量风格图形。涵盖安装部署、环境配置、提示词优化及常见问题排查,适合设计师与开发者使用。
综述由AI生成基于 Protege 和 Neo4j 构建教育领域知识图谱的完整流程。内容包括工具安装、OWL 转 Turtle 格式、RDF 数据导入 Neo4j、使用 APOC 库导出 JSON、利用 Python 脚本转换数据格式以适配 Echarts,最后通过 Vue 实现前端可视化。重点解决了 JDK 版本切换、文件转化失败及数据清洗等常见问题。
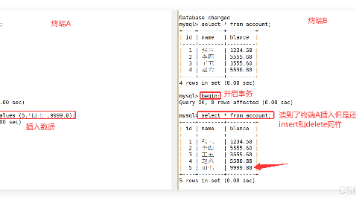
MySQL 事务是保障数据一致性的核心机制,遵循 ACID 原则。本文基于 InnoDB 引擎,详细讲解事务的开启、提交、回滚及保存点操作,并通过并发实验演示自动提交与手动控制的差异。重点剖析四种隔离级别的原理,分析脏读、不可重复读与幻读的产生原因,指导开发者根据业务需求选择合适的隔离级别,在并发性能与数据安全性之间取得平衡。

华盛顿大学与微软研究院在 Nature Methods 发表 BiomedParse 基础模型,支持跨九种成像模态的联合分割、检测和识别。该模型基于包含超 600 万张图像的大规模数据集训练,利用文本提示进行推理,无需手动交互如边界框。实验表明其在形状不规则对象上优于现有方法,并能有效拒绝无效文本提示,为生物医学发现提供高效工具。