
PythonAI算法
多模态模型开发实战:文本、图像与语音融合指南
多模态模型通过融合文本、图像、语音等数据实现全面理解。核心概念、架构选型及预处理流程,涵盖跨模态问答、文生图、语音助手三大场景落地方案,并提供基于 LLaVA、Stable Diffusion、Whisper 的完整代码示例与微调技巧,助力开发者从原型到产品高效构建多模态应用。
多模态模型通过融合文本、图像、语音等数据实现全面理解。核心概念、架构选型及预处理流程,涵盖跨模态问答、文生图、语音助手三大场景落地方案,并提供基于 LLaVA、Stable Diffusion、Whisper 的完整代码示例与微调技巧,助力开发者从原型到产品高效构建多模态应用。
Neo4j 图数据库核心概念与在线控制台实战指南。详解节点、关系、属性三大模型及 Cypher 查询语言基础。通过 Neo4j Aura 预览版控制台演示数据库创建、连接及数据操作全流程。解析查询工具六大模块功能,包括编辑器、结果视图、历史记录等。提供唐诗知识图谱构建示例,指导用户完成从建表到查询的完整练习,适合希望快速上手图数据库技术的开发者。
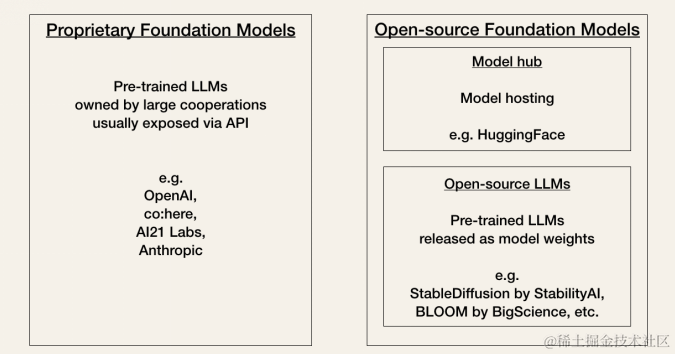
综述由AI生成LangChain 是一个用于构建 LLM 驱动应用的开源框架,提供通用接口、提示管理、内存及外部数据访问等功能。 LangChain 的安装环境配置、API 密钥获取(OpenAI、Hugging Face)、以及六大核心模块:模型选择、提示模板管理、链式组合、外部数据索引、对话记忆和代理工具使用。通过示例代码展示了如何利用 LangChain 实现聊天机器人、文档问答等应用场景。
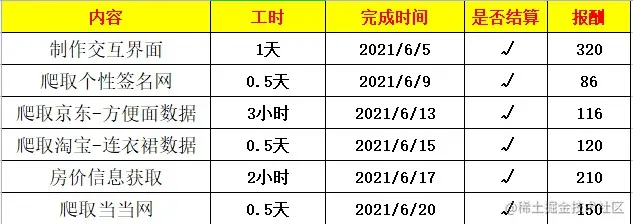
综述由AI生成详细阐述了 Python 在网络数据采集、Web 开发及数据分析领域的兼职应用。内容涵盖常见项目类型、核心技术栈(Requests、Selenium、Pandas)、反爬机制应对策略以及代码实战示例。同时强调了项目管理中的需求确认、报价合同、时间分配及法律合规风险,为希望利用 Python 技能开展副业的开发者提供了系统的技术路径与商业指导。
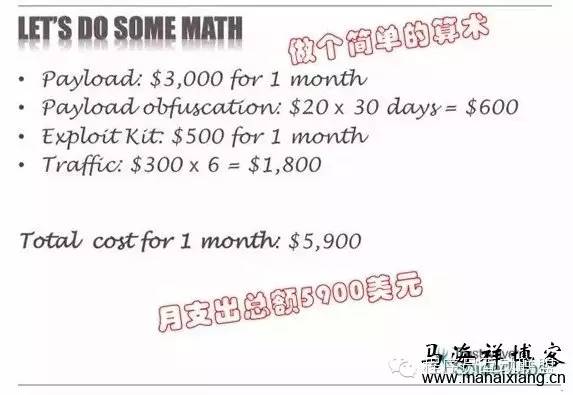
综述由AI生成文章基于 Trustwave 研究报告分析了地下黑客经济生态。内容涵盖黑客论坛、漏洞利用工具包、勒索软件及多种商业模式如租赁和分成制。详细描述了 RIG 和 Magnitude 等团伙的运作方式,包括代码混淆、数字证书盗用等辅助服务。此外,补充了针对勒索软件和漏洞利用的技术防御措施,强调补丁管理、备份策略和用户意识的重要性,旨在揭示网络犯罪背后的经济逻辑并提供防护思路。
介绍 Python 语言优势及 Linux/Windows 环境搭建步骤,涵盖核心语法规则(标识符、注释、缩进)与常用内置数据类型(数字、字符串、列表、元组、字典),适合零基础快速上手。
我国网络安全市场规模高速增长,但人才供需严重失衡,累计缺口超 140 万,预计 2027 年达 300 万。行业本质是攻防对抗,当前人才结构底部过大顶部过小,缺乏懂业务懂管理的高端综合型人才及首席安全官(CSO)。解决之道在于加强顶层设计,推动高校与企业协同培养,重视实战经验与逆向思维,并建立从救火队员向战略专家进阶的职业路径。
综述由AI生成详细阐述了爬虫技术在数据分析、人工智能、金融、营销及科研等领域的具体应用场景。介绍了以 Python 为核心的技术栈,包括 Requests、Scrapy、Selenium 等主流工具的使用。内容涵盖数据清洗、ETL 流程、存储方案以及反爬策略与法律合规性。最后梳理了从初级工程师到架构师的职业发展路径,强调技术深度与合规意识的重要性。
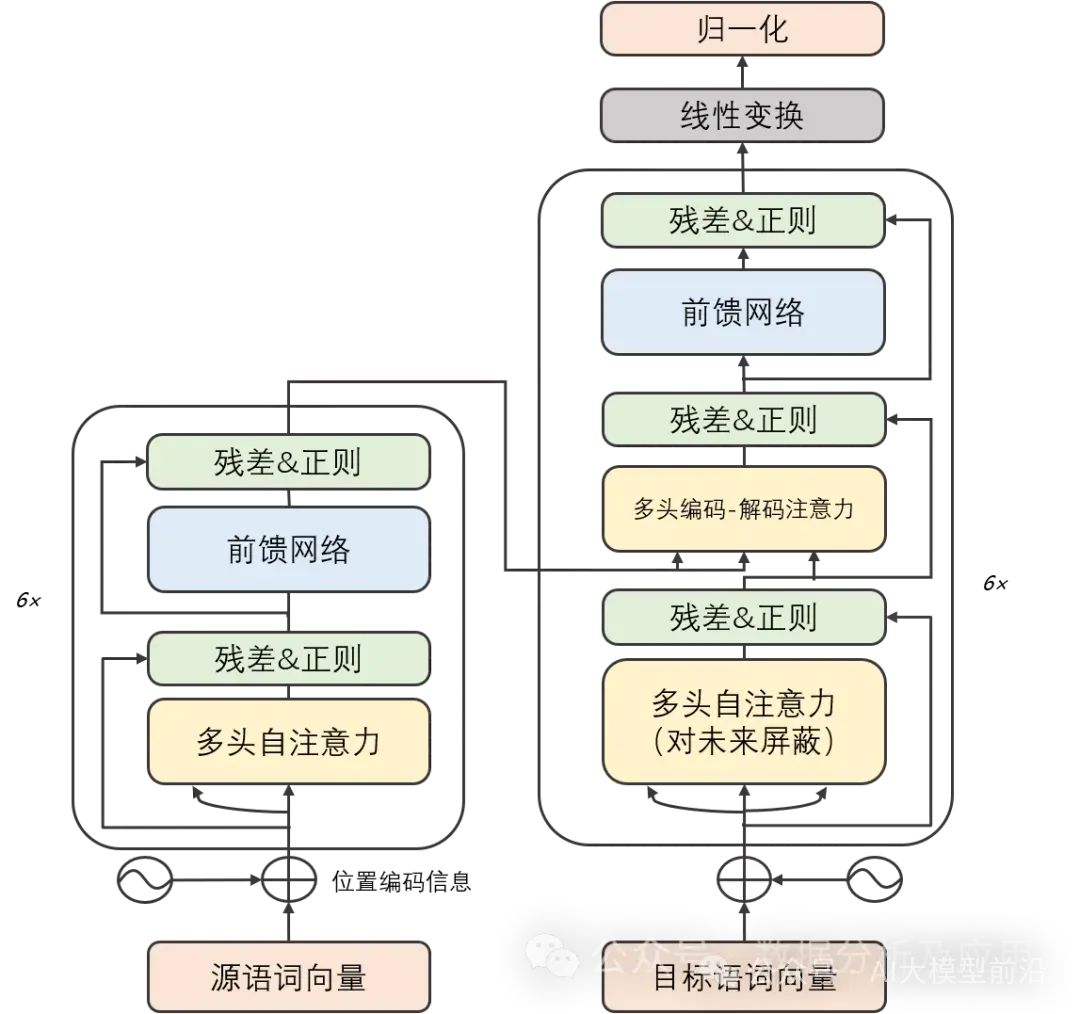
综述由AI生成LLM 大模型的六项核心技术,包括 Transformer 架构、预训练范式、基于人类反馈的强化学习(RLHF)、模型压缩技术、多模态融合以及算力资源投入。重点阐述了各技术的原理、优缺点及应用场景,强调了在规模定律下资金与计算资源对大模型发展的决定性作用,为理解大模型底层逻辑提供了系统性的技术视角。

大模型技术学习涵盖应用场景如 Prompt 工程、AI Agent、私有知识库及微调训练。建议从 Python 基础入手,掌握向量数据库与 LangChain 框架,进行本地开源模型部署。进阶需理解机器学习、深度学习(Transformer)、NLP 基础及 LLM 架构分支。深入方向包括预训练、微调(LoRA/QLoRA)、RLHF 及生产环境部署。旨在帮助开发者构建大模型应用能力。
综述由AI生成大模型微调技术旨在利用预训练模型知识适应特定任务,降低训练成本。全量微调、前缀微调、提示微调、P-Tuning 及 LoRA 等参数高效微调方法及其原理。通过 CoLA 数据集的 BERT 模型实战代码,展示了环境配置、数据预处理、模型训练及性能测试流程。实验分析表明,LoRA 在保持接近全量微调性能的同时显著降低了计算资源消耗,适合资源受限场景。掌握这些技术有助于开发者高效部署垂直领域大模型应用。
纯 C# 全自研轻量 UI 引擎|内核 < 200KB + .NET8 AOT 跨平台 + 百万数据 60fps 介绍一款纯 C# 用户态跨平台 UI 引擎。 引擎的演进之路:从 WinForms + GDI 起步 → 多次架构重构 → 最终定型 GLFW + SkiaSharp,深度融合业界三大核心思想: Android View 绘制流程 Jetpack Compose 函数式组合编程 F…
AI Agent 从零落地的九步实操框架。包括精准锁定重复工作、拆解标准化 SOP、匹配技术能力选型平台、定义 API 级输入输出、编写高质量系统提示词、构建三层记忆体系、配置安全护栏与人工审核、封装极简交互界面以及真实场景测试迭代。旨在帮助用户无需复杂代码即可搭建自动化系统,提升工作效率。
SubtitleEdit 的 Purfview Faster Whisper XXL 引擎安装常因权限、网络或磁盘空间导致失败。主要症状包括进度条停滞、解压错误或权限拒绝。解决方案包括清理残留文件并设置正确目录权限、切换网络环境或关闭防火墙、以及重置配置。系统需满足 Windows 10/11 及足够内存磁盘要求。通过权限修复和网络优化可恢复语音识别功能。
YOLO12 WebUI 目标检测工具的部署与使用方法。通过预置镜像可直接在 Linux 服务器启动服务,无需本地配置 Python 环境。支持点击或拖拽上传图片进行实时检测,界面展示边界框、类别名称及置信度。提供模型切换、日志查看及 API 调用等进阶功能,并包含常见问题排查指南。适合希望快速集成目标检测能力的开发者使用。
综述由AI生成llama-cpp-python 的本地部署流程。作为 llama.cpp 的 Python 接口,它支持在本地高效运行大语言模型。内容涵盖基础安装、NVIDIA GPU/Apple Metal/CPU 硬件加速配置、预编译包使用、环境验证脚本编写以及 Windows 和 macOS 的系统特定配置。此外还列出了 OpenAI 兼容接口、多模态支持等高级特性,帮助开发者快速搭建本地 AI 推理环境。
2026 年毕业季 AIGC 检测已成为高校论文审核的硬性要求,主要标准为本科 30%、硕士 15%-20%、博士 10%。知网算法升级使得检测更精准,仅靠改词或翻译回译难以规避。超标后果包括延期答辩甚至取消资格。文献综述、理论框架及摘要部分易被标记。建议采用预防为主、专业工具辅助及手动修改相结合的策略,并预留充足时间进行多轮检测与调整,确保符合学术规范。
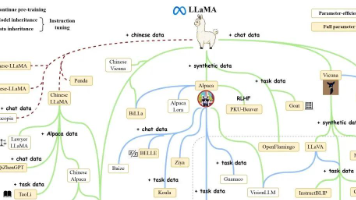
综述由AI生成系统梳理了 Meta Llama 系列大模型从 Llama-1 到 Llama-3 的演进历程。内容涵盖各版本的发布时间、参数量、架构改进(如 RMSNorm、SwiGLU、RoPE、GQA)、训练数据规模与来源、训练方法(SFT、RLHF、DPO)及基准测试表现。文章分析了 Llama 在开源社区的影响力及其对 AI 技术发展的推动作用,并对比了不同版本间的性能差异,为理解开源大模型的技术细节与应用前景提供了参考。
实测 ANSYS Fluent 2026 R1 新发布的 AI-Mesh 功能在电动汽车风阻优化中的应用。通过对比传统方法与 AI 辅助网格生成,结果显示网格生成时间缩短 82%,近壁层网格质量提升。AI 技术能自动识别几何特征并预测加密区域,显著降低计算资源消耗,重塑流体仿真流程。
Stable Diffusion Docker 部署指南 想要体验强大的 AI 图像生成功能,但被复杂的安装配置吓退?现在通过 Stable Diffusion WebUI Docker 项目,只需简单几步就能在本地运行专业的 Stable Diffusion 系统。这个项目使用 Docker 容器技术,让 AI 图像生成变得触手可及。 为什么选择 Docker 部署 Stable Diffusi…