
C++算法
C++ 入门:命名空间(namespace)详解
C++ 命名空间用于解决标识符冲突问题,通过划分独立作用域实现代码模块化。核心用法包括显式指定路径、using 声明成员或展开整个命名空间。命名空间支持嵌套与不连续定义,本质是隔离全局污染。开发中建议优先使用 :: 访问方式,避免在头文件中使用 using namespace。
C++ 命名空间用于解决标识符冲突问题,通过划分独立作用域实现代码模块化。核心用法包括显式指定路径、using 声明成员或展开整个命名空间。命名空间支持嵌套与不连续定义,本质是隔离全局污染。开发中建议优先使用 :: 访问方式,避免在头文件中使用 using namespace。
计算机类专业涵盖软件开发、新媒体运营、文创设计及电竞管理等多个方向,核心课程包括计算机基础理论、系统结构及汇编语言等。就业方向广泛,涉及软件研发、UI 设计、影视动漫及电商运营等领域。技术学习方面,Python 是重要工具,涵盖基础语法、爬虫技术、数据分析、数据库 ETL 数仓构建及机器学习应用。掌握这些技能有助于满足企业用人需求,但需长期坚持训练。
综述由AI生成深入解析了 Vision Transformer(VIT)和 Swin Transformer 的核心原理,并详细阐述了 Qwen3-VL 模型如何融合两者优势。VIT 通过全局自注意力机制实现图像全局建模,但计算复杂度高;Swin Transformer 利用分层架构和移位窗口注意力将复杂度降至线性。Qwen3-VL 采用三模块架构,结合 DeepStack 跨层融合机制、Interleaved-MRoPE 位置编码及文本时间戳对齐技…
综述由AI生成全面梳理了大模型面试的核心知识点,涵盖基础架构、进阶原理、微调策略、LangChain 应用及推理优化。内容包括主流开源模型体系对比、Prefix/Causal LM 区别、涌现能力成因、LLM 复读机问题解决方案、全参数与 PEFT 微调显存分析、SFT 数据构建与灾难性遗忘缓解、RAG 文档对话优化、位置编码与 Tokenizer 技术细节等。文章旨在为求职者提供系统的技术复习指南,帮助掌握从理论到工程落地的关键技能。

综述由AI生成RAG(检索增强生成)通过结合外部知识库与语言生成模型提升回答准确性。深入探讨 RAG 系统中的关键前置任务:意图识别与槽位填充。意图识别用于判断用户核心需求,解决多意图及语义模糊问题;槽位填充则提取关键实体信息以完善查询条件。两者结合能显著提升智能问答系统的理解能力与自然度。文章分析了基于规则、统计机器学习及深度学习的实现方法,并探讨了 BERT 等预训练模型在联合分类与填充中的应用架构,为构建高精度对话系统提供技术参考。
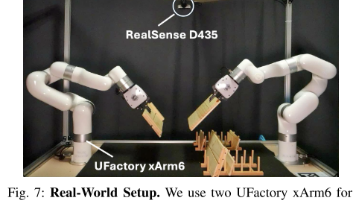
综述由AI生成Manual2Skill 框架通过视觉语言模型解析家具说明书,实现机器人自主装配。该方法利用分层装配图生成、单步位姿估计及运动规划,解决了从抽象手册到物理执行的难题。在宜家家具及多种任务中验证了有效性,展示了机器人在复杂操作任务上的泛化能力与进步。
综述由AI生成命名空间是 C++ 中用于解决标识符命名冲突的重要机制,通过创建独立的作用域来隔离变量、函数和类。文章详细讲解了命名空间的定义语法、三种访问方式(域作用限定符、using 成员、using namespace)、嵌套与非连续定义特性,以及其作为独立作用域的本质。重点阐述了命名空间在解决多人协作冲突、模块化代码组织和避免全局污染方面的价值,同时指出了定义限制和使用陷阱,如头文件中禁用 using namespace 及避免过度嵌套。掌握命…
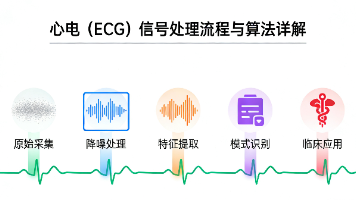
综述由AI生成心电(ECG)信号处理的标准流程,涵盖信号获取、预处理及 QRS 波群检测。预处理重点介绍噪声去除(基线漂移、工频干扰、肌电噪声)及基线校正方法(高通滤波、多项式拟合)。QRS 检测部分解析了检测器结构(线性滤波器、非线性变换、决策规则)及常用算法(Pan-Tompkins、小波变换、神经网络等),为心律失常诊断提供技术基础。
综述由AI生成详细对比了 Qwen3 系列四大模型(Max、Next、Omni、Coder)的架构定位、训练方式及核心差异。重点解析了 Qwen3 如何通过分阶段训练策略(S0-S3)实现 256K 超长上下文扩展,包括动态权重调整与平方根重加权调节机制。此外,文章深入探讨了 RoPE(旋转位置编码)的数学原理,形式化说明了其相对于 Sinusoidal 编码在长序列外推、维度处理及训练稳定性方面的优势,为理解大模型长上下文技术提供了理论支撑。
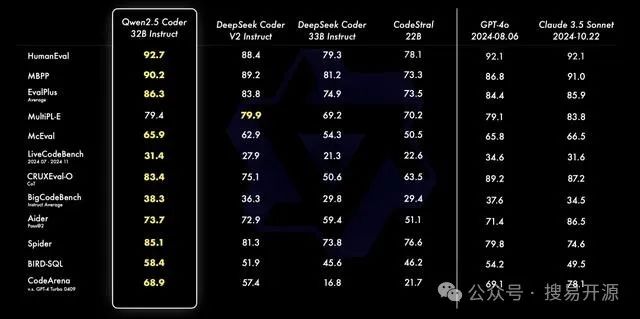
综述由AI生成阿里云通义千问 2.5 模型(Qwen2.5)在预训练和微调方面展现卓越性能,支持 128K 上下文及 29 种语言。详细阐述了基于阿里云 PAI 平台的部署流程,涵盖环境配置、EAS 服务搭建、HTTP API 与 Python SDK 调用方法。重点介绍了 SFT 和 DPO 两种微调算法的数据格式与训练配置,以及自定义与公开数据集的评测方案。同时补充了显存优化、收敛调试及推理延迟改进的最佳实践,帮助开发者高效落地大模型应用。
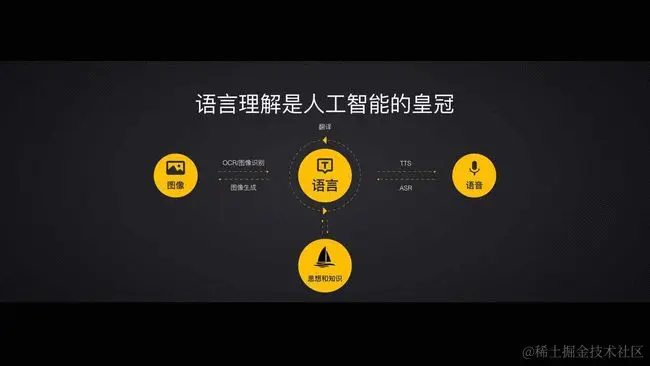
综述由AI生成深入探讨了 RAG 在大模型中的核心作用,重点分析了文档切分的多种策略,包括基于规则、语义聚类、机器学习及代理方法。通过 Python 代码实践展示了 PDF 文档解析与文本分块的具体实现,强调了 chunk_size 和 overlap 参数对检索质量的影响。此外,文章对比了长上下文窗口与 RAG 的优劣,指出长上下文虽提升了连贯性,但 RAG 在成本控制、知识时效性及幻觉抑制方面仍具不可替代性,是企业级应用的首选架构。
笔记本 CPU 运行 Faster-Whisper 时,int8 量化下 Base 模型是速度与准确率的平衡点。Tiny 适合低延迟场景,Distil 虽准但显存与算力消耗大,需谨慎评估硬件。
镜像服务作为原始网站的副本,用于解决网络访问受限问题。 GitHub、谷歌学术及 Sci-Hub 等资源的镜像原理、常见形式及潜在风险,包括账户安全、数据延迟和法律合规性。建议将镜像视为只读公共图书馆,避免敏感操作,并根据同步频率选择合适的节点以保障工作效率。
综述由AI生成中文分词是自然语言处理的基础挑战,双向最大匹配算法通过结合正向与逆向策略优化切分结果。文章解析了 FMM 和 BMM 原理,提供 Python 实现代码,对比分析该算法在古诗词与现代文场景下的表现差异。基于词典的贪心策略虽存在局限性,但凭借高效特性仍是工程实践中的重要基线方案。
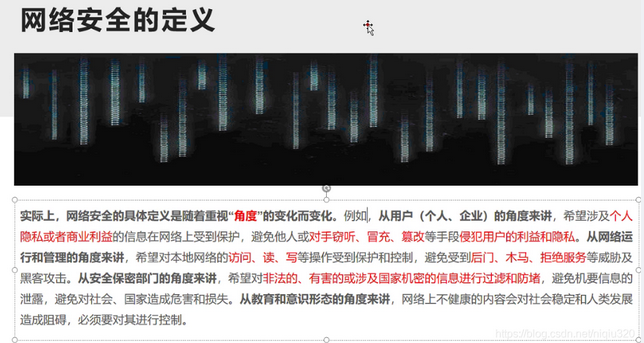
网络安全涉及信息保密性、完整性等要素。渗透测试通过模拟攻击评估系统风险,包含前期交互、情报搜集、威胁建模、漏洞分析、渗透攻击、后渗透及报告撰写七个阶段。 OWASP Top 10 应用安全风险,涵盖注入、失效身份认证、敏感数据泄露等常见漏洞原理及防御思路。同时梳理白帽子、黑帽子、肉鸡、Webshell 等专业术语,帮助读者建立完整的网络安全知识体系,理解攻防对抗的基本逻辑与合规操作规范。
2024 年中国金融大模型产业的发展现状与趋势。指出 AIGC 技术推动行业生产力变革,但通用大模型在专业领域存在数据缺失、幻觉及合规风险等局限。文章强调垂类大模型因专业度高、成本低且易于私有化部署,将成为未来核心落地方式,预计五年内覆盖超 80% 专业领域。技术演进将聚焦多模态架构优化、私有化部署及智能体应用,助力金融机构安全高效地实现数字化转型。
综述由AI生成昇腾 NPU 环境下部署 CodeLlama 的完整实践。涵盖环境检查、依赖安装、模型加载、基础推理及性能测试。通过 Transformers 库配合 torch_npu,实现 FP16 精度下的模型推理,验证了 NPU 在代码生成任务中的低延迟与高吞吐能力,适合开发者快速上手大模型落地。
综述由AI生成探讨了大型语言模型微调与检索增强生成(RAG)的技术差异及应用场景。文章首先介绍了微调的基本概念及其在低延迟、高准确度任务中的优势,同时也指出了 RAG 在处理动态数据和减少训练成本方面的灵活性。随后,文章详细对比了两种方法的优缺点,提供了选择决策准则。最后,基于 Amazon SageMaker 平台,给出了使用 Llama 2 模型进行微调的完整实践流程,涵盖数据准备、模型选择、超参数配置、性能评估及部署步骤,旨在帮助开发者掌握大模…
综述由AI生成nnU-Net 是一种用于生物医学图像分割的自配置深度学习框架。它通过系统化专家经验,将模型参数分为固定参数、基于规则参数和经验参数三部分,针对不同数据集自动调整预处理、网络结构、训练策略及后处理流程。实验表明,在多个权威数据集上 nnU-Net 达到 SOTA 性能,且模型配置对性能的影响大于架构改进。该方法无需手动调参,为医学图像分割提供了统一可靠的基础工具。
基于阿里云ASR构建AI电销机器人涉及技术选型、架构设计与生产部署。方案涵盖Flask路由、WebSocket音频流处理、RAM权限配置及Nginx优化细节。重点解决Token自动刷新、文本后处理及录音加密等关键问题,提供低成本、高并发实时语音交互系统的落地参考。