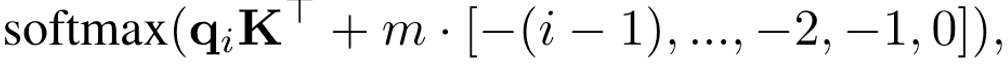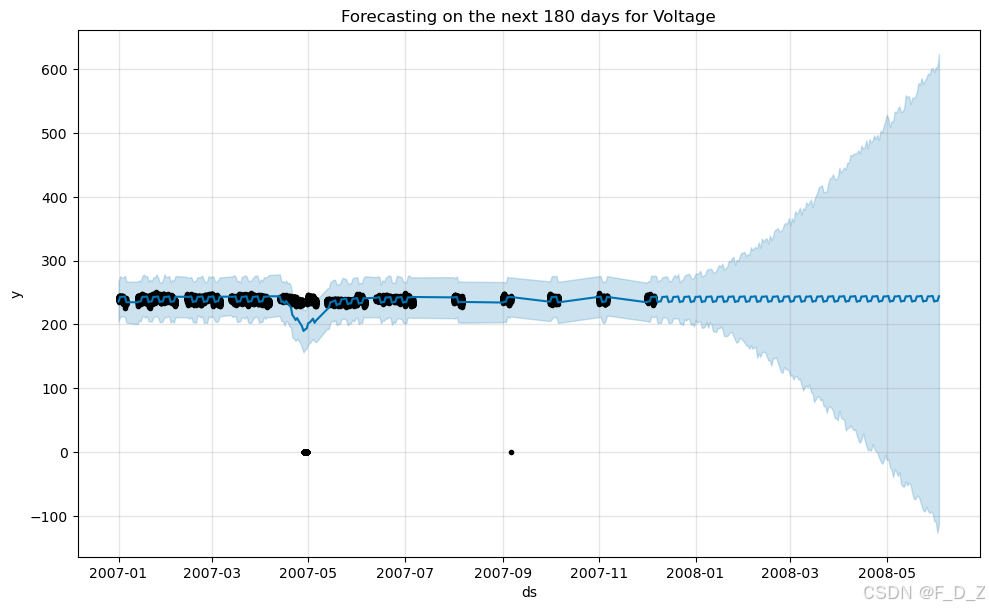
家庭用电数据分析与 Prophet 预测
家庭用电数据分析基于 240000-household-electricity-consumption-records 数据集,涵盖 2007 年 1 月至 6 月的有功功率、无功功率、电压及分项计量数据。通过 Pandas 进行数据清洗与探索性分析,包括缺失值处理、类型转换及相关性热力图绘制。利用 Facebook Prophet 库构建时间序列预测模型,针对有功功率、无功功率、电压和电流强度进行未来 180 天预测。Prophet…

家庭用电数据分析基于 240000-household-electricity-consumption-records 数据集,涵盖 2007 年 1 月至 6 月的有功功率、无功功率、电压及分项计量数据。通过 Pandas 进行数据清洗与探索性分析,包括缺失值处理、类型转换及相关性热力图绘制。利用 Facebook Prophet 库构建时间序列预测模型,针对有功功率、无功功率、电压和电流强度进行未来 180 天预测。Prophet…
综述由AI生成针对绿色施工项目的多目标优化问题,建立了融合动态不确定性因素的集成优化数学模型,涵盖工期、成本、质量及安全环境资源等目标。提出一种融合多策略自适应交叉变异与局部搜索增强的改进 NSGA-Ⅱ算法,通过动态调整算子参数和周期性局部搜索提升寻优能力。设计基于熵权 TOPSIS 与模糊决策的后处理方法,辅助从高维帕累托前沿中优选方案。提供了完整的 Python 实现代码示例。
综述由AI生成PHP 反序列化漏洞利用针对 ctfshow-web257 题目展开,重点讲解私有属性在序列化中的命名规则及 POP 链构建逻辑。通过分析源码发现 __destruct 魔术方法作为入口点,配合 backDoor 类中的 eval 实现 RCE。文章演示了如何根据属性修饰符调整序列化字符串格式,并提供自动化脚本生成 Payload 的方法,帮助理解从对象构造到代码执行的完整路径。

综述由AI生成详细解析了 LLM 应用的三种核心模式:嵌入模式、Copilot 模式与 AI Agent 模式。嵌入模式侧重于 AI 辅助人工决策,适用于法律分析、报告生成等低风险场景;Copilot 模式强调人机实时协作,适合软件开发和内容创作等需频繁迭代的任务;AI Agent 模式赋予 AI 高度自主权,可独立完成任务分解与执行,适用于自动化运营与金融交易等复杂场景。文章对比了三者在控制度、复杂度、成本及适用性上的差异,并从安全性、成本控制、性…
LLaMA-Factory WebUI 模型加载常见问题包括超时、依赖缺失、显存不足及配置错误。解决方案涵盖本地下载模型、更新 PyTorch 等依赖库、启用量化降低资源占用、验证配置文件完整性以及检查网络连接。通过分步测试小模型、使用日志定位错误及合理分配系统资源,可有效提升部署成功率。
青少年机器人编程涉及机械工程、电子电路与计算机科学的综合应用。学习路径通常分为五个阶段:机械启蒙、图形化编程、开源硬件代码过渡、高阶机器人与算法、专业领域融合。建议遵循硬件驱动软件的原则,先建立物理认知再深入逻辑,利用金属结构体验真实工程环境,并通过调试培养抗挫折能力。最终目标是掌握 ROS、机器学习等技术,解决实际问题。

Phelix 是由 Doug Whiting 等人设计的高速流密码,2004 年提交至 eSTREAM 项目。该算法面向硬件优化,利用 ARX 操作实现高吞吐量,采用 256 比特密钥注入及内部状态混合保障安全。其设计借鉴分组密码轮函数结构,虽因缺乏 S 盒导致随机性受限,但对序列密码研究具有参考价值。

基于空间注意力机制的神经网络 SANN 的设计与实现。针对传统 CNN 在处理时序数据时特征重要性区分不足的问题,SANN 通过通道维度聚合与空间注意力权重生成,动态强化关键时序特征。实验表明,该模型在人体活动识别任务中达到 96.31% 准确率,推理时间仅 1.61ms,兼具高精度与高效率,适合实时应用场景。
综述由AI生成JVM 垃圾回收机制直接决定系统稳定性与性能表现。文章从工程视角梳理了 GC 核心体系,涵盖底层回收算法(标记清除、复制、整理及并发重定位)、GC 类型(新生代、老年代、全堆)以及主流收集器(Serial、Parallel、G1、ZGC 等)的选型逻辑。通过对比不同场景下的停顿目标与内存特征,提供了避免 Full GC 频繁触发、优化晋升策略的实战建议。掌握对象生命周期与分配模式,比死记参数更能有效应对线上性能抖动。

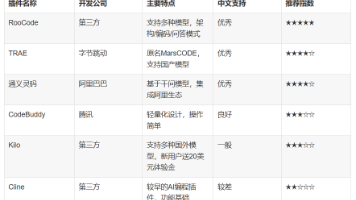
VS Code 插件搭建 AI 开发环境涉及工具选择、插件安装配置及模型服务对接。主流插件包括 RooCode、TRAE 等,其中 RooCode 支持多模式且中文友好。配置需连接 API,可通过摩搭社区免费体验或对接 Minimax、Deepseek 等原生付费接口。完成基础功能与代码生成测试后,可进一步进行多模型管理与快捷键优化以提升效率。

注意力机制通过 QKV 框架解决长序列依赖问题,Transformer 模型基于此实现并行计算。详解自注意力与多头注意力原理,展示 TensorFlow 搭建编码器解码器架构,并通过英法翻译实战演示数据预处理、模型编译训练及优化技巧,涵盖位置编码、掩码处理等核心细节。

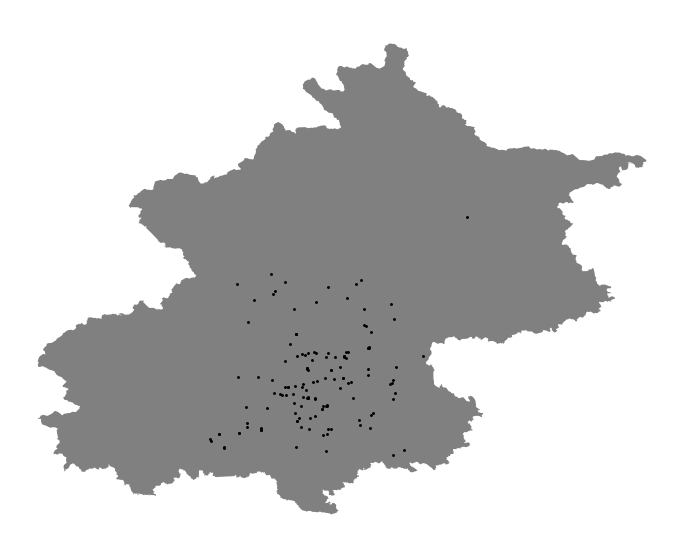
综述由AI生成Python 地理数据处理通常依赖 Matplotlib、GeoPandas 和 Shapely 等库。文中展示了坐标转换后绘制站点点与边界多边形的方法,以及将矩阵数据渲染为热力图的实现。学习编程需注重动手实践,通过数据分析、爬虫等实战项目巩固知识,避免只看不练。

综述由AI生成探讨了大语言模型(LLM)在推理阶段处理超出训练上下文长度(Length Generalization)的几种主流外推方法。主要包括 ALiBi 通过线性偏差增强远距离依赖捕捉;位置内插法(PI)通过缩放位置编码适应长序列但可能影响局部分辨率;NTK-aware Scaled RoPE 及动态缩放 RoPE 通过调整基频参数实现高频外推与低频内插;YaRN 结合灵活进制设计与温度参数优化注意力分布。这些方法旨在保持模型在超长序列下的性能…
通过 gpt-oss-20b-WEBUI 镜像零门槛部署开源大模型。整合 vLLM 推理引擎与 Open WebUI 前端,支持双卡 4090D 显存分配。无需配置 CUDA 或编译源码,启动即用。功能涵盖日常办公辅助、代码生成、联网搜索及多轮上下文对话。实测首 token 延迟 1.8 秒,吞吐量 158 tokens/s。提供常见问题解决方案,适合快速构建本地 AI 助手。
llama.cpp 量化模型部署实战指南,解决在普通电脑上运行大模型的需求。核心步骤包括获取并编译 llama.cpp 源码,准备 GGUF 格式的模型文件,以及搭建 HTTP API 服务。利用纯 C/C++ 实现与量化技术,显著降低资源消耗并提升推理速度。适用于本地体验大模型能力及低成本部署私有 AI 应用的技术场景。
综述由AI生成探讨 C++ 多线程环境下的资源保护机制,重点讲解临界区概念及 std::mutex 的使用。通过对比手动加锁与 RAII 封装的 std::lock_guard,说明异常安全的重要性。文章分析了锁粒度对性能的影响,指出判断与操作需在同一锁内以避免竞态条件,并总结了死锁风险规避原则。同时结合 Java synchronized 关键字进行跨语言对比,强调共享数据必须受保护的核心并发思维。

Python 因其简洁语法成为网络爬虫首选语言。爬虫工作原理,涵盖请求发送、页面解析及数据存储流程。针对反爬机制如 IP 封禁、验证码、JS 渲染等提供应对方案,包括 Headers 设置、代理池使用及 Selenium 自动化。强调合法合规采集数据的重要性,避免法律风险。适合希望掌握数据采集技能的开发者参考。

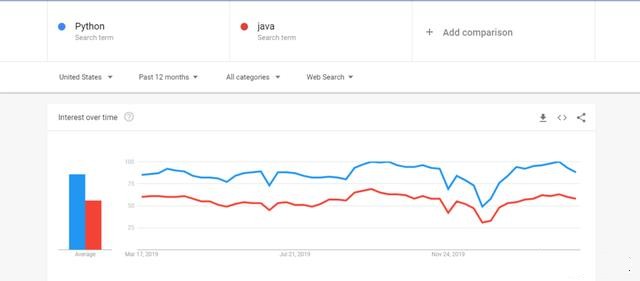
Python 和 Java 是两种主流编程语言。Python 语法简洁,易学性强,拥有丰富的开源社区和库,适用于人工智能、数据科学及快速开发场景。Java 性能优越,编译效率高,架构稳定,广泛用于企业级 Web 开发和大型软件系统。两者均支持跨平台运行,但执行机制存在差异。初学者若专注于 AI 或大数据可选 Python;若致力于 Web 后端或大型系统构建则建议 Java。根据具体业务需求和技术栈偏好选择合适的语言是关键。

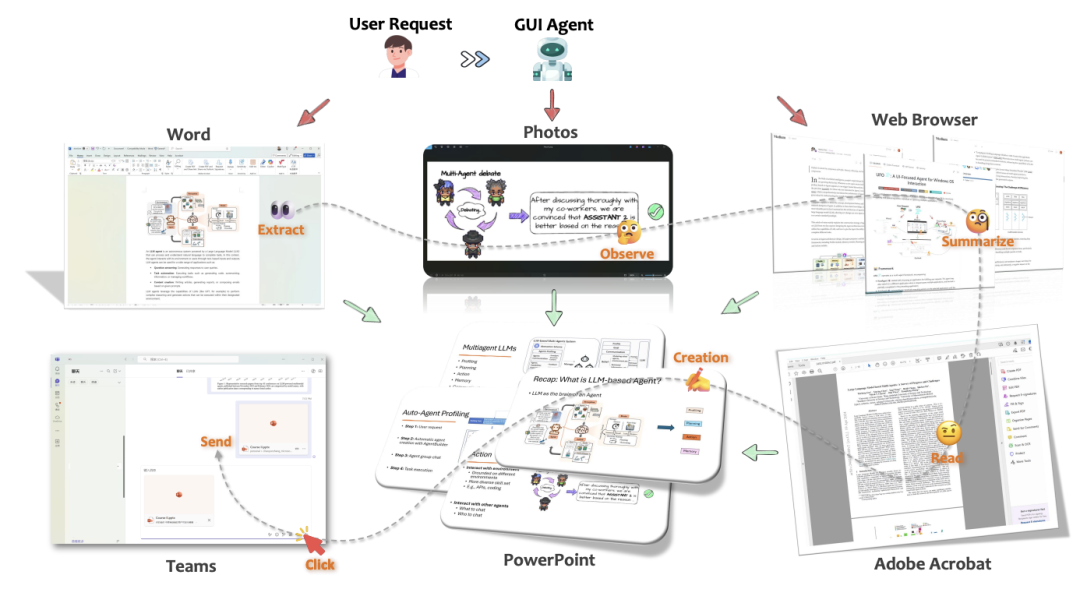
综述由AI生成全面综述了基于大语言模型的 GUI 智能体技术,涵盖发展历程、核心架构、数据策略及评价体系。文章详细解析了操作环境、提示工程、模型推理、动作执行与记忆机制五大关键技术模块,探讨了多模态数据收集与模型微调方法。同时介绍了 WebAgent、AutoDroid 等现有框架的应用现状,并分析了多模态融合、跨平台兼容、隐私安全等面临的挑战与未来发展方向。该研究为构建自主操作屏幕的智能系统提供了理论依据与实践指南。

GraphRAG 通过构建知识图谱解决传统向量检索在宏观查询上的不足。介绍其核心原理、环境配置、索引构建及全局与局部检索方法,并分析其在商业落地中的成本与局限性。内容涵盖实体提取、社区检测、配置详解及优化建议,旨在帮助开发者深入理解 GraphRAG 架构并评估适用场景。