
PythonAI算法
AI 安全:Stable Diffusion 视觉提示词注入攻击原理与实现
探讨基于对抗攻击的视觉提示词注入技术,通过 PGD 算法微调输入图像像素,绕过 Stable Diffusion 的安全检测机制。内容涵盖威胁模型定义、环境配置、核心攻击流程(梯度计算、损失优化)及效果验证。旨在帮助开发者理解生成式模型的安全边界,强化防御体系。
探讨基于对抗攻击的视觉提示词注入技术,通过 PGD 算法微调输入图像像素,绕过 Stable Diffusion 的安全检测机制。内容涵盖威胁模型定义、环境配置、核心攻击流程(梯度计算、损失优化)及效果验证。旨在帮助开发者理解生成式模型的安全边界,强化防御体系。
综述由AI生成Python 集合与字典是两种重要的内置数据结构。集合用于存储无序且唯一的元素,支持去重及数学集合运算;字典用于存储键值对,通过键快速查找值,适用于配置管理或对象映射。详细讲解了它们的创建方式、常用操作方法(增删改查)、遍历技巧以及性能特点,帮助开发者高效利用这两种结构处理数据。
综述由AI生成Python 至 OpenClaw 的本地 AI 助理开发路径梳理。首先通过 Python 调用本地 Ollama 模型,掌握 API 交互与环境搭建;接着深入 Ollama 进行模型管理与 RAG 优化;随后利用 Trae IDE 提升编码效率并接入自定义模型;最后部署 OpenClaw 框架实现 AI 自动化行动。该路径整合了本地大模型、智能编程助手及开源代理框架,帮助开发者构建具备实际执行能力的本地 AI 助理系统。
综述由AI生成详细阐述了利用 Python 进行图像背景抠图的三种技术路径。首先介绍了针对纯色背景的像素级透明度处理;其次探讨了通过采样学习多色背景颜色的方法;最后提出了一种基于 RGB 最大最小值范围的统计阈值法。文章通过代码示例和效果对比,分析了各方案的优缺点,展示了如何通过简单的编程逻辑解决图像处理中的自动化需求,并总结了代码化处理工具在缺乏专业软件时的替代优势及性能优化方向。
小米智能家居 Miloco 分离式部署方案涵盖 Docker 后端搭建、LM Studio 本地视觉模型配置及云端规划模型对接流程。通过解耦大模型服务,实现更灵活的本地化 AI 应用部署,适合具备基础 Linux 操作能力的开发者参考。
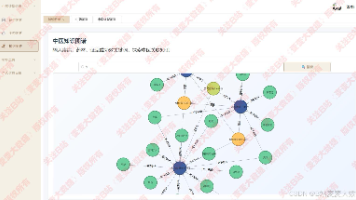
本系统基于 Vue、Flask、Neo4j 及 MySQL 构建,实现中医证型与中药信息的数字化管理。核心功能涵盖用户登录注册、智能问答、病症推荐及知识图谱可视化。采用 TF-IDF、TextRank、YAKE 等文本挖掘算法处理中药功效与药理数据,结合混合推荐算法提供个性化服务。前后端分离架构支持多维度数据分析与用户画像分析,管理员可维护基础数据并监控系统运行状态。
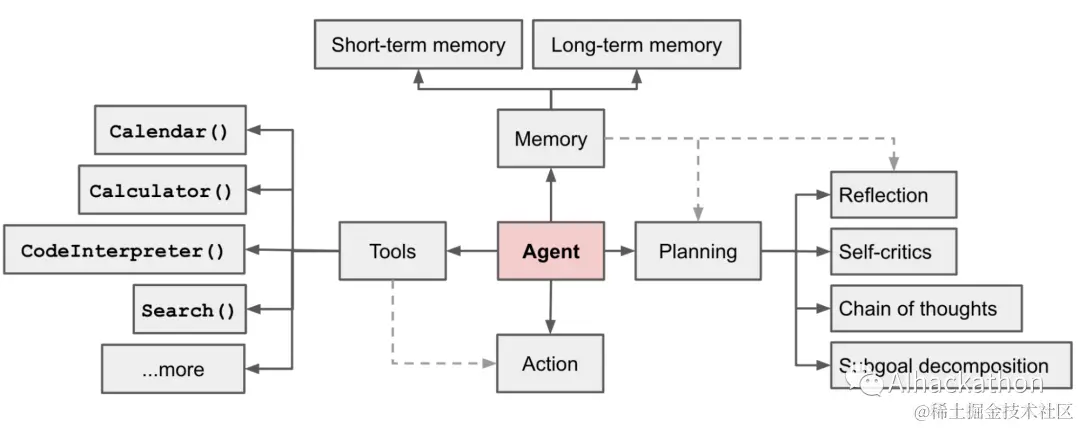
AI Agent 框架通过语言模型作为推理引擎,具备自主发现问题、确定目标及执行方案的能力。深入解析 Agent 核心组件规划、记忆与工具,对比思维链与 ReAct 框架的运作机理。结合 TypeScript 代码示例,演示如何构建 Agent、定义工具 Schema 及设计执行器循环,涵盖错误处理、中间步骤管理及最佳实践,为开发者提供从理论到落地的完整技术指南。

综述由AI生成综述了深度多模态数据融合技术,对比了传统与深度学习时代的融合差异。提出基于编码器 - 解码器、注意力机制、图神经网络、生成式网络及约束方法的五类新分类法。涵盖视觉 + 语言、视觉 + 传感器等广泛模态组合,分析其在目标检测、问答等任务中的应用,并探讨当前挑战与未来方向。
综述由AI生成分享了 AI 智能体多 Agent 协同开发的实战经验。核心观点是将后端架构师与开发智能体拆分,明确职责边界以避免冲突。文章详细列出了架构师、开发及前端三类智能体的核心职责与红线,并提出了架构先行、并行开发、联调闭环的三步协作流程。此外,还补充了任务优先级划分、冲突解决规则及智能体持续调教的方法,旨在提升多 Agent 项目的开发效率与质量。
综述由AI生成介绍基于主成分分析(PCA)的人脸识别技术,即特征脸(Eigenfaces)方法。通过数学原理讲解降维必要性,利用 scikit-learn 和 OpenCV 实现训练与识别流程。实验基于 Olivetti 数据集,可视化特征脸并分析光照、姿态对识别率的影响。文章展示了完整的 Python 代码,包括数据加载、模型训练及最近邻匹配策略,为理解传统人脸识别算法提供实践参考。
综述由AI生成在华为云 ModelArts Studio 上开通 DeepSeek-V3/R1 推理服务的流程,并基于 Flexus X 实例和 CCE 容器引擎分别演示了 Dify 平台的单机与高可用部署方案。内容涵盖前置资源准备、RFS 编排配置、性能监测插件安装及关键指标分析。通过对比两种部署模式在成本、响应时间及可靠性上的差异,建议初创项目采用单机部署,企业核心业务选用 CCE 高可用架构,以实现效率与稳定性的平衡。
介绍 TurboDiffusion 视频生成加速框架的部署与使用方法。涵盖环境准备、WebUI 启动方式、文本生成视频(T2V)及图像生成视频(I2V)的实战操作,并提供参数调优策略与常见问题解决方案。该框架基于 Wan2.1/2.2 模型优化,支持多种显卡配置,旨在降低视频生成门槛,实现秒级生成。
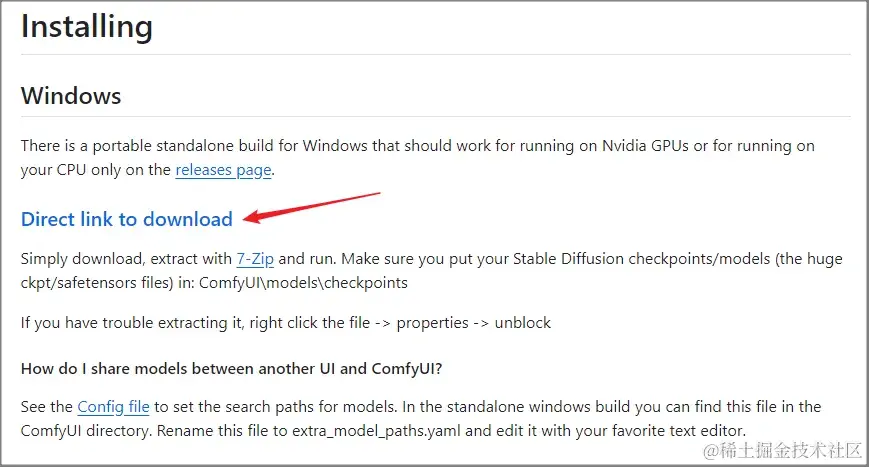
综述由AI生成在 Windows 系统下通过 ComfyUI 本地部署 Stable Diffusion 的完整流程。主要步骤包括下载 ComfyUI 安装包、配置 NVIDIA 显卡运行脚本、下载 SDXL Base、Refiner 及 VAE 模型文件并放置至指定目录。随后在 ComfyUI 界面加载模型,设置提示词(英文)、图像分辨率及采样器参数,最终生成图片。此外还提及了从 Civitai 网站获取更多优化模型的方法。
ComfyUI Photoshop 插件实现 Photoshop 与 ComfyUI 的无缝连接,支持在 PS 环境中直接使用 AI 图像生成与编辑功能。配置需确保 Photoshop CC 2022 以上版本及稳定的 ComfyUI 运行环境。安装步骤包含基础插件部署、管理器组件安装、核心功能搜索及 ControlNet 辅助扩展。支持文本生成图像、智能风格转换、精准缺陷修复及智能画布扩展等应用场景。用户可通过 API 格式保存工作流…
Vitis 开发环境搭建涉及系统配置、工具链安装及 License 授权。记录从 AMD 官网下载统一安装包、注册 WebPACK License 到组件选择的完整流程。重点说明路径设置规范、环境变量初始化及 Hello World 工程验证方法。针对安装卡顿、License 失效等常见问题提供解决方案,并概述裸机控制、软硬协同设计及 HLS 算法加速等后续开发方向,助力 FPGA 与嵌入式开发者快速构建可用环境。
综述由AI生成针对非技术人员难以配置 AI 环境的痛点,介绍了五款开箱即用的 AI 写作镜像方案。涵盖 Qwen-Chat、LLaMA-Factory、ComfyUI-TextFlow、vLLM-Writer 及 FLUX-Creative,分别适用于正式报告、风格定制、复杂任务拆解、长文生成及灵感激发。通过容器化技术实现一键部署,无需命令行操作。结合按需计费模式,大幅降低试错成本,提供参数调优与故障排查指南,助力用户高效完成写作任务。
综述由AI生成使用 Python 进行数据分析与可视化的完整流程。内容包括环境准备(安装 pandas、numpy、matplotlib 等库)、数据处理与清洗(导入 CSV、处理缺失值与异常值、数据转换)、数据分析(描述性统计、分组分析、时间序列分析)以及数据可视化(使用 matplotlib 和 seaborn 绘制柱状图、箱型图、热力图等)。此外,文章还提供了一个销售数据分析的案例研究,涵盖从数据生成、预处理到分析与可视化的完整代码示例,旨在帮…
综述由AI生成无人机航测内业处理涉及 iTwin Capture Modeler 的完整工作流。从硬件配置准备开始,包括 CPU、显卡及内存要求。核心步骤涵盖工程新建、影像导入、两次空三计算(初始对齐与像控点约束)、三维重建及精度检查。文中详细说明了坐标系自定义、刺点操作规范以及 OSGB 模型导出设置。后续结合 Cass 软件进行高程提取与土方算量,并介绍了在线分享模型的通用方案。整个过程注重精度控制与资源管理,适用于测绘工程内业生产。
综述由AI生成详细解析了深度学习模型训练的六个核心步骤:数据预处理、数据选择、神经网络前向传播、损失函数计算、反向传播及优化器参数更新。通过梳理每个步骤的目标、方法、工具及注意事项,并结合 PyTorch 代码示例,帮助读者建立完整的训练流水线认知模型,理解从原始数据到模型收敛的端到端闭环流程。
综述由AI生成对比了 Ollama、llama.cpp 和 vLLM 三大主流大模型推理框架。从架构定位看,Ollama 侧重开箱即用,llama.cpp 追求极致轻量与跨平台,vLLM 面向高吞吐生产服务。文章提供了按场景(本地开发、边缘设备、高并发 API)和硬件环境(CPU、GPU、Apple Silicon)的选型建议,并给出了各框架的快速上手命令示例及常见误区澄清,帮助开发者根据实际需求选择合适的推理方案。