
编程语言AI算法
AI 驱动下的内存市场变革:供需、能耗与安全趋势分析
AI 需求激增导致内存价格大幅上涨,HBM 与 DDR5 成为关键。能源消耗剧增推动算电协同与绿色数据中心建设,CXL 技术优化内存池化效率。同时,内存侧信道攻击风险上升,硬件加密与后量子密码学成为安全重点。行业正经历从单纯容量竞争向能效、安全与架构创新的转型。
AI 需求激增导致内存价格大幅上涨,HBM 与 DDR5 成为关键。能源消耗剧增推动算电协同与绿色数据中心建设,CXL 技术优化内存池化效率。同时,内存侧信道攻击风险上升,硬件加密与后量子密码学成为安全重点。行业正经历从单纯容量竞争向能效、安全与架构创新的转型。
探讨 SQL 查询中 WHERE 子句与 JOIN ON 条件在 INNER JOIN 场景下的性能表现。重点分析索引利用机制,解释为何函数运算会阻碍索引搜索(Index Seek),导致全表扫描(Index Scan)。通过对比代码示例与 B-Tree 索引原理,阐明合理编写筛选条件对提升查询效率的关键作用。
数字时代内容生态由多种生成模式构成。UGC 强调用户自发参与,PGC 侧重专业机构产出,PUGC 融合两者优势。OGC 体现职业属性,MGC 源于机器规则,BGC 服务于品牌营销。AIGC 利用深度学习技术实现内容自动化与个性化,正重塑创作范式。理解这些概念有助于把握内容生产趋势与人机协作的未来方向。
综述由AI生成Android 开发行业进入存量竞争阶段,企业更看重高级技术人才。系统梳理了 Android 进阶学习的八大核心模块,包括 Java 基础深化、主流框架源码解析、性能优化实战、Kotlin 语言强化、UI 开源框架应用、NDK 底层开发、Flutter 跨平台技术及微信小程序开发。内容涵盖泛型、并发编程、JVM 原理、网络库源码分析、崩溃捕获方案、构建优化策略及协程调试技巧。旨在帮助开发者构建完整知识体系,提升解决复杂问题的能力,适应高…
介绍在 Windows 系统下编译 llama.cpp 并部署 Qwen 模型的方法。涵盖 CPU/GPU 编译配置、GGUF 模型下载、API 服务启动及 Python 客户端调用示例。支持多轮对话、上下文记忆及函数工具调用功能,实现本地化大模型应用。
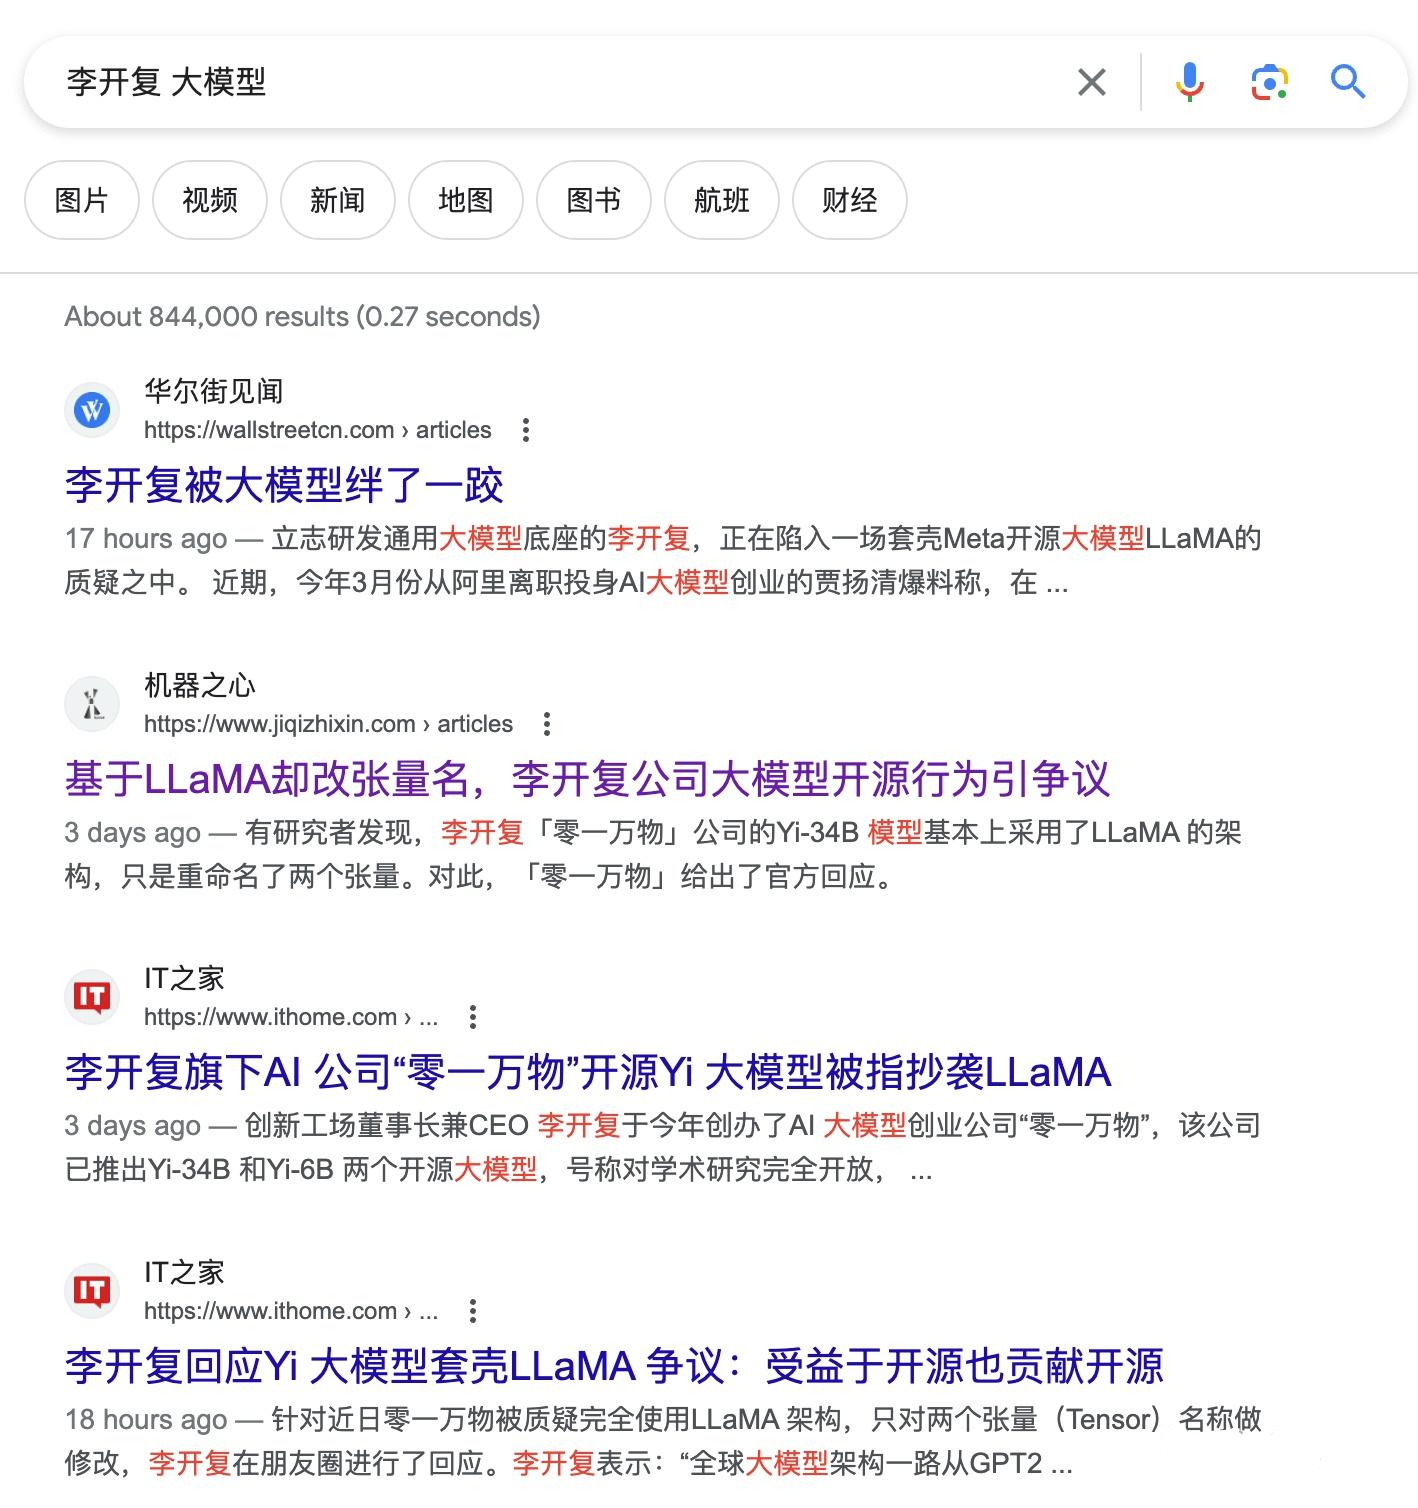
综述由AI生成探讨了以大语言模型 (LLM) 为起点的技术学习路径,重点分析了 Meta 开源的 LLaMA 系列模型。内容涵盖 LLaMA 的架构原理、训练数据来源、基于 Hugging Face Transformers 库的代码推理示例,以及从初阶应用到高阶微调的系统化学习阶段建议,旨在帮助开发者快速掌握大模型核心技术与落地方法。
综述由AI生成Meta 内部 AI Agent 权限失控引发 Sev 1 级事故,暴露上下文压缩导致的安全约束丢失风险。开发者需落实最小权限原则与人机审批机制。AI 编程工具正经历范式转移,Cursor 适合日常辅助,Claude Code 擅长复杂重构任务,配合 CLAUDE.md 可提升规范一致性。Python 3.15 引入 JIT 编译有望显著提升后端性能,降低服务器成本,但需注意启动延迟与内存开销。此外,基于静态站点的去中心化社交实验 Ov…
Rust 结合 WebAssembly 实现高性能计算。文章涵盖 Wasm 基础、Rust 编译工具链(wasm-pack)、JS 交互(wasm-bindgen)、复杂数据类型处理、异步操作及 DOM 操作。通过 Canvas 图像滤镜和 Node.js 数据压缩案例展示实际应用。包含内存管理、类型转换边界检查等常见问题解决方案。适用于浏览器端渲染优化及服务端计算密集型任务。
Python 异步编程实战聚焦于构建高性能网络应用,涵盖 asyncio 事件循环原理、aiohttp 框架架构、异步数据库连接池管理及 WebSocket 实时通信等核心技术。通过同步与异步架构的性能对比数据,展示异步方案在 HTTP 请求、数据库操作及 WebSocket 连接上的显著优势,通常可实现 3 至 10 倍的性能提升。文章包含 API 网关构建、性能优化策略及故障排查指南,为高并发系统设计提供完整的企业级解决方案。
综述由AI生成顺序表是线性表的顺序存储结构,底层基于连续数组。静态与动态顺序表的区别,重点演示了动态顺序表的 C 语言实现,涵盖初始化、尾插、头插及自动增容逻辑。通过三文件协同开发模式,展示了如何管理内存与数据结构,分析了不同操作的效率特点,为后续深入学习链表与算法打下基础。
第六届人工智能与工业技术应用国际学术会议(AIITA 2026)将于 2026 年 4 月 10 日至 12 日在重庆举办。会议由北京理工大学、重庆邮电大学和中国工业互联网研究院联合主办。会议涵盖工业智能算力、数据工程、数据集研究、数据智能及安全应用等主题。优秀论文将获 EI、Scopus、IEEE 收录检索。审稿周期约为投稿后一周。

综述由AI生成探讨了在大模型时代,新手和程序员应如何转型入局。文章分析了大模型的局限性及传统机器学习的优势,强调了夯实基础的重要性。随后提出了包含初阶应用、高阶 RAG 系统、模型训练微调及商业部署四个阶段的详细学习路径,旨在帮助读者建立扎实的技术基础并掌握核心实战技能。
综述由AI生成探讨了从传统手动标注向智能打标转型的必要性及实施路径。针对手动标注成本高、周期长、一致性差等痛点,介绍了利用预训练模型、主动学习等技术实现人机协作的方案。通过 Spring Boot、OpenCV 和 ONNX Runtime 构建 Java 后端智能标注服务,涵盖模型加载、预标注、主动学习策略及闭环训练流程。同时分析了系统架构、质量控制指标及未来大模型驱动趋势,为开发者提供了一套轻量级但功能完整的 AI 数据标注系统实战指南。
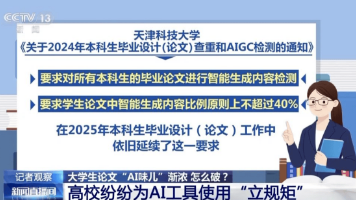
知网 AIGC 检测算法在 2026 年迎来升级,主要变化包括检测维度增加、判定阈值下调及检测范围扩大。新版本不仅分析语言模式,还引入语义逻辑判断,识别更严格的 AI 生成特征。核心指标困惑度与突发性用于衡量文本意外程度与节奏变化,同义词替换难以规避检测。建议通过语义重构、人工微调及避免二次 AI 改写等方式降低 AI 率,不同高校对 AI 率要求通常在 10% 至 30% 之间。
综述由AI生成介绍 AI 大模型 Stream 流式输出的核心原理及实战落地。通过 ChatOpenAI 直接调用和 LangChain LCEL 表达式两种方案,实现故事生成与科普助手的流式响应。分析了流式输出在用户体验、内存占用及中断支持方面的优势,同时指出其无法减少总耗时、增加代码复杂度等限制。提供了 API 密钥安全、流式中断处理及前端展示等避坑指南,帮助开发者在聊天机器人或长文本场景下优化交互体验。
金融 NLP 实战涵盖文本分类、情感分析及风险评估三大场景。文章解析 BERT、GPT-3 等模型在金融文本中的应用,提供基于 Python 的预处理、特征工程与模型训练代码示例。结合 Tkinter 界面开发,展示如何构建具备实时分析能力的金融风控系统,解决术语识别、数据噪声及高实时性挑战,助力开发者快速落地金融智能化应用。
综述由AI生成详细阐述了 AI 产品经理所需的核心技术能力与学习路径。内容涵盖基础算法与机器学习方法的理解、NLP 与 CV 等场景应用、算法与模型关系的辨析。重点介绍了在大模型时代的系统化学习路线,包括提示词工程、RAG 应用及微调技术。同时分析了 AI 产品经理在需求分析、技术选型、数据管理及迭代优化中的具体职责,构建了包含技术视野、市场洞察、沟通协调及数据决策力的能力模型。文章旨在帮助从业者跨越技术鸿沟,有效连接技术与市场,推动 AI 产品落地…
针对 DAMO-YOLO 口罩检测模型,详解如何通过修改 webui.py 实现自定义输入尺寸适配。核心在于预处理阶段的图像缩放与填充策略,以及后处理时的坐标还原逻辑。通过保持宽高比和智能裁剪优化性能,确保不同比例图像下的检测精度与稳定性,解决实际部署中常见的尺寸不匹配问题。
综述由AI生成本文探讨了 NLP 在法律领域的合同分析、文本分类及案例检索等核心场景,介绍了基于 BERT 和 GPT-3 的模型实现方案,并展示了使用 Python 构建合同分析应用的完整流程。内容涵盖数据预处理、模型训练优化及多语言隐私挑战,适合希望将 AI 技术落地法律行业的开发者参考。
清华大学发布的 AIGC 发展研究报告 4.0 的部分节选内容。主要包含报告中的关键数据图表及行业分析,例如智联招聘关于 AI 领域求职人数增长的数据,以及麦肯锡对中国 AI 专业人才需求的预测。原文中包含大量推广资料和引流信息,经清洗后仅保留报告核心观点与数据展示,旨在呈现 AIGC 领域的现状与发展趋势。