

编程语言Agent RuntimeIdempotencyTool RuntimeCheckpointRecovery
《Agent Runtime 工程化》为什么 Tool 必须支持 Idempotency?
为什么 Tool 必须支持 Idempotency? 上一篇讲 retry 时,我留了一个坑: 今天把这个坑填上。 Agent Runtime 里,工具是否幂等,不是一个可有可无的注释。它决定三件事: 如果工具没有幂等语义,Agent 一旦
陈堂会50 浏览0 点赞约 21 分钟阅读
为什么 Tool 必须支持 Idempotency? 上一篇讲 retry 时,我留了一个坑: 今天把这个坑填上。 Agent Runtime 里,工具是否幂等,不是一个可有可无的注释。它决定三件事: 如果工具没有幂等语义,Agent 一旦

LangGraph 到底是不是 Agent Runtime? 这个问题最近很容易吵起来。 有人说 LangGraph 就是 Agent Runtime。 有人说它只是 workflow graph。 也有人说 Runtime 这个词被框架营

能力越大,边界越要清楚。本章谈权限和安全。 Agent 的能力来自工具,风险也来自工具。一个不会调用工具的模型,最多说错话;一个能执行命令、写文件、联网、访问数据库的 Agent,可能造成真实损失。Runtime 的安全目标不是把 Agent 绑住,而是让它在明确边界内做事;越过边界时,停下来请人确认,或者直接拒绝。 安全不是最后加的一层'确认弹窗'。它应该
现在可以动手了。把模型、工具和观察结果接成一个受控循环,这是 Agent Runtime 从'调用一次模型'走向'能执行任务'的第一步。 最小 Agent Loop 不追求复杂。它的目标很朴素:模型能根据当前上下文提出工具调用,runtime 能校验并执行工具,把观察结果写回消息历史,再决定继续还是停止。只要这个闭环清楚,后面的工具治理、上下文预算、权限审批
Agent 迟早要接外部工具,也迟早要面对多个模型供应商。本章讨论怎么接,以及怎么避免 runtime 被某个协议或某个 SDK 绑死。 前面几章里,工具都在本地注册,模型调用也被简化成一个 ModelProvider。这对入门很好,但真实系统不会停在这里。企业内部有文档库、浏览器、数据库、工单系统、设计工具、代码托管平台;模型侧也会同时接 OpenAI、A
这一章开始给工具'上户口'。在 demo 里,工具是几个函数;在 Agent Runtime 里,工具是一套能力治理系统。 模型负责提出'我想调用哪个工具、传什么参数'。Runtime 负责判断这件事是否存在、参数是否合法、风险是否可接受、是否需要用户确认、怎样执行、输出怎样进入上下文、失败怎样反馈。把这些责任都塞进一个 execute() 函数,是很多 A
写 Agent Runtime 之前,先补一门不太体面的课:异步任务、流和进程控制。 Agent Runtime 表面上是在调用模型,实际上是在管理一串可能很慢、会失败、有副作用、需要取消的异步任务。模型请求会流式返回,shell 命令会持续输出,文件系统可能被修改,用户可能中途按下取消,工具可能超时,子进程可能留下孤儿进程。没有扎实的 Node runti
《Agent Runtime 工程化:生产级 AI Agent 架构、运行时与工程实践》 这是一套面向工程师、技术负责人和 AI 产品架构师的 Agent Runtime 工程化读本。全书按章发布,从最小工具调用循环开始,逐步进入工具系统、上下文工程、MCP、权限安全、可恢复执行、trace、eval 和产品级实战。 读者不需要把它当成零散教程。更好的读法是按章推进:先建立

Agent 为什么必须有 Token Budget? 上一篇我们给 Agent Loop 加了 maxSteps。 很多人做到这里,会松一口气:至少 Agent 不会无限跑了。 但只靠 maxSteps,控不住成本,也控不住上下文质量。 原

Agent Memory 越做越乱,本质上是 Runtime 问题 很多 Agent 项目做到第二个月,会开始加 memory。 一开始理由很正当: 然后大家很自然地做了一件事:把对话、文档、工具结果、用户偏好、项目摘要丢进向量库。 前几天
Agent 出错后,最怕只剩一句'模型没做好'。这句话既不能定位问题,也不能指导修复。可观测系统的任务,是把一次 Agent run 拆成可以追踪、可以复盘、可以转化为评测用例的证据链。 OpenTelemetry 的公开文档把 span 视为 trace 的基本操作单元:span 有名称、父 span、开始和结束时间、属性、事件、状态等信息。本书不要求读者

目标:实现可恢复执行。 功能范围: 每轮工具执行前创建 checkpoint; 文件修改保存 patch; 支持恢复文件状态; 支持恢复 session 状态; 进程崩溃后继续 run; 恢复后不重复执行高风险工具。 适合证明: 状态管理; 可恢复执行; 可靠性工程; coding agent 长任
学习 Agent Runtime,第一件事不是选框架,也不是抄一个 tool calling 示例。要先弄清楚:当一个 Agent 从'能回答'走向'能行动',系统到底多承担了哪些责任。 很多团队第一次做 Agent,架构图都很相似:用户输入,调用模型,模型说要用工具,程序执行工具,再把结果塞回模型。这个图没有错,但它太薄。它像把报社写成'记者采访,编辑发稿

如何实现 Agent Checkpoint? 长任务一定会中断。 浏览器刷新。进程崩溃。网络断开。模型请求失败。用户临时离开。工具超时。机器重启。 这些都不稀奇。 真正危险的是:Agent 中断后从头再来。 从头再来听起来只是浪费时间。实际
写一个能演示的 Agent 很快。写一个能稳定跑的 Agent 很慢。慢在三件事上。 第一,模型输出不是普通函数返回值。它可能少字段、多字段、把 JSON 写坏、重复调用工具、误解工具描述,或者在工具失败后编一个像真的观察结果。Runtime 要把模型输出当作不可信输入处理。 第二,工具不是纯计算。
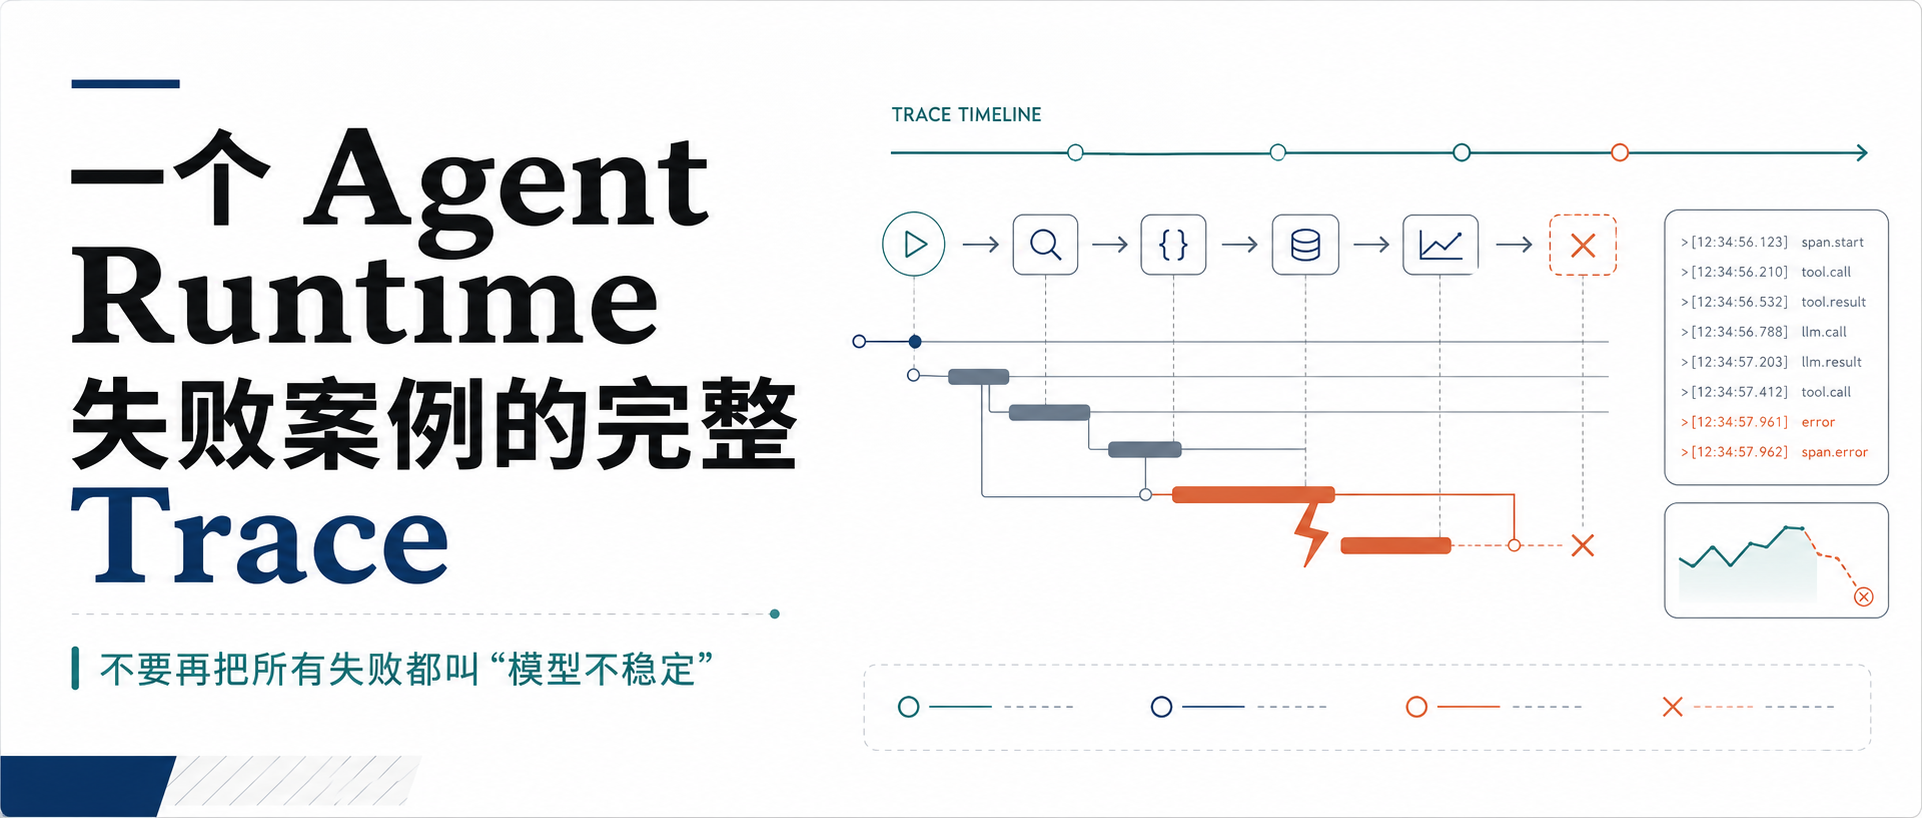
一个 Agent Runtime 失败案例的完整 Trace Agent 出问题后,最没用的一句话是: 它可能是真的。 但它不能指导修复。 如果你只剩聊天记录,确实很容易把问题归到模型身上。模型说它修好了,用户说没修好,日志里只有几段自然语

MCP 解决了什么,又没有解决什么? MCP 很容易被讲成一句话: AI 时代的 USBC。 这个比喻有用,但也有点危险。 它会让人误以为:只要插上 MCP Server,Agent 就自然拥有了一套安全、可靠、可治理的工具系统。 不是。
实现一个 Context Builder: 用户当前消息固定保留; 最近 6 轮完整保留; 旧历史压缩为 summary; 大文件只保留摘要和关键片段; 工具结果按重要度截断; 输出 context debug report。 准备一份 200K token 的模拟历史,压缩进 32K / 64K

最小 runtime 需要四类接口。 第一是 LLM Client。它隐藏不同模型供应商的请求格式,向 runtime 返回统一的 ModelResponse。 第二是 Message Store。它保存用户消息、模型消息、工具调用和工具结果。 第三是 Tool Registry。它告诉模型有哪些工

我为什么写《Agent Runtime 工程化》 过去几天,我连续写了 6 篇关于 Agent Runtime 的文章。 先讲 Demo 为什么上不了生产,再讲 Agent Loop、Harness、Runtime 的边界。然后写 Retr