
PythonAI大前端算法
前端程序员转型大模型工程师的实战指南
综述由AI生成详细阐述了前端程序员转型大模型工程师的系统路径,涵盖数学基础、Python 编程、深度学习框架、Transformer 架构理解及模型微调部署等关键阶段。内容包含具体代码示例与工程化建议,旨在帮助开发者建立完整的技术体系,实现从界面开发到 AI 应用的职业跨越。
综述由AI生成详细阐述了前端程序员转型大模型工程师的系统路径,涵盖数学基础、Python 编程、深度学习框架、Transformer 架构理解及模型微调部署等关键阶段。内容包含具体代码示例与工程化建议,旨在帮助开发者建立完整的技术体系,实现从界面开发到 AI 应用的职业跨越。

分布式训练框架涉及多进程通信、显存优化及异步计算。文章基于 PyTorch 详解分布式环境初始化(init_process_group)、通信算子(all_reduce, broadcast, p2p)及通信组管理。通过蒸馏 Demo 展示数据并行与 Teacher-Student 通信实现。深入讲解 register_hook 在梯度累积中的应用,以及多进程启动模式对 CUDA 初始化的影响。最后介绍 TorchRPC 作为独立于 i…

综述由AI生成详细阐述了人工智能产品经理的系统化学习路线,涵盖基础知识构建、深入技术与工具应用、软技能培养及综合职业规划四个阶段。内容涉及机器学习概论、数据科学入门、深度学习与 NLP 技术、用户体验设计、敏捷项目管理以及大模型时代的商业落地实践。通过理论结合实战任务,帮助读者建立从技术理解到产品落地的完整知识体系,为职业转型或晋升提供明确指引。

综述由AI生成深入解析了大规模多模态模型的核心要素,涵盖数据集分类、应用领域及技术挑战。文章首先介绍了多模态学习的基础概念及其与大语言模型的融合机制,随后详细阐述了通用训练、任务特定及领域特定三大类数据集的特点与代表案例。在应用层面,分析了医疗、自动驾驶、教育及内容创作等场景的实际落地情况。最后探讨了数据偏差、计算成本、可解释性等关键技术瓶颈,并展望了端侧部署与长上下文推理的未来趋势。

综述由AI生成Function Calling 技术通过让大模型输出函数调用请求,实现了与大模型外部工具及业务系统的连接。文章阐述了该机制的定义、工作流程及国产大模型的支持情况,对比了 OpenAI Actions 与 GPTs 的实现差异。内容涵盖代码示例、常见陷阱分析及高级配置建议,旨在帮助开发者构建自然语言驱动的认知系统,解决大模型知识滞后与逻辑幻觉问题,提升实际业务场景中的应用效果。

综述由AI生成详细讲解了在 Windows 系统下安装 Python 解释器及 PyCharm 集成开发环境的完整流程。内容包括从官网下载稳定版本、配置环境变量、验证安装是否成功,以及 PyCharm 的下载、JDK 依赖处理、项目创建与虚拟环境配置。同时提供了常见报错的解决方案,如路径未添加到 PATH 变量等,帮助初学者快速搭建本地 Python 开发环境。
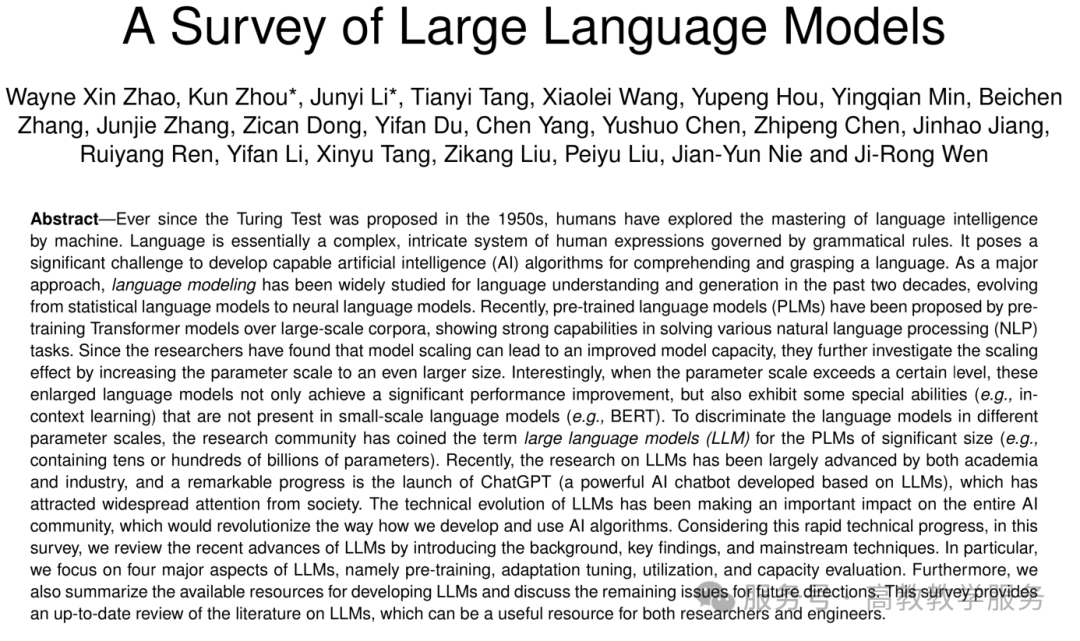
本书由中国人民大学赵鑫教授和文继荣教授领衔编著,基于学术界首篇大语言模型综述文章扩展而成。内容涵盖预训练、微调、对齐、提示工程及评测全流程,结合 LLMBox 工具包与 YuLan 大模型提供实战代码。旨在为读者提供系统性的知识讲解和技术路线图,适合希望深入理解大模型技术的从业人员和研究人员参考学习。
综述由AI生成系统介绍了 Transformer 模型的核心架构与技术细节。内容涵盖编码器与解码器结构、自注意力机制、位置编码、残差连接等基础组件;深入解析了 BERT 模型的双向上下文与预训练策略;探讨了多语言处理、ViT 等变体架构以及预训练微调的工程实践。此外,文章还涉及模型可解释性技术与未来演进方向,为开发者提供从理论到应用的完整技术视角。

综述由AI生成LoRA 是一种参数高效微调技术,通过低秩矩阵更新密集神经网络层,冻结预训练模型参数仅训练少量新增参数,显著降低显存占用与计算成本。它具有可插拔特性,支持跨任务泛化与联邦学习中的隐私保护。综述了 LoRA 的原理、改进变体、混合插件方法、效率优化及在生成即服务、持续预训练和自主代理中的应用前景。
综述由AI生成梳理了大模型技术的系统化学习路径,涵盖理论基础(数学、机器学习、自然语言处理)、实践技能(编程语言、深度学习框架、模型实现)、应用场景及持续学习方法。强调理论、实践与应用三者结合,通过预训练、微调、分布式训练等关键技术点,帮助学习者构建从入门到进阶的知识体系,掌握生成式模型、多模态技术及行业落地能力。内容包含从系统设计、提示词工程到垂直领域微调的七个进阶阶段,旨在提供完整的自学指南。
综述由AI生成深入探讨可解释人工智能(XAI)的核心概念与技术方法。内容涵盖从传统机器学习模型到深度学习及大规模语言模型的可解释性分析,介绍了 SHAP、LIME、Grad-CAM 等主流解释工具的原理与实现。通过医疗、金融等领域的案例,阐述了 XAI 在提升决策透明度、公平性及合规性方面的价值,并探讨了评估指标与未来研究方向。
综述由AI生成检索增强生成(RAG)技术的概念、发展及工作原理,重点阐述了如何利用 Ollama 和 AnythingLLM 搭建本地私有化知识库。内容涵盖 Docker 环境配置、Ollama 模型安装、AnythingLLM 部署流程、数据导入方法及效果验证。文章还提供了常见问题排查与优化建议,帮助用户在保障数据安全的前提下,利用大模型能力处理私有数据,解决知识局限性与幻觉问题。

综述由AI生成人工智能技术发展迅速但面临数据质量与可解释性等挑战。DIKWP 模型提供了从数据处理到智慧决策的系统化理论框架。文章梳理了七阶段大模型学习路径,涵盖系统设计、提示词工程、平台开发、RAG 应用、垂直微调、多模态开发及行业集成,旨在帮助开发者构建全栈 AI 工程能力,解决实际业务需求。
综述由AI生成系统梳理了大模型(Large Language Models)的学习路径,涵盖数学基础、编程语言选择及深度学习框架。重点解析了 Transformer 架构的核心原理,包括自注意力机制与预训练策略。同时介绍了微调技术如 LoRA 及迁移学习方法,并提供了实战项目方向如 RAG 应用与智能体开发。旨在帮助开发者建立完整的技术体系,掌握从理论到工程落地的关键技能。

线性回归、逻辑回归、决策树、朴素贝叶斯、支持向量机、集成学习、K 近邻、K-means、神经网络及深度强化学习(DQN)等十种主流人工智能算法。涵盖各算法的原理、训练方法、优缺点及适用场景,并提供 Python Scikit-learn 或 TensorFlow 代码示例,帮助开发者快速理解核心机制并应用于房价预测、分类、聚类及游戏控制等实际任务。

综述由AI生成使用 Xinference 开源平台在本地部署 Rerank 模型以提升知识库检索效率的方法。内容包括 Xinference 的功能特性、Docker 部署步骤(区分 GPU 与 CPU 环境)、Web 管理界面操作指南,以及如何将 Rerank 模型集成到 Dify 平台中。通过对比开启与不开启 Rerank 的检索效果,验证了本地部署方案在提升召回准确率和降低 API 成本方面的优势,并提供了常见问题排查与性能优化建议。

综述由AI生成针对多模态大模型在复杂视觉推理任务中的幻觉问题,提出了一种基于代码中介翻译(CIT)的多模态数据合成新方法。该方法利用 Python 绘图代码作为图表与文本指令的中介,通过语言模型自动生成包含思维链的高质量图表问答对,构建了 ReachQA 数据集。实验表明,使用 ReachQA 训练能显著提升模型在图表识别、推理及通用数学任务上的表现,且识别与推理能力存在相互制衡关系。研究验证了从纯语言模型蒸馏视觉推理能力的可行性,为低成本构建高质量…
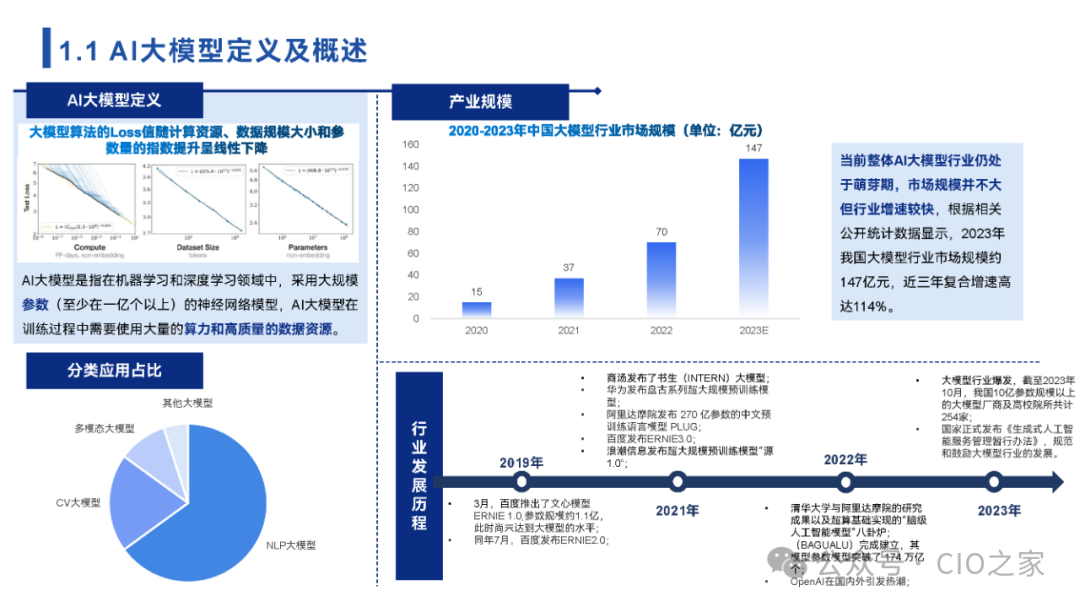
综述由AI生成深度解析了 2024 年中国 AI 大模型行业的发展现状与未来趋势。文章指出行业规模已达 147 亿元,预计 2028 年突破千亿元,并在金融、政府、教育等领域渗透率超 50%。重点阐述了数据价值的三次流转机制,分析了技术卡脖子、数据质量、人才短缺、法规风险及行业认知偏差等六大挑战。同时提出算力国产化、垂直领域大模型及生态协同是未来的主要投资机遇与发展方向,强调政企合作对推动数字经济高质量发展的关键作用。
综述由AI生成详细解析了大模型领域的六大热门岗位,包括模型研发、算法、数据科学、AI 产品、机器学习和深度学习工程师的职责与技能要求。同时提供了系统化的学习路径,涵盖基础语言、Transformer 架构、应用开发框架及垂直微调技术,并附带了基于 Hugging Face 的代码示例。文章旨在帮助程序员明确职业方向,掌握核心技术栈,通过实战项目顺利转型至人工智能领域。

综述由AI生成综述了低秩适应(LoRA)技术在基础模型中的应用。针对大规模模型微调计算成本高的问题,LoRA 通过冻结预训练权重并引入低秩矩阵分解实现参数高效微调。文章系统分析了 LoRA 的技术基础、秩适应策略、训练改进及前沿发展,涵盖持续学习、联邦学习等场景。同时总结了其在 NLP、CV、语音等领域的实际应用,并探讨了理论理解、可扩展性等未来挑战,为相关研究与实践提供参考。