

PythonAI算法
95 后转行 Python 开发:克服阻力实现年薪 18W+ 的求职复盘
综述由AI生成讲述了一位 95 后从业者从电商行业转行 Python 开发的经历。面对家庭阻力和经济压力,他坚持学习并成功入职月薪 15K 的公司。文章分享了面试技巧、简历优化方法以及 Python 学习路线建议,包括 Web 开发、爬虫、数据分析等方向,为想转行的技术人员提供参考。
综述由AI生成讲述了一位 95 后从业者从电商行业转行 Python 开发的经历。面对家庭阻力和经济压力,他坚持学习并成功入职月薪 15K 的公司。文章分享了面试技巧、简历优化方法以及 Python 学习路线建议,包括 Web 开发、爬虫、数据分析等方向,为想转行的技术人员提供参考。
综述由AI生成介绍使用 Python 和 Streamlit 框架构建的股票数据分析系统。系统采用模块化设计,涵盖数据预处理、交易数据分析、技术指标计算及可视化展示。核心功能包括提取股票基本信息、分析交易额排名与趋势、识别价格转折点(局部高点/低点)以及移动平均线分析。通过动态加载模块和代码透明展示,实现了交互式 Web 界面,为金融数据挖掘提供实用参考。

介绍百度 ERNIE-4.5-0.3B 模型的本地化部署流程。基于 PaddlePaddle 和 FastDeploy 框架,在 CUDA 12.6 环境下完成环境搭建、依赖安装及 API 服务启动。文章涵盖系统依赖配置、模型加载优化、API 调用测试及性能基准评估,包括代码生成、逻辑推理、数学优化等场景的实测表现。同时提供知识缓存、动态路由、INT4 量化等企业级性能优化方案及安全加固建议,旨在为中小企业提供低成本、高效率的私有化大模…
深入探讨 Python 数据清洗的核心技术。涵盖缺失值的检测与多种填补策略(均值、中位数、指示变量),单变量及多变量离群值的识别与处理(IQR、Z-score、马氏距离)。介绍特征缩放方法(Min-Max、Z-score、稳健缩放)及分类编码技术(标签、独热、目标编码)。最后解析时间序列数据的特性,包括趋势分解、平稳性检验及滞后特征构建。通过实战案例与代码示例,帮助工程师提升数据预处理质量,为机器学习模型奠定坚实基础。

综述由AI生成本题要求对加密字符串进行解密,规则为字母 A-Z、a-z 分别替换为前驱字符(A 变 Z,a 变 z),非字母字符不变。通过遍历字符串并判断字符范围,利用 ASCII 码运算实现解密逻辑,最终输出还原后的明文。代码使用 C++ 标准库处理输入输出,重点处理了大小写边界情况。

MemClawz 通过三层架构解决 OpenClaw 智能体会话重启后上下文丢失的问题。QMD 提供毫秒级工作记忆,Zvec 实现混合向量与关键词搜索,因果图支持多跳推理。集成过程包含环境配置、服务启动及 AGENTS.md 协议调整,配合自动压缩与备份策略,显著降低延迟并提升检索精度。

综述由AI生成系统梳理了卷积神经网络(CNN)的原理、结构及数学表达,涵盖卷积、池化操作与前向传播流程。通过 MNIST 手写数字分类的 PyTorch 实战案例,展示了模型构建、训练过程及可视化方法。文章还回顾了 CNN 发展历程,对比了 ResNet、DenseNet 等经典变体的架构特点与优劣,并提供了参数调优、正则化及行业应用建议,旨在帮助读者全面掌握 CNN 的核心技术与工程实践。

Python 网络爬虫通过自动化请求与解析技术获取网页数据。介绍核心原理、常用库如 Requests 和 BeautifulSoup 的使用方法,提供完整的 IMDB 电影数据抓取示例,涵盖反爬策略、异常处理及数据存储方案。同时强调遵守 robots.txt 协议与法律合规性,帮助开发者构建稳定高效的数据采集系统。

介绍 LeetCode 第 674 题最长连续递增序列的贪心算法解法。内容包含题目解析、来源说明及测试用例分析,旨在帮助开发者理解如何通过一次遍历找出数组中最长的连续递增子序列长度。
综述由AI生成详细讲解了 Python 中的流程控制核心机制,涵盖 if-else 条件判断、while 与 for 循环结构以及 break、continue 等控制关键字。内容包含关系运算符详解、缩进规范、常见错误排查,并通过猜数字游戏和学生成绩管理系统两个实战案例,演示了如何将理论应用于实际编程。文章还总结了循环选择建议与最佳实践,帮助开发者编写更高效、易读的代码。

综述由AI生成Python 爬虫技术通过发送 HTTP 请求获取网页数据,利用正则表达式解析 HTML 提取歌曲 ID 和标题,进而调用接口下载音频文件。演示了使用 requests 库和 re 模块爬取网易云音乐热歌榜并保存 MP3 的过程,涉及基础爬虫原理、DevTools 抓包分析及合规性注意事项。
综述由AI生成在昇腾 Atlas 800I A2 设备上部署 llama.cpp 的环境配置。硬件包含 KunPeng920 CPU 及 Atlas 910B4 NPU。软件基于 OpenEuler 22.03 LTS,使用 Docker 容器化方案以避免影响物理环境。提供了具体的镜像拉取命令及容器启动参数,涉及 davinci_manager 等设备挂载,适用于 Atlas 300I Duo 及 Ascend 910B4 系列设备。
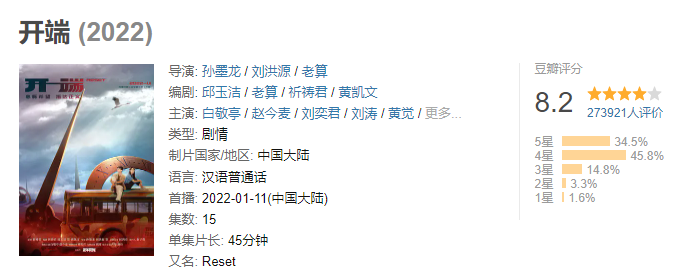
综述由AI生成详细讲解了如何使用 Python 采集电视剧《开端》的弹幕数据并进行词云可视化分析。内容包括环境搭建、网络接口分析、Requests 爬虫代码实现、Pandas 数据清洗、Jieba 中文分词以及 Pyecharts 词云图绘制。文章提供了完整的代码示例,涵盖了从数据获取到最终可视化的全流程,并对反爬策略、数据编码及停用词处理进行了说明,帮助读者掌握弹幕数据挖掘的基本方法。

综述由AI生成探讨了复杂 SQL 查询中的性能瓶颈,特别是高选择性连接条件无法穿透子查询结构的问题。针对传统优化器过滤滞后的缺陷,介绍了一种基于代价模型的连接条件下推方案。该方案通过语义安全校验确保等价性,并结合双路径成本估算进行理性决策,避免盲目下推导致的性能下降。实践表明,该技术能显著减少数据扫描量,在简单及复杂场景下分别实现数百倍至数千倍的性能提升,代表了从规则驱动向代价驱动优化的演进方向。

综述由AI生成通义万相 2.1 在 VBench 榜单表现优异,支持 1080P 无时长限制视频及 4K 图像生成。文章解析其文生图、图生图、局部编辑等核心功能,对比中英文提示词效果差异,并梳理了模型部署时的关键参数配置策略,为开发者提供 AIGC 落地参考。

综述由AI生成本项目构建了一个基于 Python Django 框架、Neo4j 图数据库及 MySQL 的电影知识图谱推荐问答系统。通过整合 Echarts 可视化与协同过滤算法,解决了传统电影信息获取效率低的问题。系统涵盖用户管理、电影详情展示、智能问答及后台管控等功能,利用 UserCF 算法实现精准推荐,结合 Cypher 查询优化图谱分析,提升了用户体验与数据交互效率。

HIL-SERL 是一种结合人类演示与在线学习的样本高效强化学习算法,通过人在环路机制确保真实机器人训练的安全性与效率。本章介绍基于 LeRobot 框架的实践流程,涵盖系统需求配置、工作空间边界设定、演示数据收集与预处理、奖励分类器训练及演员 - 学习者架构部署。重点讲解如何利用遥操作设备干预策略探索,并通过监控工具优化超参数,实现高性能机器人策略的快速训练。

解读《AI 赋能》第六条原则,指出在 AI 时代单一专业深度不足以应对复杂问题。核心竞争力转向跨界组合能力,即结合专业知识、AI 工具与其他学科能力构建新价值链。文章强调知识迁移、工具驱动及系统性思维的重要性,并提出构建'深度 + 广度'复合能力、利用 AI 作为生产力倍增器、建立跨界网络及快速实验迭代等实操路径。最终结论是未来人才需具备深度专业、跨界组合、工具协同与系统思维的复合矩阵,以在智能化浪潮中保持不可替代性。

LangChain 是构建 LLM 应用的流行框架。 LangChain 的安装配置、核心组件(Prompt、Model、VectorStore、Agent)、LCEL 表达式语言以及 RAG 模式实现。内容涵盖 Python 环境搭建、代码示例、常用大模型服务商对比及智谱 AI 实战案例,旨在帮助开发者快速掌握大模型应用开发技能。

综述由AI生成昇腾 NPU 部署 CodeLlama-7b-Python 全流程记录。包含环境配置、模型加载、推理验证及性能评估。基于 HF 镜像加速下载,利用 torch_npu 插件实现 FP16 推理。实测单请求生成速度约 17.5 tokens/s,批处理(batch=4)下总吞吐达 69.71 tokens/s,显存峰值 13.66 GB,验证了国产算力在代码大模型场景的可行性。