

C++算法
二叉树层序遍历算法:BFS 思路与 C++ 实现
综述由AI生成介绍二叉树层序遍历算法,即广度优先搜索(BFS)。核心利用队列实现先进先出访问逻辑,通过记录每层节点数量控制遍历边界。代码展示了如何从根节点开始逐层收集数据,并根据题目要求将结果逆置。包含完整的 C++ 类定义及测试用例。
综述由AI生成介绍二叉树层序遍历算法,即广度优先搜索(BFS)。核心利用队列实现先进先出访问逻辑,通过记录每层节点数量控制遍历边界。代码展示了如何从根节点开始逐层收集数据,并根据题目要求将结果逆置。包含完整的 C++ 类定义及测试用例。

快速排序利用基准值分区,平均时间复杂度 O(n log n),提供 Hoare、挖坑法、前后指针三种递归实现及基于栈的非递归方案。冒泡排序逻辑简单但效率为 O(n²)。通过理论分析与实测对比,明确两种算法在时间与空间开销上的差异,辅助工程场景下的选型决策。

综述由AI生成记录了在 NVIDIA DGX Spark(Grace Blackwell 架构,aarch64,CUDA 13.0)上部署 vLLM 推理服务并接入 Open WebUI 的完整流程。内容包括 FlashAttention 编译、vLLM wheel 安装、Qwen3-Coder-Next-FP8 模型加载、Open WebUI 本地及容器化部署配置、性能实测数据及故障排查指南。所有命令经实测验证,适用于生产环境。

综述由AI生成详细解析了网络安全行业的核心岗位,包括安全产品、运营分析、攻防应急三大方向及其所需技能。内容涵盖网络基础、操作系统、数据库及编程语言的学习顺序,提供了从零基础到进阶的系统化学习路线,旨在帮助初学者明确职业定位并掌握关键安全技术。

综述由AI生成Megatron-LM 是 NVIDIA 开源的大语言模型训练框架,核心在于提供多种分布式并行策略以支持多卡部署。文章深入分析了张量并行、流水并行和数据并行的源码实现。张量并行通过行切分和列切分 Linear 层,结合异步 AllReduce 优化通信与计算重叠;流水并行利用 P2P 通信机制在微批次间传递 Tensor 形状与数据,实现流水线执行;数据并行则通过梯度桶聚合与异步 AllReduce 提升效率。文中还涉及了 Apex 融…

AI 与低代码结合推动开发民主化,解决应用需求与开发产能矛盾。通过大语言模型将自然语言转化为结构化配置,实现从拖拽到对话的转变。受益者包括初创团队、大型企业及公民开发者,但也面临数据安全、技术债务和厂商锁定风险。未来开发模式将向极简 AI 代理与增强型专业 IDE 两极分化,低代码进化为智能代码翻译器。

综述由AI生成人工智能生成内容(AIGC)的概念、与大模型的关系及行业影响,涵盖文本、图像、语音、视频等应用场景。通过 DeepSeek、文心一言、讯飞智文等工具案例,演示了提示词技巧、文档处理、PPT 生成及编程辅助等实践方法,并探讨了 AI 搜索与智能办公的未来趋势,为读者提供 AIGC 技术认知与操作指南。

综述由AI生成MySQL 数据类型选型直接影响存储效率与数据准确性。通过实战测试解析了数值、字符串、日期及特殊类型的核心差异。重点指出金额计算必须使用 DECIMAL 避免精度丢失,CHAR 与 VARCHAR 的空间与效率权衡,以及 TIMESTAMP 的 2038 年限制风险。遵循最小必要原则,根据业务场景匹配合适类型,能有效规避溢出、截断及性能瓶颈问题。

综述由AI生成探讨了人工智能大模型面临的核心安全风险与隐私威胁,包括对抗攻击、恶意生成、数据泄露等。详细介绍了全链路安全防护技术,涵盖输入验证、模型加固(对抗训练、水印、加密)、输出审查及部署环境安全。同时阐述了差分隐私、联邦学习、同态加密等隐私保护核心技术的应用,并结合金融场景实战案例,分析了合规要求与落地实践,为构建安全可信的大模型系统提供系统性解决方案。

综述由AI生成围绕 Llama 3 发布引发的开源与闭源之争展开,探讨了开源模型的定义、价值及与闭源模型的光谱关系。文章分析了大模型时代的开源现状,指出开源与闭源正齐头并进而非绝对对立。内容涵盖模型训练流程(SFT、继续预训练)、算力要求、模型魔改方法(量化、融合)以及未来趋势判断。核心观点认为开源降低了技术门槛,推动了推理成本下降,而未来的竞争将转向差异化应用场景而非单纯的能力比拼。

综述由AI生成LLaMA-Factory 是一款统一高效的百种语言模型微调框架,支持 LoRA、QLoRA 等参数高效微调策略及 SFT、DPO 等多种训练阶段。该工具提供 WebUI、CLI 和 Python API 三种交互方式,内置丰富数据集模板,支持百川、千问、LLaMA 等主流模型。通过可视化的操作流程和标准化的数据配置,显著降低了大模型微调的技术门槛,适用于快速构建垂直领域模型。

单链表操作涉及删除指定值、整体反转及定位中间节点三大核心场景。删除操作可通过尾插法构建新链表实现;反转链表利用三指针迭代调整 next 指向;查找中间节点则依赖快慢指针技巧。掌握这些基础逻辑有助于提升指针运用能力,为后续数据结构学习打下坚实基础。
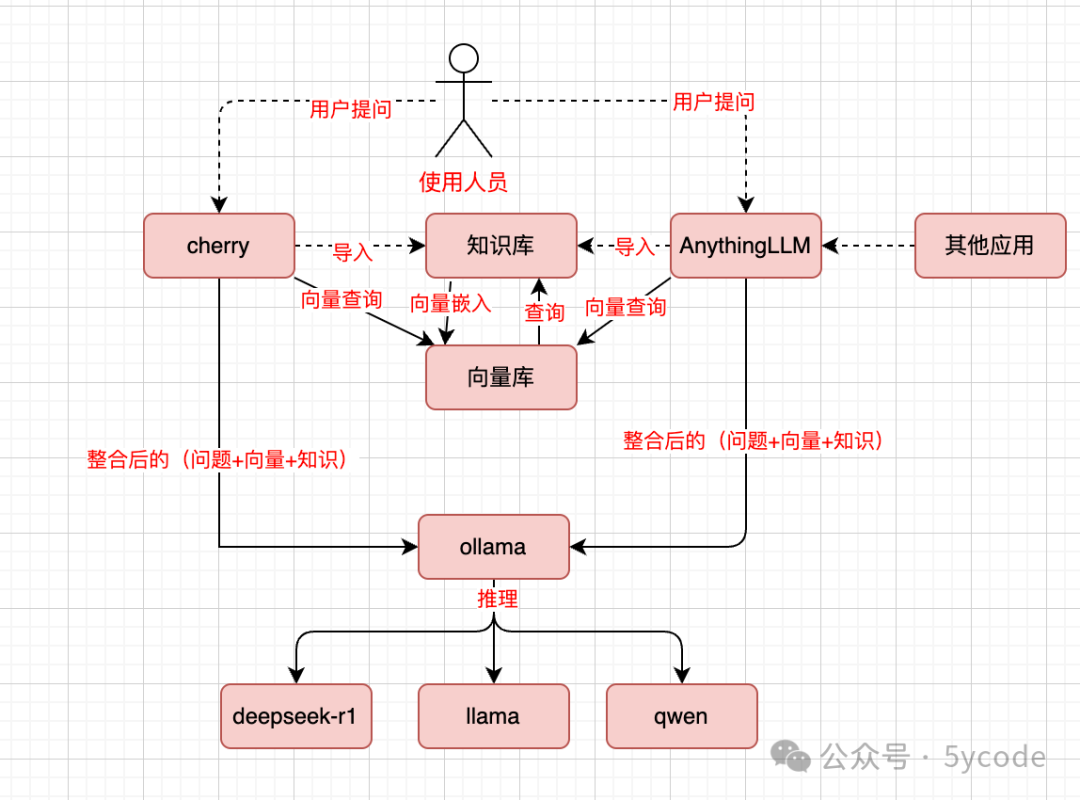
综述由AI生成基于 DeepSeek 大模型与本地知识库(RAG)的搭建方案。主要涵盖两种主流工具:Cherry Studio 与 AnythingLLM。文章首先阐述了数据流程,包括文档解析、向量化处理及检索增强生成机制。随后分步讲解了 Ollama 环境配置、嵌入模型 bge-m3 的拉取、以及两款软件的具体安装与设置流程。重点对比了两者的优缺点,指出 Cherry Studio 更适合个人快速上手,而 AnythingLLM 具备更强的工程化能…

DGX Spark 部署 vLLM 与 Open WebUI 运行 Qwen3-Coder-Next-FP8(CUDA 13.0)。记录在 NVIDIA DGX Spark(Grace Blackwell 架构)上部署 vLLM 推理服务并接入 Open WebUI 的完整流程。包含 FlashAttention 编译、vLLM wheel 安装、模型加载等关键步骤,适配 aarch64 + CUDA 13.0 环境。提供单机与容器化部…

综述由AI生成视觉语言模型(VLM)连接视觉与语言,是人工智能交互的关键。综述了 VLM 的四大训练范式:对比学习、掩码目标、生成式及基于预训练主干的方法。详细探讨了数据筛选、软件工具选择及超参数调整等训练指导,并深入分析了定位能力、对齐能力及富文本理解等提升技巧。此外,文章还涵盖了负责任评估方法,包括偏差检测、幻觉评估及红队测试,并展望了向视频领域扩展的挑战与机遇。

介绍如何使用 Nanobot 结合 vLLM 部署智能 QQ 聊天机器人。首先准备硬件软件环境,包括 Python 3.11+ 及 NVIDIA GPU。接着在云端或本地部署 vLLM 服务以提供大模型推理能力。随后在 QQ 开放平台创建机器人获取配置信息。安装 Nanobot 框架后,修改配置文件连接 vLLM 接口及 QQ 账号凭证。最后启动网关服务即可实现基于大模型的自动回复功能。该方案利用 vLLM 优化推理速度,Nanobot…

综述由AI生成滑动窗口算法常用于解决连续子数组问题。针对 LeetCode 1004 题(最大连续 1 的个数 III)和 1658 题(将 x 减到 0 的最小操作数),演示了如何利用双指针维护窗口内约束条件。第一题核心在于统计窗口内 0 的数量不超过 k;第二题通过逆向思维转化为寻找和为总和减去 x 的最长子数组。代码实现采用 C++,包含详细的逻辑步骤与边界处理。

综述由AI生成实测了百度文心大模型 4.5 系列开源版本,涵盖 0.3B 至 47B 激活参数多模态模型。通过 FastDeploy 在 A800 环境下完成部署,测试了逻辑推理、数学计算及图像理解能力。结果显示,A47B 分支在多模态复杂任务上表现优异,A3B 在文本场景平衡了效率与效果,0.3B 适合资源受限环境。量化技术显著降低显存占用,Apache 2.0 协议利于商业落地。整体生态完善,适合企业级应用与边缘部署。

具身机器人软件系统通过分层架构实现感知决策执行闭环。感知层整合多传感器数据与环境建模,认知决策层负责任务规划与动态决策,运动控制层确保高精度执行。支撑架构涵盖通信驱动与管理层以保障稳定。设计遵循模块化实时性原则,未来趋势包括端云协同与 AI 原生架构演进。

综述由AI生成队列(Queue)这一基础数据结构,涵盖先进先出(FIFO)原则及基本操作。详细讲解了顺序队列、链式队列、双端队列(Deque)以及循环队列的两种实现方式(顺序与链式),并提供了完整的 C++ 代码示例。此外,还探讨了队列在任务调度、BFS 等场景的应用,并推荐了力扣上的经典算法题,如用栈实现队列、滑动窗口最大值及合并 K 个升序链表,帮助读者深入理解队列相关算法。