
C++算法
C++ 中实现随机数的方法
综述由AI生成C++ 中使用 rand() 和 srand() 函数生成伪随机数的方法。rand() 函数返回 0 到 RAND_MAX 之间的值,需配合 srand() 初始化种子以避免序列重复。由于 RAND_MAX 的限制,直接取模可能不适用于大范围数值,文章提供了通过除法扩大范围及多次随机提高精度的方案。内容涵盖生成 [0,n] 和 [n,m] 区间随机数的代码示例,以及完整的程序实例演示。
综述由AI生成C++ 中使用 rand() 和 srand() 函数生成伪随机数的方法。rand() 函数返回 0 到 RAND_MAX 之间的值,需配合 srand() 初始化种子以避免序列重复。由于 RAND_MAX 的限制,直接取模可能不适用于大范围数值,文章提供了通过除法扩大范围及多次随机提高精度的方案。内容涵盖生成 [0,n] 和 [n,m] 区间随机数的代码示例,以及完整的程序实例演示。
综述由AI生成Transformer 分词算法是自然语言处理的基础技术,主流方法包括 BPE、WordPiece 和 SentencePiece。子词分词通过拆分单词为更小的单元,有效解决词汇表过大及未见词处理问题。文章解析了各算法原理,并演示了使用 tokenizers 库训练分词器的流程,涵盖 BPE 与 WordPiece 的具体实现步骤。
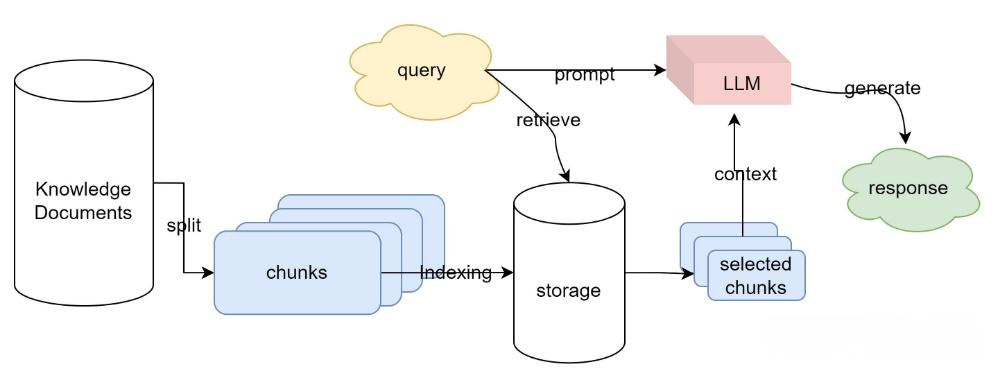
RAG(检索增强生成)通过检索外部知识库补充 LLM 上下文,解决预训练数据时效性与垂直知识缺失问题。核心流程包括文档切分、向量化索引、检索匹配及生成回答。优化策略涵盖 Query 改写、混合搜索、父子索引、Rerank 及元数据增强等。评估体系包含检索质量指标(MRR、Hits Rate、NDCG)及生成质量维度(鲁棒性、信息融合等)。 RAG 基础架构、进阶优化方案及评估标准,适用于希望深入理解大模型检索增强技术的开发者。
OpenVLA 视觉 - 语言 - 动作模型在机器人端的量化、推理与微调流程详解。涵盖 INT4/FP8/FP16 精度测试,基于 Jetson AGX Orin 的容器化部署,以及利用 MimicGen 生成合成数据进行 LoRA 和全量微调。通过 BridgeData V2 数据集验证量化效果,结合 Agent Studio 仿真环境评估任务成功率,最终实现约 85% 的积木堆叠任务准确率。提供从数据转换到在线验证的完整实操方案。

综述由AI生成AI 智能体(Agent)是能够感知环境、决策并行动的人工智能实体。基于 SAE 自动驾驶分级理念,将 AI 智能体划分为 L0 至 L5 五个能力层级。从仅具备工具能力的无 AI 状态,到基于规则、模仿学习、强化学习,再到引入大语言模型(LLM)、记忆反思模块及自主学习,直至实现超人类协作与情感交互。文章详细解析了各层级的技术手段、性能表现及适用场景,探讨了从任务自动化向复杂自主系统演进的技术路径与挑战,包括架构演变、记忆机制引入及实…
2025 AI Index Report 指出 AI 已从技术突破期进入系统扩散期。报告涵盖研发、技术表现、负责任 AI、经济、科学医疗、政策治理及教育等八大领域。核心发现包括产业界主导模型研发、中美竞争格局复杂化、训练成本上升而使用成本下降、开源与闭源差距缩小、以及治理滞后于技术发展。AI 价值正从概念验证转向实际业务渗透,科学与医疗成为高价值落地场景。社会态度呈现乐观与信任缺失并存的特征,未来竞争将体现为系统能力与国家基础设施的综合…
移动云 AIGC 大赛面向公众征集智能新空间创意作品,涵盖智慧城市、数字生活等十大主题。参赛者需在截止日期前提交作品至官方邮箱,经评审后选出优秀作品给予云电脑权限及大会展示机会等奖励。
VSCode 集成大模型功能可通过安装插件实现。支持智谱 GLM-4 官方插件,通过设置 API Key 和模型名称即可启用对话与代码补全。通用方案允许配置任意大模型 API 端点,结合 Authorization 头进行认证。本地部署推荐使用 Ollama 扩展,启动服务后选择模型如 llama3。性能优化涉及温度、最大令牌数等参数调整。多模型切换可通过配置文件管理不同环境。常见问题包括网络代理、API 配额及显存占用检查。开发者可使…
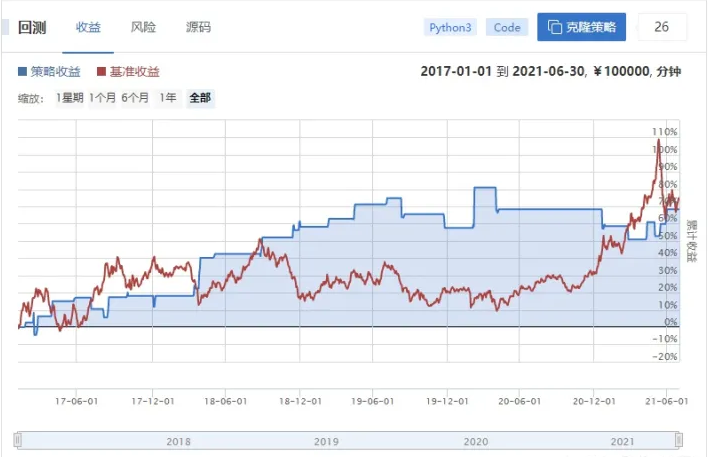
综述由AI生成金融数据分析中,Python 凭借生态丰富、易学及接口拓展性强等优势成为首选,R 语言亦适用但市场热度稍逊,SQL 则是必备的数据查询技能。文章阐述了 Python 在量化策略实现、Jupyter 可视化展示、复杂金融算法编写(如期权定价)以及多源数据接入(如 Tushare、Wind)方面的应用,并介绍了 Ta-lib、Quanlib 等第三方库的支持情况。
综述由AI生成网络爬虫是一种自动化程序,用于在互联网上浏览和提取信息。爬虫的定义、工作流程、应用场景及主要价值,并区分了通用爬虫与聚焦爬虫两种类型。此外,补充了基于 Python 的基础实现示例,强调在合法合规的前提下使用爬虫技术,遵守网站隐私政策与 Robots 协议,确保数据安全与责任使用。
综述由AI生成探讨在超大规模集群中训练大语言模型的核心挑战与解决方案。重点分析了数据并行(DP)、张量并行(TP)和流水并行(PP)的混合策略,以及通信与计算重叠技术对提升效率的作用。介绍了上下文并行(CP)解决长文本显存限制的方法,结合 GQA 优化通信开销。阐述了基于 GEMM Last 的重计算策略和内存换显存的流水线感知卸载方案,显著降低显存占用并提升吞吐量。最后通过成本模型指导参数配置,展望了万亿参数 MoE、超长序列及低精度训练等未来方向…
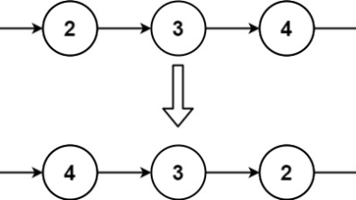
综述由AI生成介绍 C++ 链表的数据结构与实现,包括头插尾插、查找删除等操作。分析了链表内存占用与访问效率的优缺点。结合 LeetCode 经典题目,演示了反转链表、删除倒数第 N 个节点、合并有序链表、检测环、求交点及节点交换等算法,重点讲解双指针与快慢指针的应用场景及时间复杂度。
二叉树中的最大路径和问题要求找到任意节点序列的最大累加和。核心解法采用深度优先搜索(DFS),需区分两类路径和:以当前节点为顶点的完整路径和用于更新全局最大值,以及向父节点返回的单一路径贡献值。递归过程中若子树贡献为负则舍弃,初始化全局最大值需为负无穷以兼容全负数场景。代码实现基于 TypeScript,通过递归遍历计算左右子树贡献并维护全局最优解。
对比传统 ROS 开发与基于 8MAV 平台的现代工作流,无人机集群控制项目的效率差异显著。分析涵盖环境配置、调试流程、通信链路及可视化界面搭建四个维度。预置环境、内置仿真器及标准化通信模块大幅缩短原型开发周期,实测整体效率提升约 10 至 17 倍。核心优势在于动态任务分配算法集成与分布式架构的快速组网能力,适合需要快速验证想法的团队参考。
在本地低显存环境下部署 Flux 图像生成模型,利用 float8 量化与 CPU 卸载技术,仅需 6–8GB 显存即可运行。流程涵盖环境检查、依赖安装、脚本配置及服务启动,支持 SSH 隧道远程访问。通过优化推理精度与显存管理,解决常见报错,实现开箱即用的 AI 绘画体验。
PCB 设计传统流程耗时且复杂,AI 技术集成至 PADS 软件后带来效率革命。主要功能包括智能自动布线算法优化路径;元件布局建议引擎综合考虑散热与 EMI;实时设计规则检查预防潜在风险;历史设计模式学习提供优化方案。系统无缝集成于界面,显著缩短设计周期,但创意性布局仍需人工审核。
综述由AI生成基于 Rasa 框架构建跨境电商智能客服系统的实践。涵盖技术选型对比(Rasa vs ChatterBot)、核心模块实现(多语言 NLU、Action Server 对接电商 API、对话状态管理)、性能优化(Locust 压测、Redis 消息队列)以及常见问题处理(语料清洗、WebSocket 保活)。最后探讨了结合 LLM 增强语义理解的混合架构方向。系统上线后自动处理约 70% 常见咨询,显著提升响应效率。
综述由AI生成详细解析了大型语言模型(LLM)的核心架构,涵盖 GPT 模型的基本原理与 Transformer 架构的关键组件。内容从神经网络基础出发,逐步推导至注意力机制、前馈网络及位置编码的实现细节,并对比了编码器与解码器在序列生成任务中的不同作用。通过矩阵运算与统计概念补充,帮助读者理解模型底层逻辑,为掌握大模型开发与应用奠定理论基础。
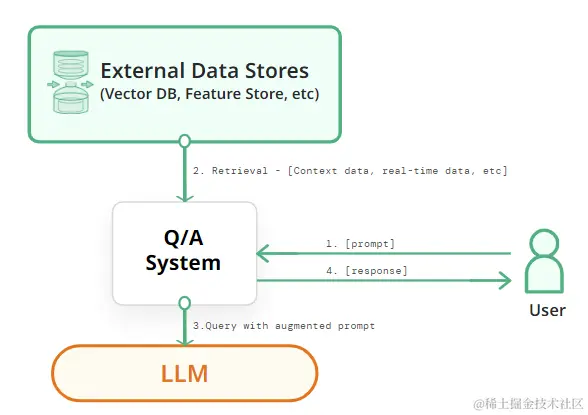
综述由AI生成详细阐述了大模型幻觉问题的成因及解决方案,重点介绍了检索增强生成(RAG)技术的原理与架构。内容涵盖幻觉定义、减少幻觉的策略、RAG 的工作流程、主流检索技术(如 BM25、向量检索)、向量数据库选型以及基于 LangChain 的代码实现示例。此外,文章还补充了查询重写、重排序和多跳检索等高级优化策略,为开发者构建低幻觉、高准确率的 AI 应用提供了完整的技术路径和实践指导。
综述由AI生成Pandas DataFrame 提供了多种统计与累积计算方法。count 用于统计非空值数量,支持按行或列计算;cov 计算列间协方差矩阵,处理缺失值并可选自由度调整;cummax、cummin 分别计算累积最大值和最小值,可忽略缺失值;cumprod 计算累积乘积。这些方法常用于数据清洗、时间序列分析及特征工程,帮助快速理解数据分布与趋势变化。