
JavaScriptNode.js算法
Math.js 数学公式库安装与使用指南
Math.js 是 JavaScript 和 Node.js 的扩展数学库,提供灵活的表达式解析器,支持数字、大数值、复数、单位、数组和矩阵。涵盖安装方法、静态函数使用、字符串表达式求值、链式操作、矩阵操作及配置项说明,帮助开发者快速集成数学计算功能。
Math.js 是 JavaScript 和 Node.js 的扩展数学库,提供灵活的表达式解析器,支持数字、大数值、复数、单位、数组和矩阵。涵盖安装方法、静态函数使用、字符串表达式求值、链式操作、矩阵操作及配置项说明,帮助开发者快速集成数学计算功能。
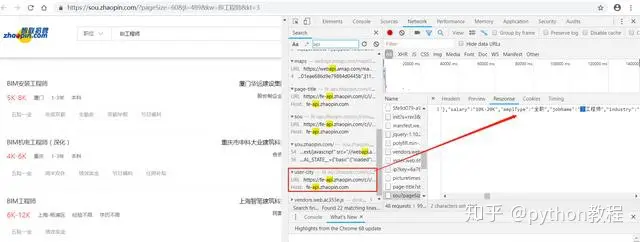
通过 Python 爬取智联招聘 BI 工程师岗位数据,利用 FineBI 进行数据清洗与可视化分析。内容包括数据采集、薪水区间分割、脏数据过滤、城市信息提取及多维度图表展示。分析结果显示 BI 岗位需求集中在一线城市,薪资随经验增长,本科大专为主要学历要求,部分高薪岗位可达 30K-40K。
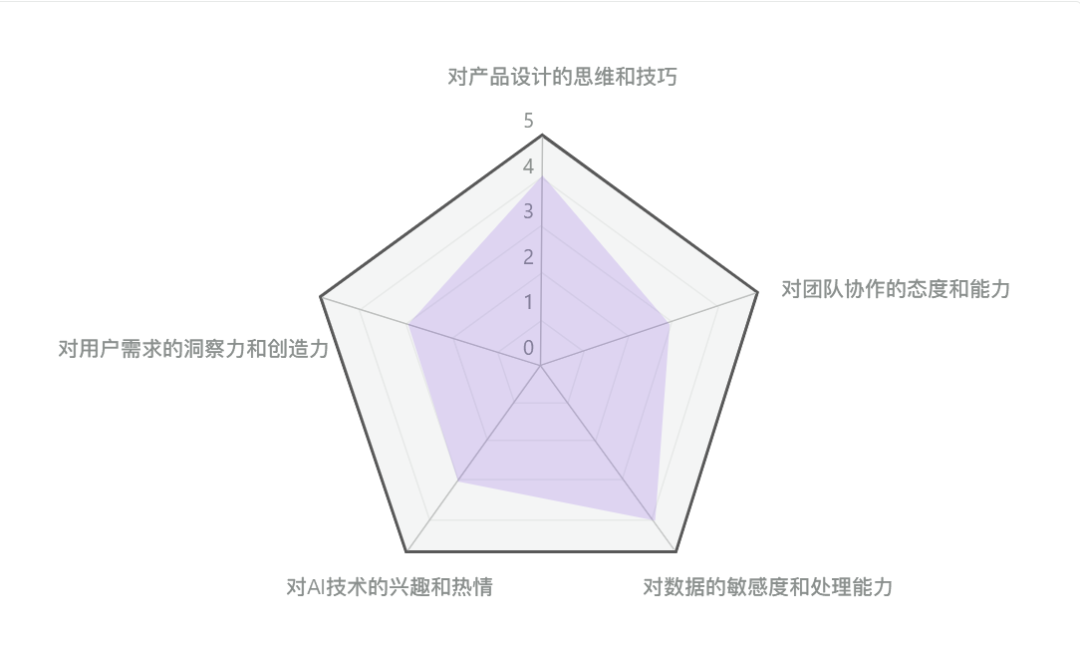
综述由AI生成详细阐述了大模型产品经理转行的核心技能要求、自我评估维度、系统学习路径及实战场景挖掘方法。内容涵盖 Transformer 原理、Prompt Engineering、RAG 架构、LangChain 框架等技术知识点,同时分析了行业应用案例与团队协作策略。文章强调了对 AI 技术的深入理解、数据洞察力及用户同理心的重要性,并提供了具体的学习资源与实践建议,旨在帮助从业者把握大模型时代的机遇,应对技术与伦理挑战,实现从传统产品向 AI…
综述由AI生成Llama-Factory 是一个开源大模型微调框架,支持 Qwen、ChatGLM 等多种主流模型。它通过模块化架构实现从数据加载到模型部署的全链路自动化,整合了 LoRA 与 QLoRA 技术以降低显存需求。提供命令行与 WebUI 两种交互方式,支持 DeepSpeed 等分布式训练方案,并内置数据预处理与权重导出功能,旨在降低大模型微调门槛,使其成为标准化的工程工序。
综述由AI生成介绍基于 Python 的实时快递物流跟踪爬虫系统。针对高并发、反爬及数据解析复杂等挑战,采用 aiohttp+asyncio 实现异步并发,结合 Playwright 模拟浏览器进行智能解析,并使用 SQLAlchemy+PostgreSQL 管理数据。文章还展示了项目结构设计与代理池轮换机制,旨在构建高效稳定的自动化抓取方案。
C++ STL list 基于双向循环链表实现,提供双向迭代器支持,适合频繁插入删除但无随机访问需求的场景。文章解析 list 构造、迭代器分类及 sort 机制,对比其与 vector 的内存与性能差异,并通过手写代码演示节点管理、迭代器封装及核心接口(push_back、erase 等)的实现细节,涵盖深拷贝控制与析构逻辑。
综述由AI生成结构化通过明确规则对信息进行组织,提升检索与分析效率。在 AIGC 领域,ChatGPT 利用结构化原则实现高效信息管理。有序规则将杂乱数据转化为逻辑信息,如字典排序、交通信号灯。现代科技中,结构化支持大数据处理、机器学习及数据挖掘。文章探讨了结构化定义、规则重要性及实际应用,并提供了基于 Python 的 AI Agent 代码示例,展示如何通过编程调用大模型进行任务处理。
综述由AI生成C++ 入门涉及历史渊源、标准制定及版本演进。文章梳理了 C++ 在操作系统、游戏引擎等领域的广泛应用,并对比了其与 Java 的学习难度。针对初学者,提供了 STL 源码剖析等经典书籍推荐及笔记总结建议,帮助建立扎实的基础。
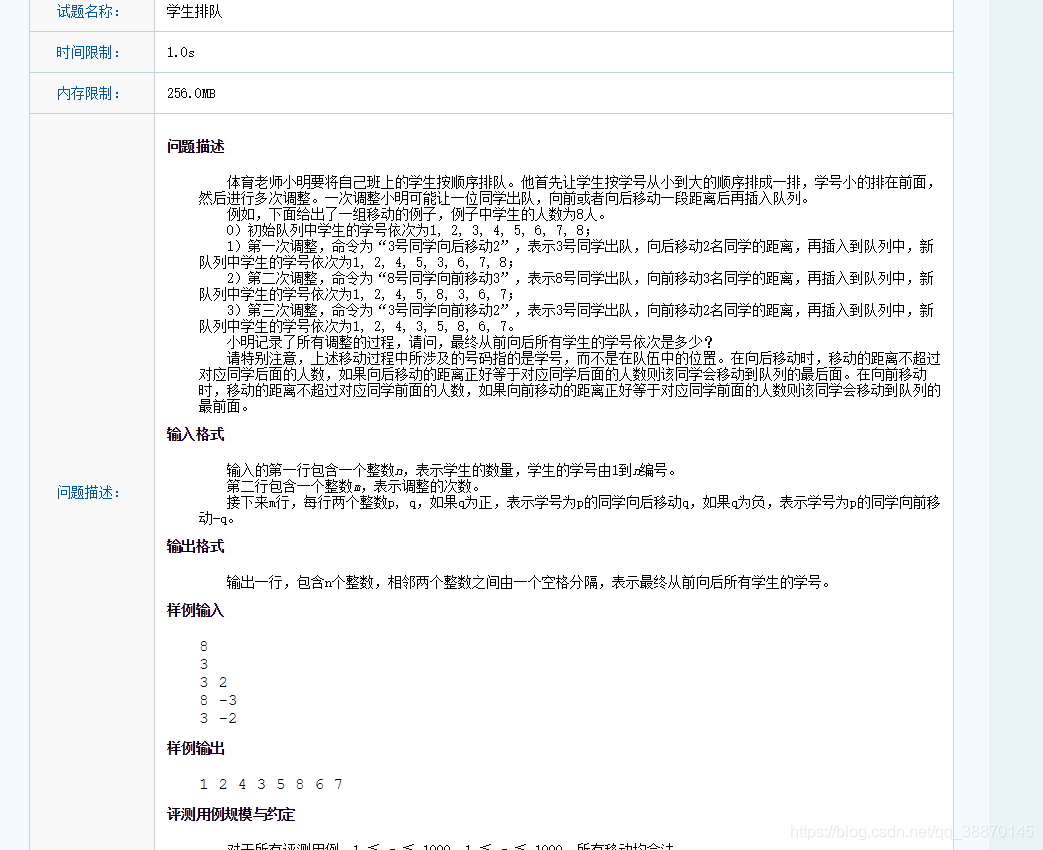
综述由AI生成CSP 考试中常遇到动态排队场景,使用 std::vector 替代静态数组可自动管理内存并适应人数变化。展示了基于 vector 的插入、删除及查询操作实现,重点讲解了中间操作对性能的影响及边界检查的重要性,帮助开发者在算法竞赛中高效解决此类动态序列问题。
Java 中 for(;;) 和 while(true) 无限循环在字节码层面完全一致,均编译为 goto 指令。JIT 编译器无法区分两者,生成的机器码相同。通过 JMH 基准测试验证,两者在实际运行性能上无统计学显著差异。实际开发中建议根据团队规范选择,while(true) 语义更直观。
Java 语言在 LeetCode 上的高频算法题目,涵盖排序(快速、堆、归并)、查找(二分、中位数)、数据结构(链表、树)、算法思想(动态规划、贪心、回溯、DFS/BFS)及数组字符串技巧。通过步骤解析与核心要点总结,帮助读者掌握常见解题思路与优化方案,适用于面试准备与算法能力提升。
YOLO12 目标检测 WebUI 快速部署实战指南。通过 Shell 脚本完成环境初始化与依赖安装,利用 Supervisor 管理后台服务进程。提供 Web 拖拽上传与 RESTful API 两种交互方式,支持 COCO 80 类物体识别。常见问题涵盖模型切换、阈值调整及端口冲突处理,适合集成至实际业务场景。
综述由AI生成梳理了百度文心一言、阿里通义千问、腾讯混元、华为盘古、字节豆包、讯飞星火、知乎知海图、昆仑天工、麒麟合盛天燕、360 智脑、网易玉言及京东言犀等 12 家国内互联网企业的 AI 大模型。涵盖多模态处理、自然语言理解、垂直行业应用等能力,展示了各厂在基础研究与场景落地方面的布局与进展。
Stable Diffusion 本地部署面临硬件门槛高、环境配置难、协作效率低等问题。云端协作通过算力集中调度、环境统一管理、数据实时同步及服务对外开放解决痛点。盘点五种方案:基于 ComfyUI 的节点式工作流协作、RunDiffusion 团队版 WebUI 兼容方案、InvokeAI 专业创意工具、TensorArt 国内优化版及自建 Kubernetes 集群高级选项。不同规模社团可根据技术能力与需求选择合适平台,将技术复杂性…
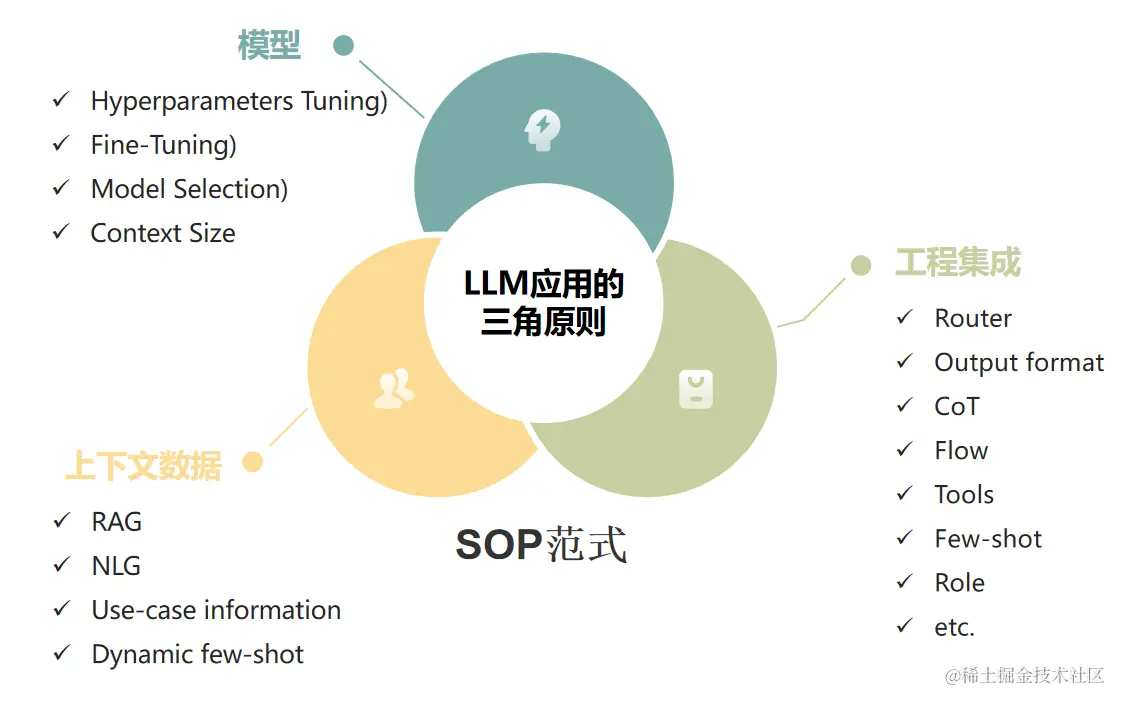
综述由AI生成阐述了构建 LLM 应用的三角原则,涵盖标准操作程序(SOP)、工程集成、模型选择及上下文数据四大核心要素。通过认知建模制定 SOP,利用工作流和 Agents 进行工程集成,权衡模型性能与成本,并结合 RAG 等技术优化上下文,旨在帮助开发者建立健壮可靠的 LLM 本地应用框架,实现从概念验证到生产环境的平稳过渡。
综述由AI生成AI 大模型 40 年发展历程回顾从 1986 年反向传播算法提出至今,经历了早期探索、深度学习复兴到大模型时代。架构从感知机演进至 Transformer 及多模态混合架构,参数规模指数增长遵循缩放定律。应用覆盖 NLP、CV、金融、医疗等多领域。未来趋势指向多模态统一架构与类人智能,面临算力、数据对齐等挑战,呈现大同小异格局。
Python 使用 requests 和 pandas 模块完成数据采集与 Excel 存储。通过 requests 发送 HTTP 请求获取图片及 API 数据,解析响应内容。利用 pandas 创建 DataFrame 对象,将结构化数据导出为 Excel 文件。教程涵盖库安装、代码实现及案例演示,适合初学者掌握网络爬虫与数据处理基础技能。
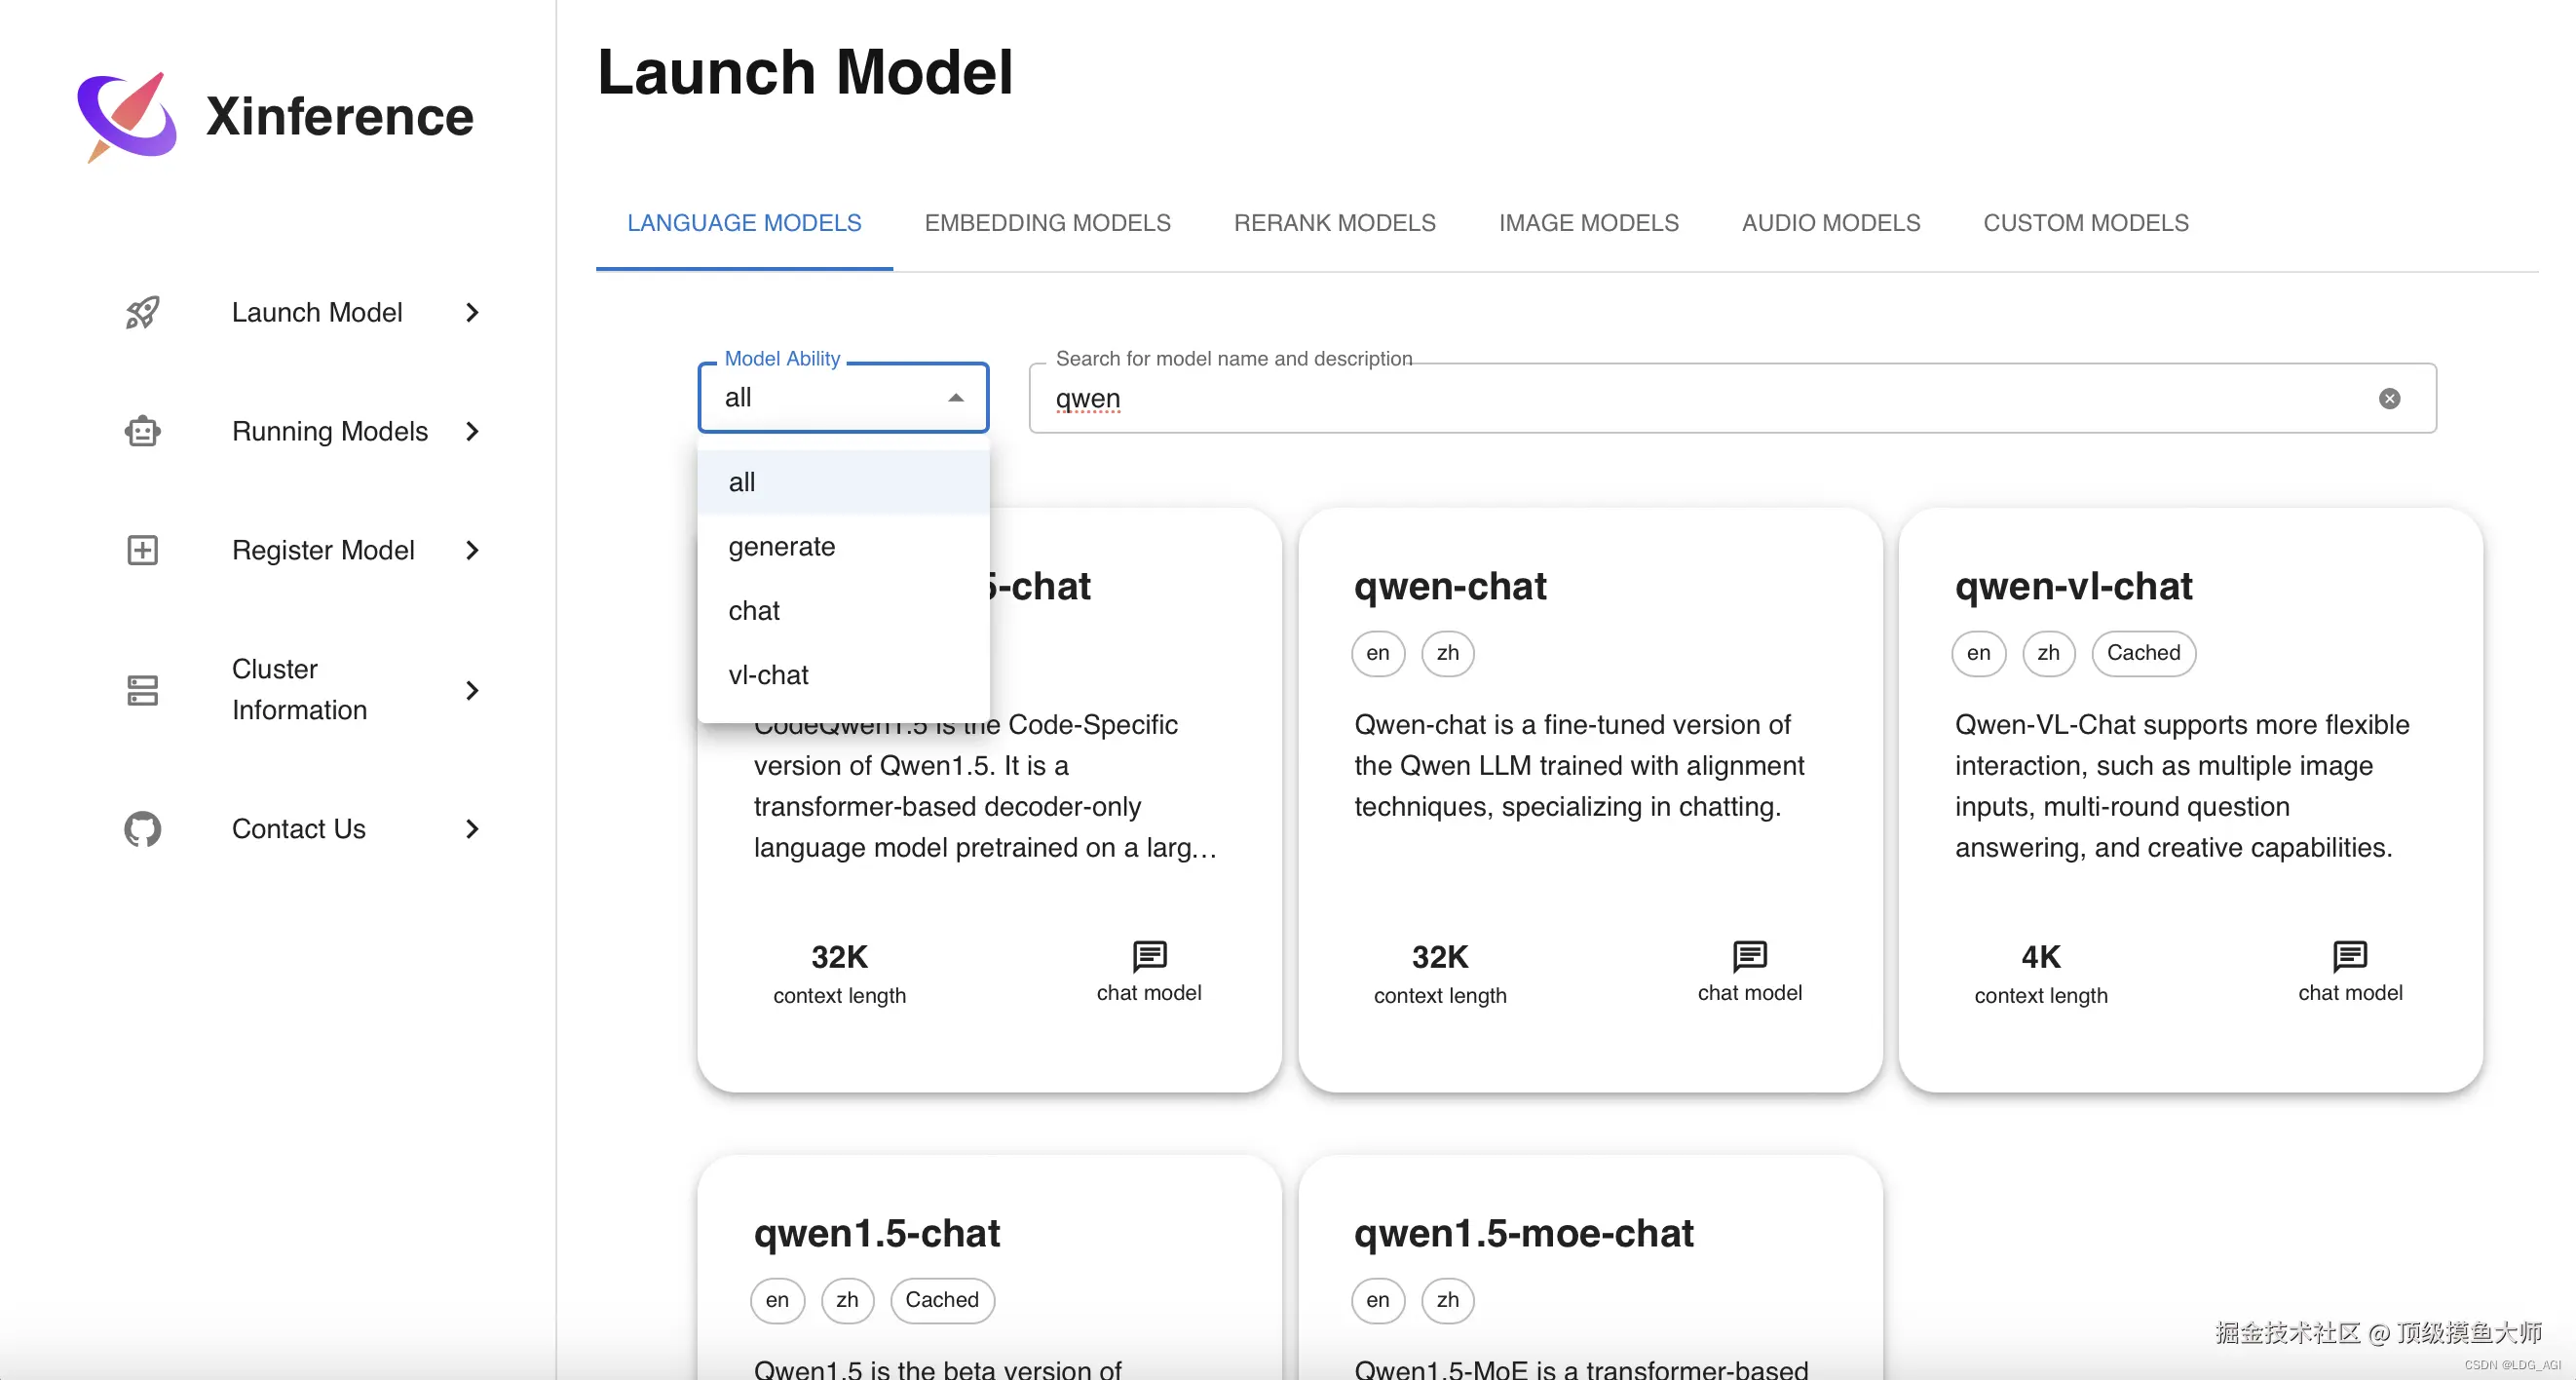
综述由AI生成大模型推理服务框架 Xinference 的一键部署方法。内容涵盖环境准备、Docker 本地与分布式集群部署命令详解、Web UI 功能操作指南(包括模型启动、自定义注册、集群监控)以及多种 API 调用方式(Curl、Python SDK、Dify 集成)。文章还补充了常见问题排查与性能优化建议,重点强调了使用 ModelScope 解决国内网络下载问题及 OpenAI 兼容性优势,旨在帮助工程师高效完成大模型推理服务的搭建与集成。
综述由AI生成详细解析了 2025 年 12 月 GESP C++ 二级考试真题,内容涵盖单选题、判断题及编程题。涉及知识点包括网络基础、C++ 语法关键字、循环逻辑、浮点数输出、运算符优先级及数学不等式判断等。文章提供了完整的题目解析思路及编程题参考代码,帮助考生理解考点并掌握解题方法。
综述由AI生成AI 大模型开发所需的知识储备,包括 Python 编程、机器学习与深度学习基础、数据处理及软件工程经验。重点讲解了 Transformer 模型原理、主流大模型平台 API 调用(如百度千帆、OpenAI)、LangChain 框架应用以及项目部署流程。内容涵盖环境搭建、模型微调、容器化部署等实战技能,旨在帮助开发者系统掌握大模型从理论到落地的全流程技术。