
PythonAI算法
Python 自然语言处理实战:基于《红楼梦》的文本挖掘与关键词提取
综述由AI生成通过 Python 实现《红楼梦》文本的自然语言处理全流程。首先按章节拆分原始文本并结构化存储,接着利用 jieba 分词结合自定义词库与停用词表过滤噪声,最后基于 TF-IDF 算法提取各卷核心关键词。案例展示了文本挖掘、中文分词及关键词提取的技术逻辑,代码具备高复用性,适用于其他中文文本分析。
综述由AI生成通过 Python 实现《红楼梦》文本的自然语言处理全流程。首先按章节拆分原始文本并结构化存储,接着利用 jieba 分词结合自定义词库与停用词表过滤噪声,最后基于 TF-IDF 算法提取各卷核心关键词。案例展示了文本挖掘、中文分词及关键词提取的技术逻辑,代码具备高复用性,适用于其他中文文本分析。
人工智能涵盖机器学习、深度学习等子领域,广泛应用于语音、图像等领域。介绍 AI 核心概念、发展历程及监督与无监督学习原理,并通过 TensorFlow 实战演示手写数字识别模型的搭建、训练与评估过程。同时分析主流 AI 应用领域的技术栈与投资回报,提供从基础编程到专家部署的学习路线,助力读者掌握 AI 关键技术。
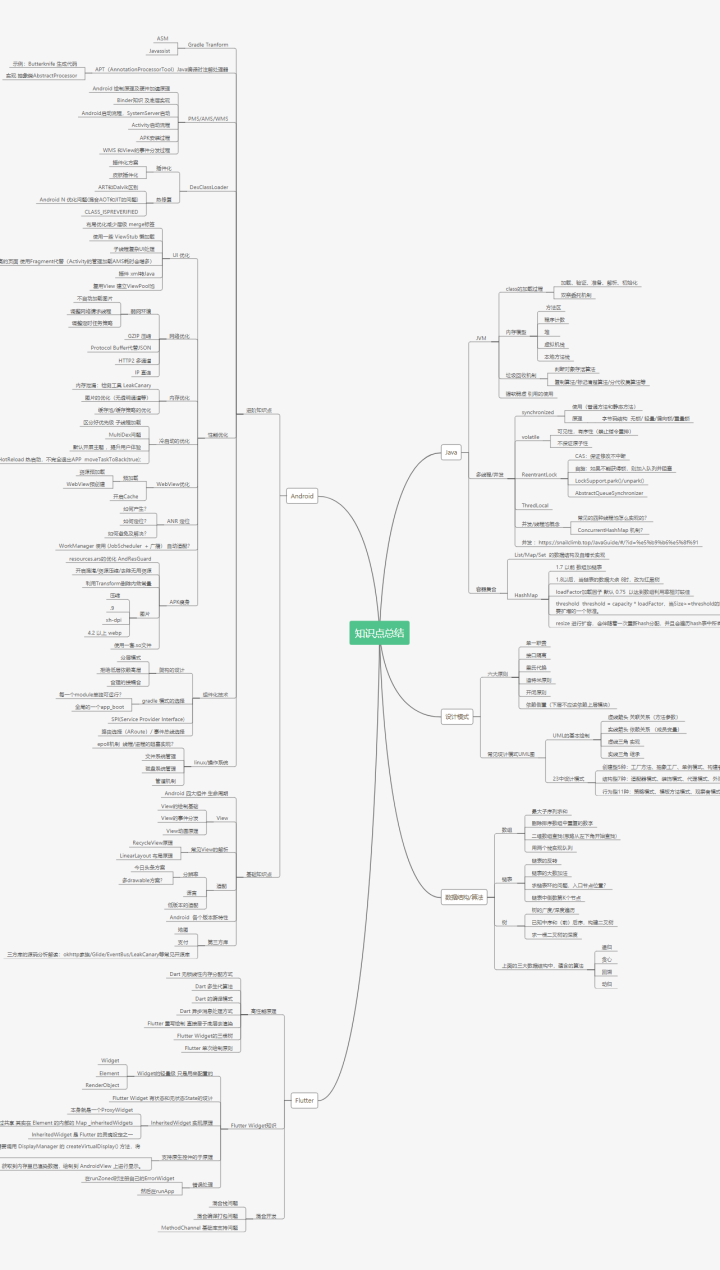
Android 开发面试涵盖 Java 基础、集合、多线程、JVM、四大组件、UI 绘制、性能优化、IPC、设计模式及计算机网络等核心领域。高频面试题并提供详细参考答案,包括抽象类接口区别、HashMap 原理、Handler 机制、Activity 生命周期、内存泄漏排查、Binder 通信机制等关键技术点。通过系统梳理考点与原理分析,帮助开发者夯实基础,提升面试通过率,避免单纯背诵,强调结合实战理解底层逻辑。
综述由AI生成DeepSeek-R1-Distill-Llama-8B 模型部署实战指南,涵盖 Ollama 环境安装、模型拉取与运行、多场景能力测试及参数调优。文章详细演示了如何在本地消费级硬件上快速部署该推理模型,并通过数学、代码、逻辑推理等实例验证其性能。同时提供了常见问题的解决方案,包括运行速度慢、内存不足及回答质量调整技巧,帮助用户高效利用该模型进行辅助学习与工作。
OpenCV Hough Circle 变换用于检测图像中的圆形物体。基于霍夫梯度法,通过边缘检测和圆心半径搜索实现。主要步骤包括灰度化、模糊去噪、边缘检测及圆参数拟合。关键参数如 dp、min_dist、param1、param2 需根据图像特性调整。提供完整的 C++ 代码示例及参数调优指南,涵盖常见问题解决方案与应用场景分析,适用于工业检测、医疗影像等场景。
人工智能技术发展历程涵盖三次浪潮,核心包括监督学习、无监督学习及强化学习三大范式。深度学习通过神经网络实现图像识别与序列处理,结合 Python、TensorFlow 等工具构建项目。提供从基础概念到行业应用的学习路径规划,帮助初学者避开数学过度追求或忽视实践的误区,理解 AI 在医疗、自动驾驶等领域的实际价值与发展趋势。
Stable Diffusion API 的本地部署流程及配置方法。首先需准备 NVIDIA 显卡及 Python 3.10.6 环境,通过 Git 克隆官方项目并安装依赖。启动时需添加 --api 参数以启用接口服务,默认监听 7860 端口。为增强安全性,建议在启动脚本中配置 --api-auth 参数实现 Basic Authentication 认证。完成上述步骤后,即可通过 HTTP 请求调用 API 进行图像生成操作。
WebRTC 是由 Google 主导的开源项目与浏览器 API,实现点对点实时音视频通信。架构包含信令层、媒体引擎、网络传输及安全层。核心组件包括 RTCPeerConnection 管理连接生命周期,RTCDataChannel 提供低延迟数据传输,getUserMedia 获取媒体流。网络穿透依赖 ICE/STUN/TURN 框架解决 NAT 问题。安全机制强制使用 DTLS-SRTP 加密,确保端到端通信安全。
综述由AI生成Llama 模型结合 PyTorch 框架,构成了当前大模型开发与部署的主流技术栈。通过参数高效微调(PEFT)、量化加载及分布式训练,开发者能显著降低显存门槛并提升推理效率。文章解析了从环境搭建到 LoRA 微调的关键步骤,并探讨了 Torch.compile 等性能优化方案,为实际工程落地提供清晰路径。
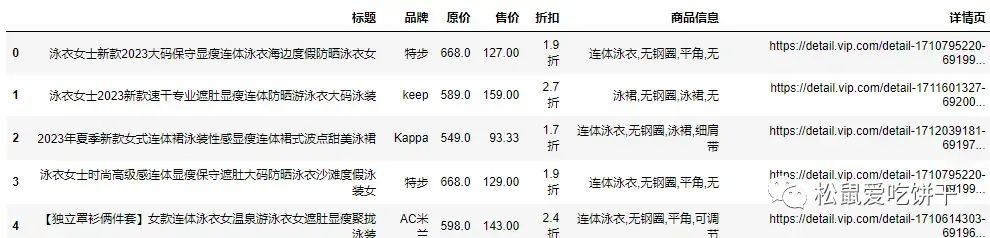
综述由AI生成演示了使用 Python 爬取唯品会泳衣商品数据的流程。通过分析网络请求接口,构建请求参数获取商品 ID 列表,进而批量抓取商品详情并存储为 CSV。随后利用 Pandas 进行数据处理,结合 PyEcharts 库绘制品牌分布饼图、售价平均柱状图及价格区间分布图,实现商品数据的直观可视化分析。
综述由AI生成深入解析了 Python 代码从源码到机器码的执行流程,涵盖解释器结构(python.exe 与 .dll)、字节码生成及虚拟机工作原理。阐述了模块、包、编译扩展的概念及 sys.path 导入机制,解释了 if __name__ == "__main__" 的作用。最后说明了虚拟环境通过隔离路径实现依赖管理的原理,并对比了不同解释器类型及现代工具差异。
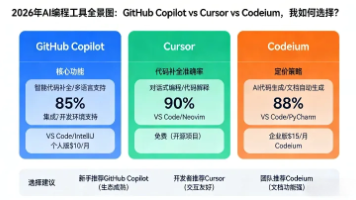
综述由AI生成对比了 GitHub Copilot、Cursor 和 Codeium 三款 AI 编程工具在鸿蒙及通用开发场景下的表现。通过实际测试代码生成准确率、重构能力及响应速度,分析了各自的优劣势。结合 2026 年价格策略,针对不同预算和需求场景给出了组合使用建议,强调根据具体任务灵活切换工具链而非依赖单一产品。
利用 GitHub Actions 结合自托管 GPU Runner 与预构建 PyTorch-CUDA 容器镜像,解决深度学习项目 CI/CD 环境不一致问题。通过配置标签精准调度任务,设定共享内存避免 DataLoader 报错,并实施安全最佳实践,实现代码提交即验证的真实 GPU 环境测试流程,提升迭代效率与稳定性。
综述由AI生成THULAC 是清华大学开发的中文词法分析工具,支持分词与词性标注。介绍其安装配置、基础用法及参数详解,涵盖 pip 安装、源码部署、自定义词典及命令行操作。通过性能对比数据展示其在准确率与速度上的优势,并列举了搜索引擎、情感分析等典型应用场景,适合需要高效中文 NLP 处理的开发者参考。
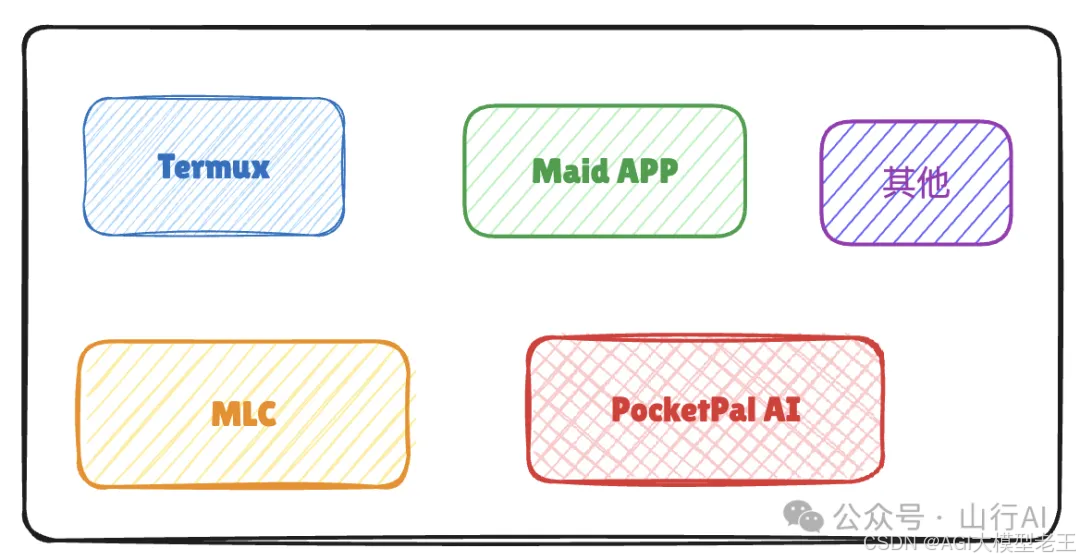
综述由AI生成多种在手机上部署本地大模型的方法,包括 Termux、MLC、Maid APP 及 PocketPal AI。重点分析了 PocketPal AI 的功能特性、安装步骤、模型管理及性能优化。文章详细说明了离线运行的优势、硬件需求(内存、处理器、存储)以及常见问题的排查方案,旨在帮助用户在移动设备上实现安全、高效的本地 AI 交互体验。
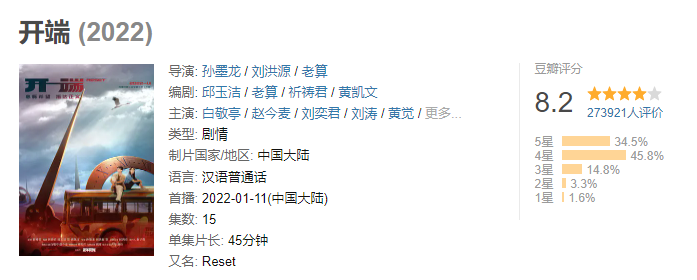
综述由AI生成详细讲解了如何使用 Python 采集电视剧《开端》的弹幕数据并进行词云可视化分析。内容包括环境搭建、网络接口分析、Requests 爬虫代码实现、Pandas 数据清洗、Jieba 中文分词以及 Pyecharts 词云图绘制。文章提供了完整的代码示例,涵盖了从数据获取到最终可视化的全流程,并对反爬策略、数据编码及停用词处理进行了说明,帮助读者掌握弹幕数据挖掘的基本方法。
C++ 多线程编程中数据竞争问题常见,互斥锁开销较大。原子操作 std::atomic 提供轻量级无锁同步方案,适用于单变量场景。文章讲解原子操作核心特性、常用接口及内存序设置,对比原子操作与互斥锁差异。通过计数器自增、线程退出标志位等实战案例,展示如何高效解决线程安全问题,避免死锁风险并提升性能。
综述由AI生成详细阐述了 LlamaIndex 库的多种安装方式及本地模型配置流程。内容包括标准 Pip 安装、自定义依赖选择以及源码编译步骤。重点展示了如何在不依赖 OpenAI 的情况下,集成 Ollama 作为大语言模型后端,并搭配 HuggingFace 进行嵌入向量处理。文中提供了完整的初始化代码示例,涵盖服务上下文配置、文档加载及索引构建,旨在帮助开发者快速搭建基于本地资源的 RAG 应用环境。
AI 绘画中提示词质量直接决定生成效果。解析 Tokenization、权重分配及负面提示词机制,提供分层构建模板与 CLIP 语义评估方案。通过对比实验展示优化前后差异,总结常见错误避坑指南,帮助开发者提升可控性与效率。