
PythonAI算法
DALL·E 3 绘图功能详解与 API 集成指南
DALL·E 3 图像生成技术解析,涵盖分辨率、WebP 格式优势及多图生成功能。编辑器界面操作指南提供直观修改方案。API 部分详述密钥获取、调用流程及最佳实践,助力开发者高效集成创意工具。
DALL·E 3 图像生成技术解析,涵盖分辨率、WebP 格式优势及多图生成功能。编辑器界面操作指南提供直观修改方案。API 部分详述密钥获取、调用流程及最佳实践,助力开发者高效集成创意工具。
综述由AI生成C++ 继承是面向对象编程实现代码复用的关键机制。详细阐述了继承的概念定义、基类与派生类的转换规则及访问权限变化。重点讲解了派生类默认成员函数的生成逻辑、作用域隐藏现象以及友元与静态成员的继承特性。针对多继承带来的数据冗余和二义性问题,深入剖析了菱形继承模型及其虚继承解决方案。最后对比了继承与组合的适用场景,强调优先使用组合以降低耦合度,为构建高质量 C++ 类层次结构提供实践指导。
通过 SQL 语句从薪水表中筛选员工当前有效薪资。利用结束日期 9999-01-01 标识当前在职状态,结合 DISTINCT 去重与降序排序,精准获取最新薪资数据。适用于人事数据库查询场景。
综述由AI生成Python 语言的三大核心应用领域:Web 开发、数据科学和脚本编写。在 Web 开发方面,对比了 Flask 和 Django 框架的特点及适用场景,并提供了基础代码示例。数据科学部分涵盖了机器学习原理、常用算法及 scikit-learn 和 Matplotlib 库的使用。脚本编写部分展示了 Python 在自动化任务中的优势。文章还简要提及了嵌入式、游戏等其他用途,并建议开发者优先选择 Python 3 版本。
Llama-3.2-3B 模型在 Ollama 中运行时可能因默认上下文窗口和 Token 限制导致长文本丢失或截断。通过创建自定义 Modelfile 调整 num_ctx 和 num_predict 参数,可显著扩展记忆长度与生成能力。操作包括检查环境、编写配置文件、执行 ollama create 命令构建新模型,并通过多轮对话及长文生成测试验证效果。需根据硬件内存权衡上下文大小与响应速度。
综述由AI生成一种基于关键场景辨别算法的两阶段鲁棒微网优化调度方法。针对光伏等可再生能源的不确定性,该方法摒弃传统 CC&G 算法,采用关键场景筛选技术锁定最不利情境。通过主问题确定基础调度方案,子问题辨识极端场景并迭代更新,有效平衡了经济性与鲁棒性。结合 MATLAB 实现,相比传统方法显著降低了计算复杂度与时间,提升了供电可靠性。
综述由AI生成一位 AI 从业者分享了 14 天大模型学习路线,涵盖从基础原理到高级架构的关键概念。内容分为三步:从零构建大模型、理解幻觉问题及优化策略、以及进阶技术如 KV 缓存和 MoE。同时列出了所需的数学、编程及深度学习预备知识,旨在帮助初学者快速入门并深入理解大型语言模型的底层机制。
综述由AI生成解析 C++ 中虚函数、虚基类与多态的核心概念及用法。通过动物发声示例对比有无虚函数的多态效果,指出虚函数实现运行时绑定。针对多继承菱形继承问题,展示虚基类如何避免数据冗余和二义性。文章强调虚析构函数的必要性,并对比了虚函数与虚基类在目的、关键字位置及作用阶段的区别,帮助读者理解 C++ 面向对象机制。
介绍 C++ 入门路径,涵盖基础语法、开发环境配置、面向对象编程及 STL 标准库使用。内容包含 Hello World 示例、类与继承代码演示、内存管理与指针操作,并提供实践项目建议、调试技巧与代码规范。推荐经典书籍与官方文档作为学习资源,强调动手实践的重要性,帮助初学者避开内存泄漏等常见误区。
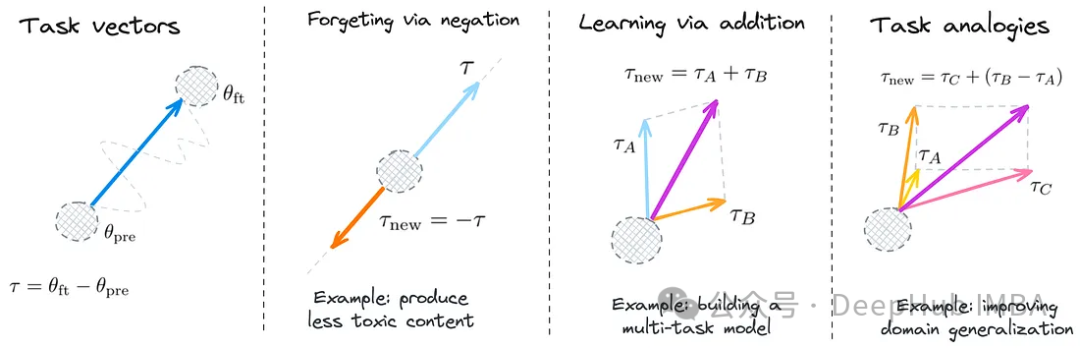
综述由AI生成大模型融合的四种核心算法:Task Vector、SLERP、TIES 和 DARE,分析了它们的工作原理及适用场景。通过 mergekit 工具演示了如何将 Mistral、Wizard Math 和 Code Llama 模型进行合并,提供了具体的安装步骤、YAML 配置详解及命令行参数说明。该技术在无需微调的情况下结合多个模型的优势,是经济有效的模型优化方案,并附带了资源消耗参考及常见问题解决方案。
昇腾 CANN 生态包含多层 API 接口,涵盖 Python ACL、C++ AscendCL、TBE 及 C++ Kernel 等不同层级。根据应用场景选择学习路径:模型推理首选 Python ACL,高性能工程部署需掌握 C++ AscendCL,算子开发则涉及 TBE 或底层 C++ Kernel。训练侧推荐 MindSpore 或 PyTorch Frontend。随着技术发展,CANN 语言路线趋向收敛,上层易用封装结合底层…
GitNexus 核心引擎通过索引流水线、社区检测与流程追踪、混合搜索与嵌入三个子系统将代码库转换为知识图谱。索引流水线包含文件扫描、AST 解析、导入调用解析等 9 个阶段,利用 Worker 池并行处理提升性能。社区检测采用 Leiden 算法进行功能聚类,流程追踪基于 BFS 算法从入口点生成执行路径。混合搜索结合 BM25 与语义向量,使用 RRF 融合结果。支持多语言解析及 GPU/CPU 自适应设备选择,实现高效代码分析与智…
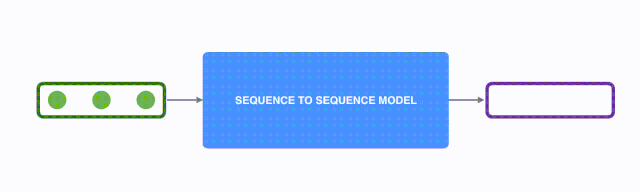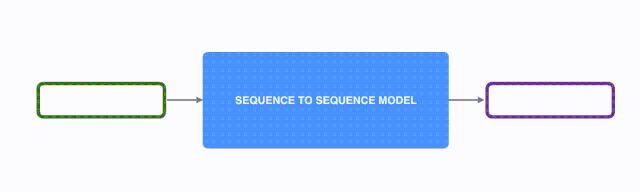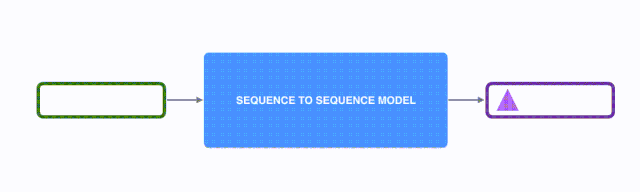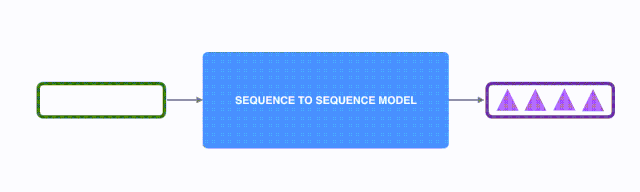
综述由AI生成深入解析了 Transformer 框架的核心原理与架构设计。文章从序列到序列模型的定义出发,对比了传统 RNN/LSTM 的局限性,阐述了 Transformer 如何通过自注意力机制解决长距离依赖问题。详细拆解了 Encoder-Decoder 结构,包括输入嵌入、位置编码、多头注意力、残差连接及层归一化等关键组件。同时解释了 Masked Attention 在解码器中的作用及 Softmax 预测机制,为理解 BERT、GPT…
利用 Vitis 平台将 PyTorch 模型部署至 FPGA 边缘设备的完整流程。涵盖环境配置、ONNX 导出、INT8 量化校准、DPU 编译及板端推理验证。重点解析 Vitis AI 工具链与 DPU 架构原理,提供常见报错解决方案,帮助开发者在低功耗场景下实现高性能 AI 推理。
综述由AI生成Python 作为当前最流行的编程语言之一,在数据科学、Web 开发及自动化领域占据重要地位。基于行业数据分析了学习 Python 的八大理由:语法简洁易学、薪资竞争力强、市场需求持续增长、数据科学生态完善、开发效率高、资源丰富、跨平台兼容性好以及被科技巨头广泛采用。内容涵盖语言特性、应用场景及职业发展建议,适合初学者及进阶开发者参考。
Java SE 多线程的核心概念,涵盖常见锁策略(乐观/悲观、轻量/重量级、自旋、公平/非公平、可重入、读写锁)、死锁成因及避免方法(如哲学家就餐问题、锁排序)、JUC 包常用类(Callable、ReentrantLock、原子类、信号量、CountDownLatch),以及 synchronized 锁升级原理和 CAS 机制及其 ABA 问题。旨在帮助开发者理解并发编程基础,掌握线程安全控制手段。
哈希表通过映射关系实现快速查找,核心在于处理哈希冲突。本文深入探讨开放定址法(线性探测)与拉链法的区别,解析负载因子对性能的影响及扩容重哈希逻辑。结合 C++ 模板技术,展示如何从零构建支持迭代器遍历、const 正确性及自定义 Key 提取器的通用哈希表容器。
Python 3.8+ 环境的搭建流程,包括 Jupyter Notebook 配置及常用数据科学库(NumPy、Pandas、Matplotlib、Seaborn)的安装。内容涵盖 NumPy 数组操作、Pandas 数据处理与清洗、以及 Matplotlib 和 Seaborn 的可视化图表绘制方法,旨在帮助开发者快速掌握数据科学基础工具链。
Whisper 是 OpenAI 推出的开源语音识别模型,提供从 Tiny 到 Large 多种规模版本。各版本(含英文专用与多语言通用)的官方下载链接,并给出选型建议:轻量级场景推荐 Tiny 或 Base,平衡性能选 Small 或 Medium,高精度需求则用 Large-v3。仅处理英文时可选带 .en 后缀模型。
综述由AI生成高性能命令行搜索工具 ripgrep 在 Windows、macOS 和 Linux 系统上的安装、配置及使用方法。文章对比了 ripgrep 与其他搜索工具的性能,详细说明了通过包管理器(如 Chocolatey、Homebrew、apt)或源码编译的安装步骤,并提供了 PowerShell、Bash、Zsh 等环境的自动补全配置方案。此外,还涵盖了基本搜索命令、忽略规则、压缩文件处理、配置文件自定义以及多行搜索等高级功能,帮助开发者…