
SQL算法
Oracle 中 CONNECT BY PRIOR 递归查询用法
Oracle 数据库使用 CONNECT BY PRIOR 子句实现层级数据查询。语法包含 START WITH 定义根节点、CONNECT BY 定义父子关系连接条件、WHERE 过滤结果。通过组织 ID 与父 ID 关联存储树形结构,可检索整棵树或特定分支。支持层号标记及 ORDER BY 排序。该机制基于深度优先搜索逻辑遍历节点,适用于组织架构等层级数据展示。
Oracle 数据库使用 CONNECT BY PRIOR 子句实现层级数据查询。语法包含 START WITH 定义根节点、CONNECT BY 定义父子关系连接条件、WHERE 过滤结果。通过组织 ID 与父 ID 关联存储树形结构,可检索整棵树或特定分支。支持层号标记及 ORDER BY 排序。该机制基于深度优先搜索逻辑遍历节点,适用于组织架构等层级数据展示。

综述由AI生成详细解析了 AI 大模型、RAG、函数调用、Agent、知识库、向量数据库、知识图谱与 AGI 之间的区别与联系。大模型作为推理基石,通过 RAG 注入外部知识解决幻觉问题,利用函数调用获取工具执行能力,进而演变为具备规划与行动能力的 Agent。知识库与向量数据库负责非结构化数据的存储与检索,而知识图谱则提供结构化语义关系。这些技术协同工作,共同推动 AI 从单一生成向通用智能(AGI)迈进,为企业级应用提供完整的技术栈解决方案。
Mistral 与 Qwen 开源模型在 Prompt 适配性上的实测对比。实验覆盖 7B 至 14B 参数量级,测试基础指令、Few-Shot、CoT 推理及角色扮演四类场景。结果显示参数量显著提升性能,Qwen-14B 在中文理解与逻辑拆解上占优,Mistral 系列推理速度更快。文章提供针对不同模型的 Prompt 优化策略及实验局限说明,为开发者选型与调优提供参考。

综述由AI生成AI 产品经理面试涉及对 AIGC 概念、工具使用、岗位能力及大模型技术的理解。梳理了 8 道高频面试题,涵盖 AI 与 AIGC 区别、需求来源、开发职责及主流模型分析。同时提供了从系统设计到微调开发的学习路线,帮助求职者构建逻辑性回答框架,掌握技术背景下的产品思维,提升面试通过率。
综述由AI生成IndexTTS 2.0 通过毫秒级时长控制、音色情感解耦及零样本音色克隆技术,解决了传统语音合成难以匹配音乐节拍的问题。该模型支持自回归架构下的精确长度调整,误差控制在±50ms 内,并能分离音色与情绪特征,允许自由组合不同声音的情感表达。结合 Python 脚本批量生成音频并导入 Ableton Live,配合 Bitcrusher 等效果器处理,可实现高度可控的机器人说唱创作流程。此方案无需大量训练数据,仅需 5 秒参考音频即可克…
图论核心概念、存储结构(邻接表与矩阵)及深度优先搜索(DFS)、广度优先搜索(BFS)的实现细节。通过树形结构排名与最短路径计数两道经典例题,演示如何结合数据结构解决实际问题,重点解析代码逻辑与边界处理。

综述由AI生成多模态 AI 知识库融合了文本、图像、音频、视频等多种数据模态,利用人工智能技术进行智能化处理与管理。相比传统知识库,它在数据模态丰富度、知识表示的高维向量化、存储架构的混合模式(向量库 + 知识图谱)以及交互体验上具有显著优势。构建过程涵盖数据收集预处理、模型训练优化、知识表示存储及推理应用四个关键阶段。具体实施可采用 A-MM KG 将多模态数据作为属性值,或 N-MM KG 将其作为独立实体构建图谱。应用场景广泛覆盖营销内容生成、…
综述由AI生成什么样的人不适合学编程主要涉及学历认知偏差与空想主义心态。文章分析了行业现状,指出编程需要扎实的计算机基础与持续的学习能力。随后详细介绍了 Python 语言在爬虫、数据分析、机器学习等领域的应用路径,涵盖从基础语法到高级进阶的完整知识体系,强调实践与逻辑梳理的重要性,为初学者提供清晰的技术成长路线图。
综述由AI生成详细解析了大模型落地的全流程,涵盖历史演变、硬件选型、训练策略及模型评估。重点阐述了显卡配置对训练与推理的影响,介绍了 LoRA、RLHF 等高效微调技术,并对比了国内外主流模型特性。针对通义千问等开源模型提供了具体的显存与性能配置建议,最后探讨了 AI 未来的多模态与端侧发展趋势,为技术团队提供了一套完整的实施参考。
综述由AI生成在 NVIDIA Tesla P40(Pascal 架构,无 BFloat16 支持)上训练 Llama-3.3-70B 大模型的方案。通过采用 4-bit NF4 量化、模型自动分片及纯 FP32 训练管线,解决了显存不足和混合精度崩溃问题。关键配置包括禁用 AMP、强制非量化层为 float32 以及使用 paged_adamw_8bit 优化器。实测表明该方案可在 4 卡环境下稳定运行 batch_size=1 的训练任务。
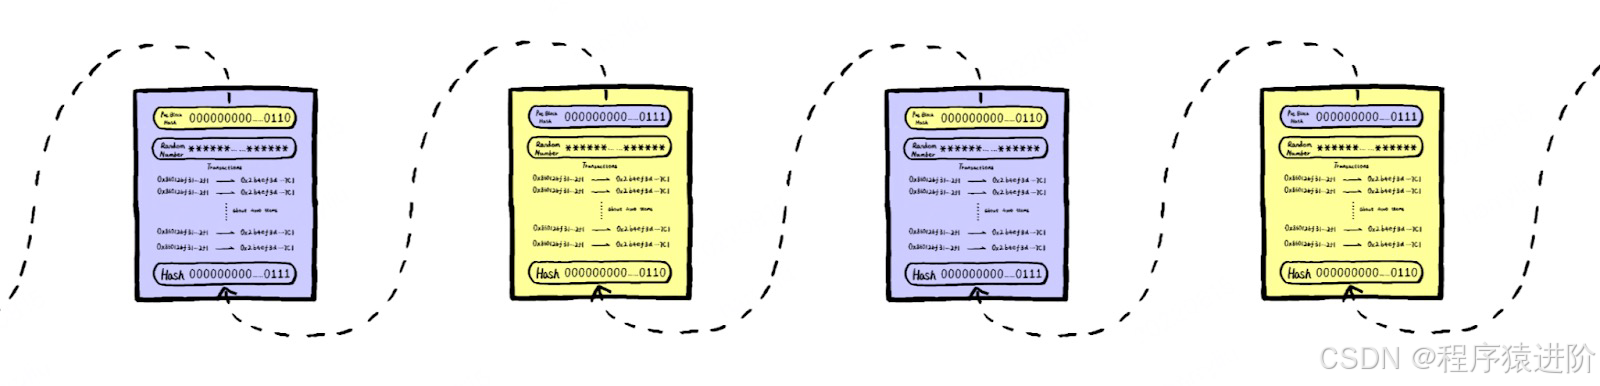
综述由AI生成Web3.0 的概念、核心功能(去中心化、去信任、语义网、互操作性)及其与 Web1.0、Web2.0 的区别。重点阐述了区块链技术作为 Web3.0 基础的作用,包括其去中心化账本、共识机制及不可篡改性,旨在构建更安全、隐私保护且用户自主控制的下一代互联网。
综述由AI生成深入解析了基于大模型的 AI Agent 核心架构,涵盖规划、记忆、工具与行动四大关键组成部分。文章详细阐述了 LLM Agent 结合 RAG 技术的实现路径,并以财报分析 Agent 为例,展示了从需求分析到报告生成的完整开发流程。此外,还介绍了 LangChain 和 AutoGen 等主流开发框架的代码实践,探讨了当前面临的幻觉、延迟、安全等挑战及优化方案,为读者提供了系统的技术参考与实战指南。
综述由AI生成详细解析了 Python 编程中的五个经典示例,涵盖斐波那契数列的递归与迭代优化、快速排序的分治策略实现、基于 Counter 与正则表达式的文本词频统计、阶乘计算的递归限制与标准库替代方案,以及列表推导式和生成器表达式的高效用法。文章不仅提供了完整的代码实现,还深入探讨了各算法的时间复杂度、空间复杂度及实际应用场景中的注意事项,如文件编码处理、异常捕获及 PEP 8 规范。通过对比不同实现方式的优劣,旨在帮助读者建立扎实的算法思维,掌…

大模型算法岗位的常见面试题,涵盖基础架构、进阶微调、LangChain 应用框架、分布式训练及推理优化等核心领域。内容涉及 Transformer 原理、Tokenizer 实现、LoRA 与 SFT 微调策略、RAG 检索增强生成、以及 Flash Attention 等推理加速技术。旨在帮助求职者系统复习大模型相关知识,掌握从预训练到部署的全流程关键技术点。
GTC 2026 将于 3 月 16 日至 19 日举行,黄仁勋主题演讲定于 16 日上午。大会核心聚焦物理 AI、代理 AI、推理及 AI 工厂四大主轴。Vera Rubin 平台已在 CES 2026 官宣,预计 2026 年下半年落地。相比 Blackwell,Rubin 旨在降低 MoE 模型训练 GPU 数量至四分之一,并将高交互型 AI 每百万 token 成本降至十分之一。行业重心正从训练转向推理与部署,英伟达致力于构建完…
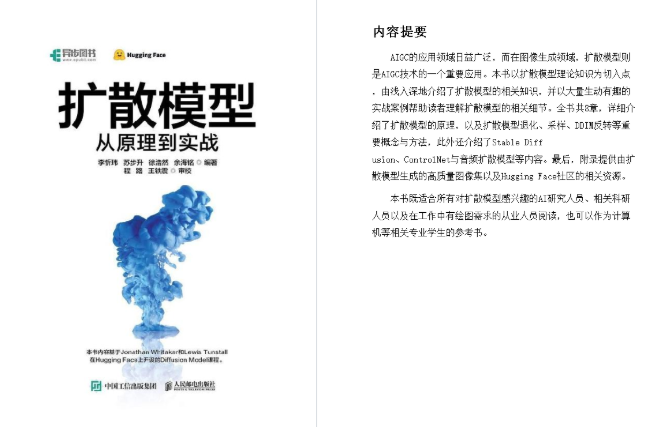
综述由AI生成系统介绍了扩散模型在 AIGC 领域的核心地位与技术原理,涵盖前向加噪与逆向去噪的数学基础、Stable Diffusion 潜在扩散架构、ControlNet 结构控制及 DDIM 采样加速等关键技术。文章结合 Hugging Face Diffusers 库提供了 Python 代码实战示例,涉及图像生成、音频处理及多模态应用,适合 AI 研究人员及开发者深入理解并实践扩散模型。
综述由AI生成Java 8 HashMap 重构引入红黑树解决链表过长性能退化问题,优化哈希算法减少碰撞,扩容机制采用尾插法避免死循环并利用位运算提升效率。源码层面分析了 Node、TreeNode 结构及 resize、treeifyBin 等核心逻辑。虽解决 Java 7 并发环状链表问题,但 HashMap 仍非线程安全,高并发场景建议使用 ConcurrentHashMap。
通过模拟面试形式,详解如何在本地环境部署 Dify 平台并集成开源大模型(如 Llama-3、Qwen)。内容涵盖 Docker Compose 与 vLLM 配置、自定义 Skill 开发流程(HTTP/API)、企业级权限控制与数据安全策略、RAG 幻觉优化方案以及系统监控迭代机制。旨在为工程师提供一套安全可控、可落地的私有化 AI Agent 建设路径,解决数据不出域、模型可审计及能力深度定制的企业需求。
C++ STL 标准模板库包含六大组件,迭代器是访问容器的万能钥匙,遵循左闭右开区间原则。auto 关键字在编译期进行类型推导,简化复杂类型声明,需注意默认剥离引用和顶层 const。范围 for 循环基于迭代器实现,支持按值、引用及常量引用遍历,提升代码可读性与安全性。
综述由AI生成基于 Nexent 开源智能体平台构建 AI 烹饪顾问的实战过程。内容包括模型接入(Qwen 系列)、知识库构建(多种格式文档解析)、MCP 工具集成(HowToCook 菜谱、高德地图天气、Fetch 网页抓取)以及智能体开发与调试。通过三轮实测验证了智能体在食材搜索、禁忌过滤、天气应季推荐及复杂任务规划方面的能力。文章分析了平台在提示词自动生成、工具生态、知识溯源及版本管理等方面的优势,展示了利用 AI 技术解决家庭烹饪个性化需求的…