
PythonAI算法
基于 SWIFT 的 VLLM 推理加速与部署实战
综述由AI生成基于 MS-SWIFT 框架和 VLLM 引擎的大语言模型推理加速与部署方案。内容涵盖环境配置、Qwen 与 ChatGLM 模型的推理与流式输出、CLI 工具使用、微调后模型的合并与部署、Web UI 搭建以及多 LoRA 部署策略。重点展示了如何通过 Python 脚本和 Shell 命令调用 VLLM 后端,兼容 OpenAI API 标准,实现高吞吐量的模型服务化。
综述由AI生成基于 MS-SWIFT 框架和 VLLM 引擎的大语言模型推理加速与部署方案。内容涵盖环境配置、Qwen 与 ChatGLM 模型的推理与流式输出、CLI 工具使用、微调后模型的合并与部署、Web UI 搭建以及多 LoRA 部署策略。重点展示了如何通过 Python 脚本和 Shell 命令调用 VLLM 后端,兼容 OpenAI API 标准,实现高吞吐量的模型服务化。
Llama API 结合 LlamaIndex 实现托管模型调用。通过安装依赖并配置密钥,可快速完成文本补全、多轮对话、函数调用及结构化数据提取。利用 Pydantic 定义数据模型,配合 OpenAIPydanticProgram 能高效解析非结构化文本为指定格式,降低本地部署成本,提升开发效率。
综述由AI生成STL list 基于双向循环链表实现,支持高效插入删除但随机访问慢。文章对比了 forward_list 与 list 的区别,详细讲解了迭代器、初始化、容量及修改接口,并通过 splice、sort 等函数展示了独特操作。最后通过表格对比 list 与 vector 的底层结构、性能及使用场景,帮助开发者根据实际需求选择合适容器。
综述由AI生成RoboMME 是一个针对机器人通用策略记忆能力的标准化基准测试平台,包含 16 个长时程任务,涵盖时间、空间、物体和程序四种记忆维度。研究基于π0.5 骨干网络构建了 14 种记忆增强型 VLA 模型,对比了符号、感知和循环三种记忆表征及不同整合机制。实验表明,感知记忆在运动敏感任务中表现最佳,符号记忆在短时事件任务中更优,不同设计具有互补优势。
介绍 K 均值聚类算法的无监督学习原理、数学推导及 Python 实现。内容涵盖算法步骤、肘部法则确定 K 值、K-Means++ 优化策略及优缺点分析。通过 NumPy 和 Scikit-Learn 代码示例展示聚类过程,适用于客户细分、图像压缩等场景。
Windows 环境下安装 Pandas 常遇编译器缺失、依赖冲突及版本兼容问题。通过预编译轮文件、Visual Studio Build Tools 及虚拟环境隔离可有效解决。建议优先使用稳定版 Python(如 3.12)并避免全局混装依赖。
综述由AI生成MCP(模型上下文协议)为 AI 模型提供了标准化的外部工具调用方式,解决了传统 API 对接中的动态适配难题。它通过客户端与服务端的能力协商,让模型像插 U 盘一样接入各种服务,降低了接口变更带来的维护成本。实战中,MCP 可以快速生成前端页面,但需注意权限控制与生产环境的安全加固。
综述由AI生成PCL 点云处理涵盖了滤波、配准、分割、重建、特征提取等核心模块。本文整理了对应的算法索引与功能点,包括 KD 树与八叉树索引、ICP 及其变体配准、RANSAC 几何拟合、曲面重建方法及可视化交互操作。内容涉及 C++ 基础 API 调用、LAS 格式支持及 VTK 集成,适用于三维视觉与机器人领域的工程实践参考。
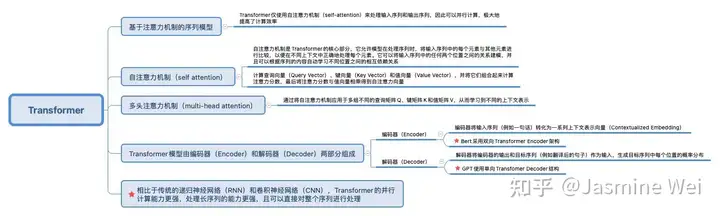
综述由AI生成详细阐述了大语言模型(LLM)的基础概念、技术架构及训练范式。内容涵盖自然语言理解与生成任务的区别,Transformer 编码器与解码器结构的对比,以及从传统机器学习到提示学习的四个训练范式演进。重点分析了大模型的产品表现、基础能力与安全合规评估标准,特别是 Trustworthiness 维度的可靠性、安全性与公平性。此外,补充了提示词工程策略与 RLHF 人类对齐技术,旨在帮助 AI 产品经理建立系统的技术认知框架,以便更好地进行…
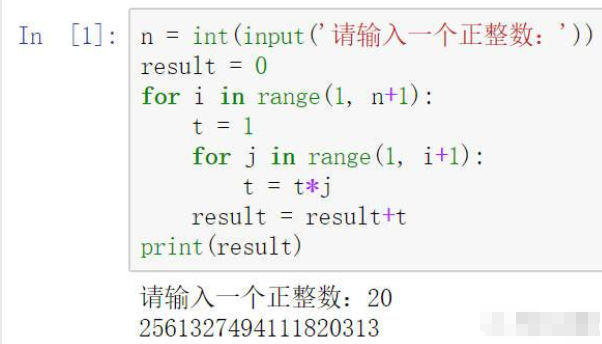
多个 Python 编程实例,涵盖贪吃蛇游戏、素数判断、数值统计及 Python 之禅等主题。内容包含基础语法、循环结构、函数定义及第三方库应用示例,旨在提供简洁实用的代码参考,帮助开发者快速掌握 Python 核心编程技巧。
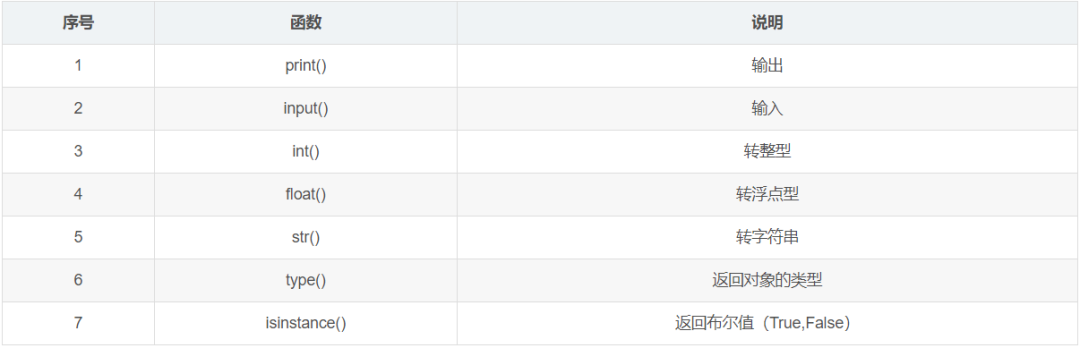
综述由AI生成Python 常用函数涵盖了输入输出、流程控制、数据结构(列表、元组、字典)、字符串处理、文件操作、装饰器及正则表达式等核心领域。高频使用的函数示例与用法,帮助开发者快速查阅记忆,解决编码卡壳问题,提升开发效率。内容包含基础类型转换、条件判断逻辑、列表元组操作、字符串格式化、字典管理、函数作用域、多线程实现、模块导入、文件读写、类装饰器应用以及正则匹配技巧,适合初学者及需要快速查阅的开发者参考。
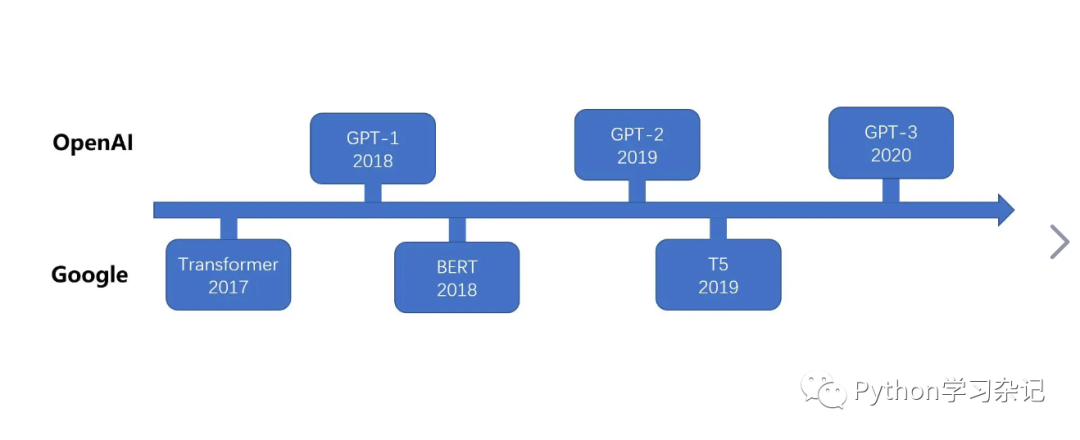
综述由AI生成大模型指参数量巨大、基于深度学习架构的人工智能模型,在自然语言处理等领域表现卓越。对比了大模型与小模型在规模、数据需求及计算资源上的差异,分析了 GPT、BERT 等代表性模型的特点。内容涵盖预训练、微调、提示工程及 RAG 等关键技术,探讨了模型幻觉、隐私安全等挑战,并展望了多模态融合与边缘计算的未来发展方向。
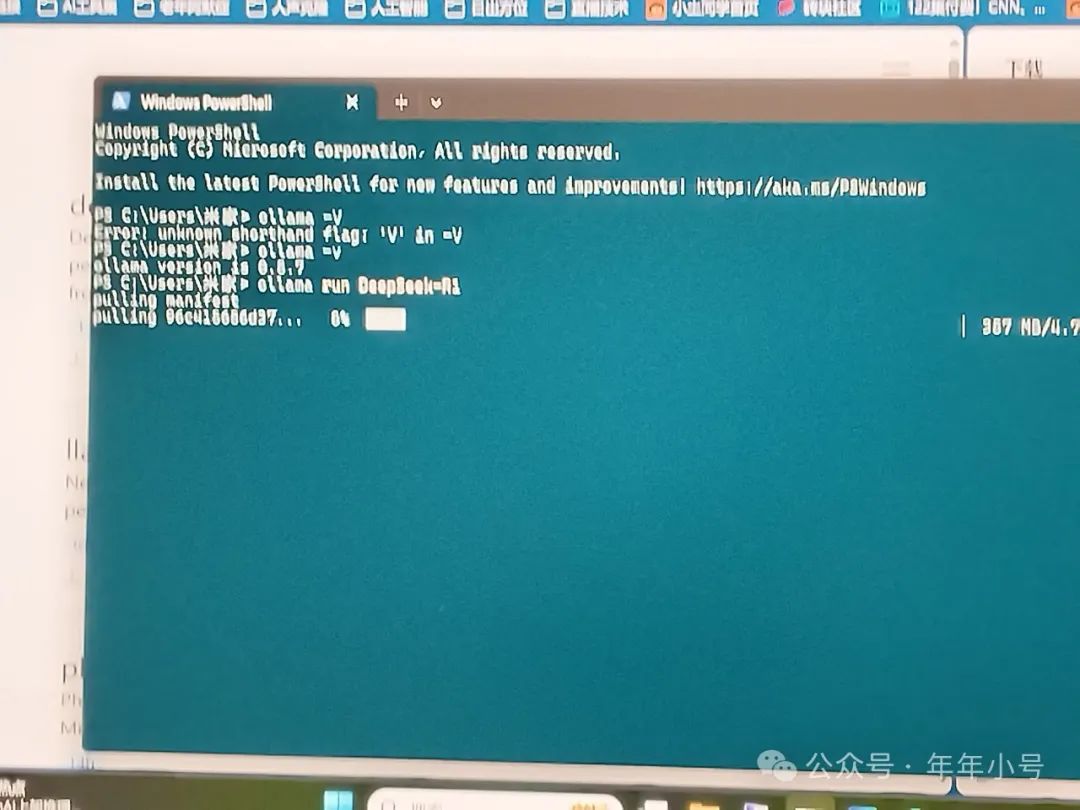
综述由AI生成在 Windows 系统下使用 Ollama 工具本地部署 DeepSeek-R1 大模型的完整流程。通过 PowerShell 命令行执行 ollama run 命令,自动下载约 4.7GB 的 7B 版本模型文件。文中记录了安装过程中可能遇到的中断情况及其重试方法,并补充说明了如何通过指定参数(如 :7B)来明确模型规格,包括 1.5B、7B 和 8B 等不同版本的文件大小差异。最后提供了模型验证、列表查看及退出交互的基本操作指令,…
综述由AI生成探讨了在工业级软件和科研工具开发中,如何结合Qt C++的高性能与Python科学计算库的优势。内容涵盖跨语言通信桥梁搭建、虚拟环境配置、C++与Python数据类型映射机制等关键技术点,旨在帮助开发者实现生态整合,提升应用系统的专业性与灵活性。
一个基于 Python+Django 框架和微信小程序的个人运动健康饮食指导管理平台。系统后端采用 Django 构建 RESTful API,使用 MySQL 存储数据,通过 HTTPS 通信并采用 JWT 认证。前端为微信小程序,支持记录运动数据和饮食摄入。数据分析模块利用 Pandas、NumPy 及机器学习算法(如随机森林)生成个性化健康建议和可视化报告。该平台旨在帮助用户建立健康生活习惯,具备模块化设计便于扩展。
堆排序利用堆顶特性实现高效排序,TopK 问题通过维护 K 大小堆解决海量数据筛选。建堆原理(向下调整优于向上调整)、升序降序策略及空间优化方案,提供完整 C 语言实现与复杂度分析。
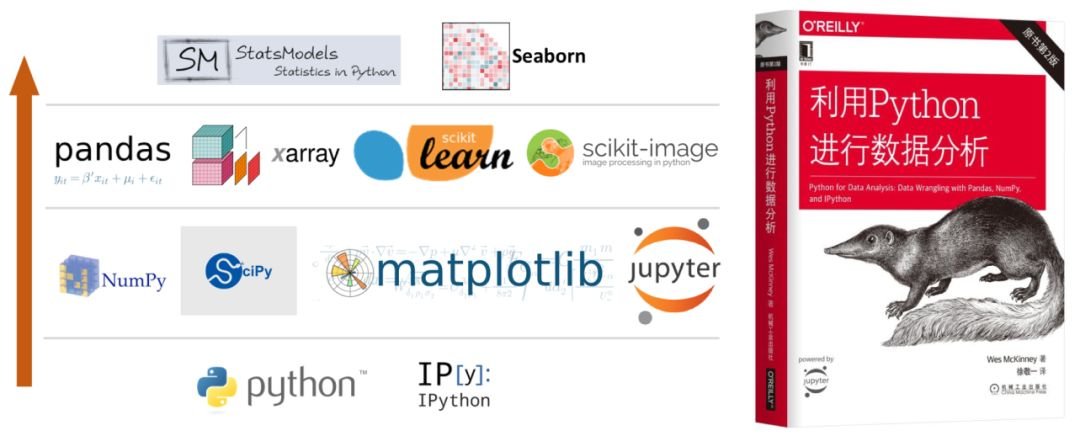
Python 数据分析涵盖读写、处理计算、分析建模和可视化四个核心环节。主要依赖 NumPy 进行科学计算,Pandas 处理表格数据,Matplotlib 实现可视化,以及 Scikit-learn 和 Statsmodels 用于统计建模。本书推荐《利用 Python 进行数据分析》,由 pandas 创始人 Wes McKinney 撰写,适合财经统计背景及计算机人员系统学习。掌握这些工具能有效提升数据处理效率与分析能力。
综述由AI生成探讨了知识图谱与大型语言模型(LLM)作为知识库的异同,分析了知识图谱在推理能力和准确性上的优势,以及 LLM 在幻觉和领域知识上的局限。重点介绍了利用 LLM 自动构建知识图谱的几种方法,包括基于生成式模型的早期方法 COMET、使用 ChatGPT 进行信息提取的 BEAR 项目、半自动构建流程以及直接从 LLM 中提取知识的策略。文章总结了这些方法在提升知识表示质量、降低构建成本方面的潜力,并指出未来结合两者优势是增强知识表示的重…
综述由AI生成LRU Cache 是一种基于最近最少使用原则的缓存淘汰算法,广泛应用于数据库、Web 服务器及操作系统中。其核心思想是利用时间局部性原理,当缓存容量满时优先淘汰最久未使用的数据。在软件层面,通常通过哈希表与双向链表的组合来实现 O(1) 时间复杂度的插入、查找和删除操作。 Cache 的概念、LRU 的特性,并提供了 C++ 的具体代码实现及 LeetCode 练习题解。
综述由AI生成AI 写作技巧对网文作家的价值,涵盖结构化文本处理、多格式文档解析及工作流定制三大核心技巧。文章提供了明确创作目标和设置分段规则的实战步骤,并指出过度依赖 AI、指令笼统及忽视审核等常见误区。最后总结了分段处理、格式统一、风格保持等五个效率提升关键点,强调 AI 作为辅助工具应服务于创作者的灵魂。