
C++AI算法
OpenCV Hough Circle 变换原理与 C++ 实现详解
OpenCV Hough Circle 变换用于检测图像中的圆形物体。基于霍夫梯度法,通过边缘检测和圆心半径搜索实现。主要步骤包括灰度化、模糊去噪、边缘检测及圆参数拟合。关键参数如 dp、min_dist、param1、param2 需根据图像特性调整。提供完整的 C++ 代码示例及参数调优指南,涵盖常见问题解决方案与应用场景分析,适用于工业检测、医疗影像等场景。
OpenCV Hough Circle 变换用于检测图像中的圆形物体。基于霍夫梯度法,通过边缘检测和圆心半径搜索实现。主要步骤包括灰度化、模糊去噪、边缘检测及圆参数拟合。关键参数如 dp、min_dist、param1、param2 需根据图像特性调整。提供完整的 C++ 代码示例及参数调优指南,涵盖常见问题解决方案与应用场景分析,适用于工业检测、医疗影像等场景。
人工智能技术发展历程涵盖三次浪潮,核心包括监督学习、无监督学习及强化学习三大范式。深度学习通过神经网络实现图像识别与序列处理,结合 Python、TensorFlow 等工具构建项目。提供从基础概念到行业应用的学习路径规划,帮助初学者避开数学过度追求或忽视实践的误区,理解 AI 在医疗、自动驾驶等领域的实际价值与发展趋势。
WebRTC 是由 Google 主导的开源项目与浏览器 API,实现点对点实时音视频通信。架构包含信令层、媒体引擎、网络传输及安全层。核心组件包括 RTCPeerConnection 管理连接生命周期,RTCDataChannel 提供低延迟数据传输,getUserMedia 获取媒体流。网络穿透依赖 ICE/STUN/TURN 框架解决 NAT 问题。安全机制强制使用 DTLS-SRTP 加密,确保端到端通信安全。
综述由AI生成Llama 模型结合 PyTorch 框架,构成了当前大模型开发与部署的主流技术栈。通过参数高效微调(PEFT)、量化加载及分布式训练,开发者能显著降低显存门槛并提升推理效率。文章解析了从环境搭建到 LoRA 微调的关键步骤,并探讨了 Torch.compile 等性能优化方案,为实际工程落地提供清晰路径。
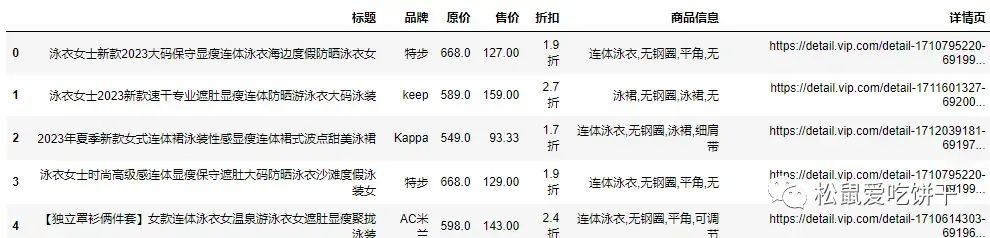
综述由AI生成演示了使用 Python 爬取唯品会泳衣商品数据的流程。通过分析网络请求接口,构建请求参数获取商品 ID 列表,进而批量抓取商品详情并存储为 CSV。随后利用 Pandas 进行数据处理,结合 PyEcharts 库绘制品牌分布饼图、售价平均柱状图及价格区间分布图,实现商品数据的直观可视化分析。
综述由AI生成深入解析了 Python 代码从源码到机器码的执行流程,涵盖解释器结构(python.exe 与 .dll)、字节码生成及虚拟机工作原理。阐述了模块、包、编译扩展的概念及 sys.path 导入机制,解释了 if __name__ == "__main__" 的作用。最后说明了虚拟环境通过隔离路径实现依赖管理的原理,并对比了不同解释器类型及现代工具差异。
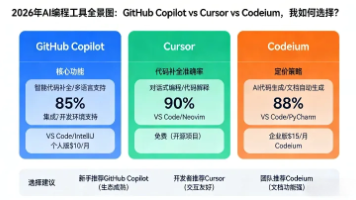
综述由AI生成对比了 GitHub Copilot、Cursor 和 Codeium 三款 AI 编程工具在鸿蒙及通用开发场景下的表现。通过实际测试代码生成准确率、重构能力及响应速度,分析了各自的优劣势。结合 2026 年价格策略,针对不同预算和需求场景给出了组合使用建议,强调根据具体任务灵活切换工具链而非依赖单一产品。
利用 GitHub Actions 结合自托管 GPU Runner 与预构建 PyTorch-CUDA 容器镜像,解决深度学习项目 CI/CD 环境不一致问题。通过配置标签精准调度任务,设定共享内存避免 DataLoader 报错,并实施安全最佳实践,实现代码提交即验证的真实 GPU 环境测试流程,提升迭代效率与稳定性。
综述由AI生成THULAC 是清华大学开发的中文词法分析工具,支持分词与词性标注。介绍其安装配置、基础用法及参数详解,涵盖 pip 安装、源码部署、自定义词典及命令行操作。通过性能对比数据展示其在准确率与速度上的优势,并列举了搜索引擎、情感分析等典型应用场景,适合需要高效中文 NLP 处理的开发者参考。
综述由AI生成详细讲解了如何使用 Python 采集电视剧《开端》的弹幕数据并进行词云可视化分析。内容包括环境搭建、网络接口分析、Requests 爬虫代码实现、Pandas 数据清洗、Jieba 中文分词以及 Pyecharts 词云图绘制。文章提供了完整的代码示例,涵盖了从数据获取到最终可视化的全流程,并对反爬策略、数据编码及停用词处理进行了说明,帮助读者掌握弹幕数据挖掘的基本方法。
C++ 多线程编程中数据竞争问题常见,互斥锁开销较大。原子操作 std::atomic 提供轻量级无锁同步方案,适用于单变量场景。文章讲解原子操作核心特性、常用接口及内存序设置,对比原子操作与互斥锁差异。通过计数器自增、线程退出标志位等实战案例,展示如何高效解决线程安全问题,避免死锁风险并提升性能。
综述由AI生成详细阐述了 LlamaIndex 库的多种安装方式及本地模型配置流程。内容包括标准 Pip 安装、自定义依赖选择以及源码编译步骤。重点展示了如何在不依赖 OpenAI 的情况下,集成 Ollama 作为大语言模型后端,并搭配 HuggingFace 进行嵌入向量处理。文中提供了完整的初始化代码示例,涵盖服务上下文配置、文档加载及索引构建,旨在帮助开发者快速搭建基于本地资源的 RAG 应用环境。
AI 绘画中提示词质量直接决定生成效果。解析 Tokenization、权重分配及负面提示词机制,提供分层构建模板与 CLIP 语义评估方案。通过对比实验展示优化前后差异,总结常见错误避坑指南,帮助开发者提升可控性与效率。
GitNexus 核心引擎通过索引流水线、社区检测与混合搜索三大子系统,将代码库转化为知识图谱。索引流水线采用 9 阶段流程配合 Worker 池并行解析,支持 TypeScript、Go、Python 等多语言导入与调用关系解析。社区检测利用 Leiden 算法进行功能聚类,流程追踪基于 BFS 算法并结合入口点评分策略。混合搜索结合 BM25 与语义向量,使用 RRF 融合结果,并支持 DirectML、CUDA 及 CPU 等多种…
综述由AI生成字节跳动联合北京交通大学开源 LatentSync 1.5,一款基于潜在扩散模型的端到端唇形同步框架。相比 1.0 版本,新版增强了时间一致性,优化了中文性能,并将显存需求降至 20GB,支持消费级显卡运行。项目提供本地部署、Windows 一键包及 ComfyUI 扩展等多种方式。实测显示其在唇形同步精度和时间连续性上优于 Wav2Lip 和 SadTalker 等开源方案,接近 HeyGen 等商业产品,是高质量数字人制作的优秀开源…
大模型凭借强大的表示与推理能力,在代码生成、数据结构操作等低抽象层次任务中展现出潜力。通过预训练与微调,模型能理解底层细节并执行复杂逻辑。Transformer 架构的注意力机制是核心支撑,但面临训练成本高、部署难及数据隐私等挑战。未来需优化算法效率与轻量化架构,推动智能开发自动化。
综述由AI生成哈希(散列)的基本概念,包括哈希函数如何将数据映射为固定长度数值。详细阐述了直接定址法和除留余数法等常见实现方法。重点讲解了哈希冲突的产生原因及解决方案,涵盖闭散列(线性探测、二次探测)和开散列(哈希桶/链地址法)。通过 C++ 代码示例展示了哈希表的数据结构、插入、查找、删除及扩容机制,对比了不同冲突解决策略的优劣。
2026 年 RAG 技术将向图检索增强生成(GraphRAG)转变,解决传统向量检索在复杂推理和上下文限制上的不足。DeepSeek 凭借强大的语义理解能力,支持高精度实体抽取与动态本体构建,结合 Neo4j 等图数据库,实现可解释的企业级智能决策。这一架构通过结构化知识图谱优化信息检索路径,满足金融、医疗等行业的合规与审计需求,标志着大模型从单纯生成向逻辑推理的实用化跨越。
探讨如何利用 LLama-Factory 框架,通过全参数微调、LoRA 及 QLoRA 等技术,在消费级显卡上训练具有特定人格的大模型。涵盖数据准备、配置优化、实时监控及模型部署全流程,提供工程实践建议与安全合规方案,帮助开发者低成本实现 AI 角色定制。
数据结构中的树与二叉树是核心基础,涵盖树的术语定义、存储方式及满二叉树、完全二叉树等特殊类型。重点解析堆的原理与大根堆实现,包含初始化、插入上浮调整、销毁等关键操作,通过完整代码示例展示顺序结构下堆的构建流程,帮助读者掌握相关算法逻辑。