
PythonAI算法
LLaMA Factory 大语言模型微调与推理指南
LLaMA Factory 涵盖安装部署、数据集构建、SFT 训练、LoRA 合并、推理及评估全流程。支持多种模型架构与量化方案,提供命令行与 WebUI 操作方式,适用于本地大模型微调场景。
LLaMA Factory 涵盖安装部署、数据集构建、SFT 训练、LoRA 合并、推理及评估全流程。支持多种模型架构与量化方案,提供命令行与 WebUI 操作方式,适用于本地大模型微调场景。
综述由AI生成四种常用排序算法:冒泡排序、快速排序、归并排序和计数排序。内容包括各算法的基本思想、详细步骤、递归与非递归实现代码、性能分析(时间复杂度、空间复杂度、稳定性)以及适用场景。重点讲解了快速排序的三数取中优化、非递归实现原理,以及计数排序的空间限制。旨在帮助读者深入理解排序算法的核心逻辑与工程实践。
滑动窗口算法是处理连续区间问题的利器。通过两道经典题——长度最小的子数组和无重复字符的最长子串,演示如何从暴力解法进阶到 O(N) 的滑动窗口方案。核心在于维护一个动态窗口,利用左右指针不回退的特性减少重复计算,配合哈希表统计频次,高效解决子串去重与求和问题。
设计一个支持重置和随机打乱的数组类,核心在于维护原始状态副本并应用 Fisher-Yates 洗牌算法。通过两个数组分别存储初始数据和当前状态,确保 reset() 能准确恢复。shuffle() 方法从后向前遍历,每次随机交换当前位置与之前任意位置元素,保证所有排列概率均等。时间复杂度 O(n),空间复杂度 O(n)。该模式适用于音乐播放器随机播放、游戏抽卡等需要可逆随机性的场景。
C++ 虚函数表(vtable)和虚指针(vptr)是实现多态的核心机制。vtable 存储虚函数地址,每个含虚函数的类生成一张;vptr 是对象内的隐藏指针,指向对应类的 vtable。动态绑定通过 vptr 定位 vtable 再调用函数实现。内存布局中 vptr 通常位于对象开头。重要细节包括只有虚函数入表、多继承可能多个 vptr、虚继承解决菱形问题、析构函数建议设为虚函数防止内存泄漏。
综述由AI生成探讨了偏好对齐(Preference Alignment)阶段的关键技术,包括通用模型蒸馏、领域模型蒸馏、模型自我提升及数据增强。通用模型蒸馏通过软标签转移知识,提升效率;领域模型蒸馏针对安全、摘要、数学求解等特定场景优化;模型自我提升利用反馈循环改进策略;数据增强通过标注和重构提高质量。这些方法共同提升模型性能、安全性与可靠性,但也面临资源消耗和复杂度挑战。
综述由AI生成基于 Qwen3.5 Plus 与 OpenClaw 框架,了商用 AI Agent 的核心适配逻辑与实战搭建步骤。重点分析了模型在工具调用、长文本及多模态场景下的优势,结合零依赖部署方案,提供了从环境配置到代码运行的完整流程。通过电商客服、数据分析等场景案例,展示了如何快速实现本地化私有部署与业务集成,为中小企业提供低门槛的智能化解决方案。
AI 工具在前后端开发中的适用性存在显著差异。后端逻辑确定性强,易构建自动化闭环,适合 AI 生成核心逻辑与性能优化;前端交互主观性强,验证周期长,AI 产出常需人工重构。文章依据 DAU 规模分层提出策略:低 DAU 期后端代码可直接上线,中 DAU 期需资深工程师介入前端体验,高 DAU 期利用 AI 辅助解决性能瓶颈。技术团队应转型 AI 驱动模式,后端侧重架构设计与测试用例,前端侧重组件库建设与规范遵循。
OpenClaw 是一款开源自托管 AI Agent 框架,主打无代码开发与微内核架构。支持本地化部署以保障数据主权,内置聊天式配置界面降低开发门槛。技术层面包含 ContextEngine 上下文管理、TaskScheduler 任务调度及多智能体协同能力。相比 LangChain 等框架,其更侧重开箱即用与企业级治理,适用于个人效率助手、企业知识管理及自动化流水线场景。
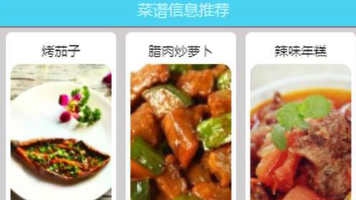
介绍基于微信小程序的健康菜谱分享网站的技术方案。采用 Python(Flask/Django)作为后端,MySQL 存储数据,结合 Redis 缓存与 CDN 加速。核心功能包括用户登录、菜谱管理、健康数据分析及 AI 推荐。系统支持容器化部署与监控,注重安全优化如 SQL 注入防护与数据加密。同时涵盖需求分析、功能设计及测试流程,并提供 uni-app 等多端适配方案。
综述由AI生成系统介绍了大模型的基础概念、工作原理及使用方法。首先区分了大模型与大语言模型的定义,指出规模体现在参数数量和训练数据量上。通过人脑类比,解释了算法、参数和训练数据的对应关系。详细阐述了大模型的工作流程,包括接收、理解、检索、组织、优化和提供回答六个步骤。分析了训练过程,涵盖数据收集、预处理、无监督/监督/强化学习、迭代训练及微调。讨论了大模型的幻觉现象及五大限制:理解深度、数据偏差、透明度、资源消耗和安全性。重点介绍了提示词工程的重要性…
JavaScript 浮点数遵循 IEEE 754 标准,导致 0.1+0.2 等计算出现误差。在电商或财务场景中,直接对浮点数进行比例分摊会引发总和不等或负数风险。核心方案是将金额转换为整数(分)运算,采用向下取整分配非末项、末项兜底剩余的策略,确保精度与总额一致。生产环境推荐此整数法而非 toFixed 或第三方库。
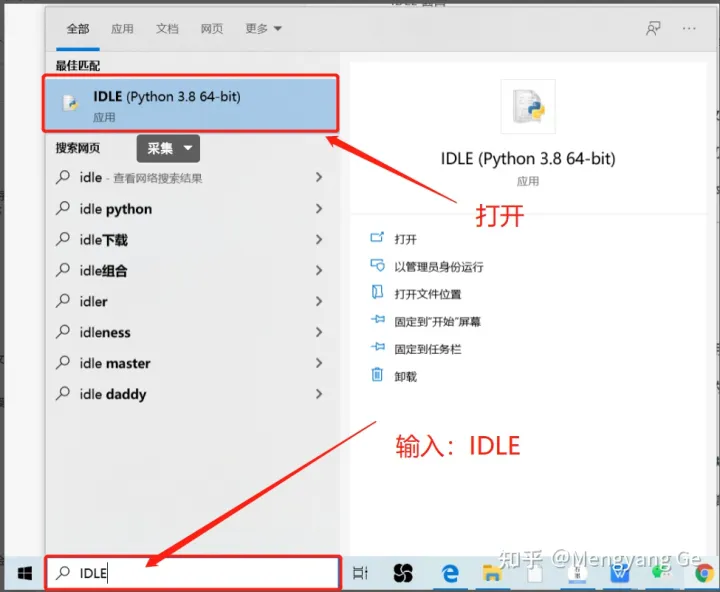
青少年软件编程 Python 等级考试一级主要讲解 Python 开发环境 IDLE 的使用、基本语法规则、变量与数据类型、运算符优先级以及 Turtle 图形库的基础操作。考试包括单选、判断和编程题,重点考察 IDLE 操作、变量命名、算术与逻辑运算优先级以及顺序结构程序设计。试卷包含单选、判断及编程题型,旨在评估考生对 Python 基础知识的理解与应用能力。

Qwen2.5-Coder 全系列开源,包含 0.5B 至 32B 六个尺寸模型。旗舰 32B-Instruct 在代码生成、修复和推理基准上表现优异,部分指标追平 GPT-4o。支持 40 多种编程语言,具备良好的人类偏好对齐能力。提供多种推理部署方案(Transformers、Ollama、vLLM)及基于 ms-swift 的微调指南。适用于代码助手、Artifacts 可视化及本地解释器等实际应用场景。
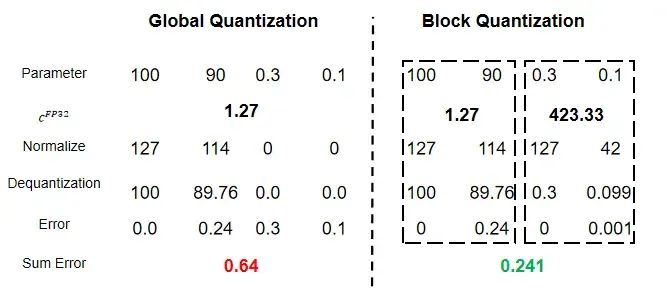
综述由AI生成详细总结了 LLM 模型微调中的 PEFT 与 QLoRA 技术。内容涵盖 QLoRA 的提出背景、量化原理(包括 NF4、双重量化、分页优化器)、实验效果对比及代码实现。重点解释了如何通过 4 位量化在不牺牲性能的前提下大幅降低显存占用,使消费级 GPU 也能微调大模型。文中包含详细的配置参数说明、训练流程代码、推理脚本及权重合并方法,并对 LoRA 与其他微调技术的差异进行了分析,适合希望深入理解大模型高效微调的技术人员参考。
综述由AI生成C++ 基础涵盖了命名空间解决标识符冲突、标准输入输出流 cin/cout、函数默认参数规则、同名函数重载机制、引用的别名特性及 const 引用权限控制、宏定义与内联函数的区别以及 nullptr 空指针表示法。掌握这些概念是编写高效、安全 C++ 代码的前提,涉及作用域查找、内存操作优化及类型安全等核心知识点。
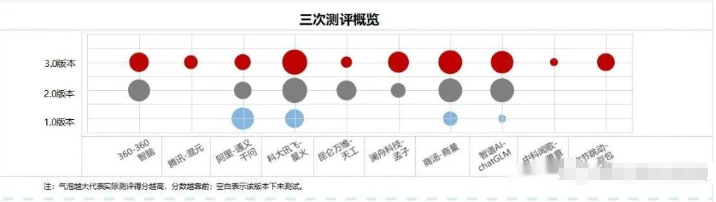
综述由AI生成主流大模型市场呈现百家争鸣态势,OpenAI 领跑,国内厂商如百度、科大讯飞等快速跟进。技术迭代迅速但面临不稳定、幻觉及安全挑战。产业融合加速,政策支持力度加大。大模型发展现状、技术难点及未来趋势,并提供了系统的学习路径建议,涵盖提示工程、RAG 架构及模型部署等内容,旨在帮助开发者理解并应用大模型技术。
决策树通过一系列规则将样本分类,利用基尼不纯度或信息熵进行分裂。单棵树易过拟合,随机森林通过 Bagging 和随机特征增加多样性,提升泛化能力。虽然树模型局部可解释性强,但集成后变黑箱,需借助 SHAP 工具分析特征贡献。相比线性模型,树模型无需特征缩放且擅长捕捉非线性关系,适合追求高精度场景,但在严格合规领域需谨慎使用。
综述由AI生成详细探讨了五种情感分类方法在 Flipkart 客户评论数据集上的应用与对比。内容涵盖从传统的 TF-IDF 结合逻辑回归,到利用预训练嵌入(如 MiniLM)的特征提取,再到无需标记数据的零样本分类,以及基于 Flan-T5 的生成模型和特定任务微调模型。文章提供了完整的数据预处理、模型训练及评估代码,分析了各方法在准确率、计算效率和数据需求方面的权衡。结果显示,预训练嵌入方法在速度与精度间取得了良好平衡,而任务特定模型在精度上表现最…
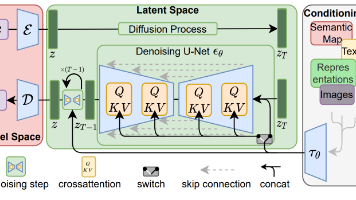
综述由AI生成潜在扩散模型(LDMs)通过感知压缩与生成学习两阶段解耦,成功破解了高分辨率图像生成中质量、效率与可控性的不可能三角。文章详细解析了 LDMs 的核心架构,包括基于感知损失的自编码器、低维潜在空间扩散以及基于交叉注意力的通用条件机制。相比传统像素级扩散模型,LDMs 在保持生成质量的同时显著降低了训练与推理成本,使扩散模型得以在消费级硬件上运行。尽管存在采样速度与显存限制等局限,LDMs 奠定了 Stable Diffusion 等技术…