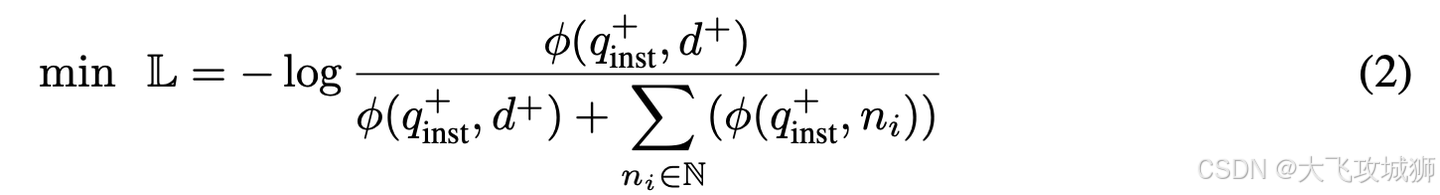Adaptive-Note RAG 框架解析:迭代信息搜集与自适应记忆审核
Adaptive-Note RAG 框架通过迭代信息搜集器(IIC)和自适应记忆审核器(AMR)解决传统 RAG 在复杂问答中的信息不足问题。IIC 利用笔记机制逐步提炼和整合检索信息,避免过早生成;AMR 基于质量对比决定何时停止检索,防止无效探索。实验显示,该方法在 2WikiMQA 等数据集上显著优于朴素 RAG 及其他自适应方法,尤其在多跳问答任务中表现突出,且在不同规模的 LLM 上均具有普适性。

Adaptive-Note RAG 框架通过迭代信息搜集器(IIC)和自适应记忆审核器(AMR)解决传统 RAG 在复杂问答中的信息不足问题。IIC 利用笔记机制逐步提炼和整合检索信息,避免过早生成;AMR 基于质量对比决定何时停止检索,防止无效探索。实验显示,该方法在 2WikiMQA 等数据集上显著优于朴素 RAG 及其他自适应方法,尤其在多跳问答任务中表现突出,且在不同规模的 LLM 上均具有普适性。

综述由AI生成大模型技术已成为人工智能领域的核心驱动力,掌握其开发技能需遵循系统的学习路径。推荐了五本关键书籍,涵盖 Python 编程基础、深度学习数学原理、机器学习实战、深度学习理论及大模型应用开发。同时提供了环境搭建指南与代码示例,帮助开发者从零开始构建知识体系,避开常见误区,实现从理论到工程落地的跨越。

综述由AI生成详细阐述了大语言模型(LLM)的学习路线与技术体系。内容涵盖基础要求(Python、数学、框架)、核心架构(Transformer 原理)、关键技术(Prompt 工程、RAG、微调、部署优化)以及系统化的学习阶段建议。旨在帮助初学者建立完整的知识框架,从理论到实践掌握 LLM 开发技能,应对实际项目需求。

综述由AI生成大模型(LLM)学习的完整资料与路线图。涵盖机器学习数学基础、Python 编程、深度学习原理及自然语言处理技术。重点解析了 Transformer 架构、监督微调(SFT)、强化学习人类反馈(RLHF)、模型评估与量化技术。推荐了包括 GitHub 开源课程在内的多种学习资源,并规划了从系统设计到行业应用开发的七个进阶阶段,适合希望掌握大模型开发与应用的开发者参考。

RAG(检索增强生成)结合信息检索与大语言模型,解决知识时效性与幻觉问题。其核心原理、架构设计、工作流程及 Python 实现方案,涵盖向量数据库选型、检索优化策略及常见挑战应对,为构建企业级知识库问答系统提供完整技术指南。

综述由AI生成LLaMA Factory 是一个统一的开源框架,集成了多种高效微调技术如 LoRA、QLoRA、DoRA 等,支持 100 多个大模型的指令监督微调、奖励模型训练及推理部署。 LLM 微调的技术背景,包括优化型和计算型方法,并提供了 LLaMA Factory 的部署安装步骤、WebUI 界面操作指南以及核心架构解析。通过可视化配置和无需编写代码的方式,用户可快速完成模型微调流程,显著降低显存占用与学习成本,适用于天文、法律、医疗等多…

综述由AI生成深入解析了检索增强生成(RAG)技术的实战应用与架构设计。内容涵盖 RAG 的背景、面临的检索质量、增强过程及生成质量三大挑战,详细阐述了产品与技术架构。重点讲解了 Query 理解的四大模块(意图识别、改写、扩写、重构),检索模型的核心组件(文档加载、文本转换、嵌入、向量数据库),以及生成模型的回复策略与 Prompt 拼接方法。此外,还探讨了基于演示检索的上下文学习插件、引用归因生成机制以及 RAG 系统的评估指标与方法(RGB、R…

综述由AI生成汇总了 AI 大模型领域的免费学习资源,涵盖提示词工程、官方文档、开源课程、开发框架及理论基础。内容包括 PromptingGuide、OpenAI 文档、LearnPrompt、LangChain、DataWhale 系列教程、D2L 深度学习教材、微软 AI 课程及清华 NLP 公开课等。文章还梳理了从基础到进阶的学习路径,以及面试准备建议,旨在帮助开发者系统性地掌握大模型技术并应用于实际项目。

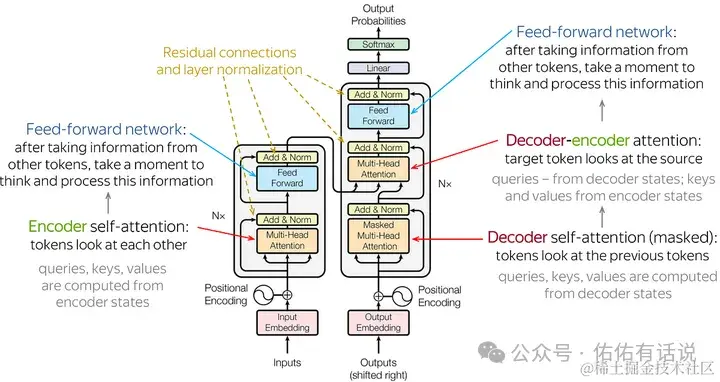
综述由AI生成详细梳理了 AI 产品经理面试的核心考点,涵盖 Attention 机制、Transformer 架构、BERT 模型及 ChatGPT 的 RLHF 训练原理等理论基础。同时深入探讨了 AI 产品开发中的数据质量管理、人机协作平衡、对话系统与问答系统差异以及 AI 产品与传统产品的本质区别。文章旨在帮助求职者构建完整的技术认知体系,掌握从理论到落地的关键技能,应对大模型时代的岗位挑战。

综述由AI生成大语言模型是基于海量文本数据训练的深度学习模型,核心架构通常为 Transformer。文章介绍了 LLM 的基本特点如大规模参数、自注意力机制及预训练能力,详细阐述了从数据预处理到推理的工作流程。内容涵盖词嵌入、编码器解码器、损失函数等组成部分,解释了参数量对模型性能的影响。此外,还说明了预训练模型的概念及 Hugging Face transformers 库的使用方法,并补充了应用场景与未来挑战,为初学者理解部署开源大模型提供基础…

综述由AI生成深入对比了检索增强生成(RAG)与微调(Fine-tuning)两种大型语言模型增强策略。文章详细阐述了 RAG 通过外部知识库检索提升上下文理解能力的原理及其优缺点,同时也分析了微调在特定任务适应性和推理效率上的优势与局限。通过技术对比表格、Python 代码示例及实施建议,为开发者提供了选择合适技术方案的综合指南,指出在实际应用中结合两者优势的混合架构往往是最佳实践。

综述由AI生成LoRA 是一种参数高效微调方法,通过低秩分解模拟权重更新,显著降低训练成本。系统总结了 LoRA 的核心原理、数学推导及实战经验,涵盖从基础概念到高级优化的完整知识体系。内容包括 Rank 与 Alpha 参数选择策略、内存优化技巧、与全量微调的对比分析,以及基于 HuggingFace PEFT 的代码实现示例。此外,还介绍了 DoRA、QLoRA 等进阶变体技术,并提供了针对过拟合、显存溢出等常见问题的解决方案,适合希望深入掌握大…

综述由AI生成梳理了人工智能领域核心技术栈,涵盖机器学习、深度学习、自然语言处理及大模型开发等方向。详细解析了从系统设计与提示词工程到微调开发与多模态应用的七阶段学习路线,介绍了 LangChain 框架应用、垂直领域模型训练及行业落地方案。内容旨在帮助开发者构建完整的 AI 知识体系,掌握 GPU 算力调度、硬件部署及企业级 AI 应用开发技能,为应对大厂面试及技术进阶提供参考。

综述由AI生成对大模型初学者,梳理了从系统设计到微调开发的学习路径,并推荐了五本涵盖 Python 基础、数学原理、机器学习、深度学习及大模型应用的核心书籍。内容旨在帮助读者建立扎实的知识体系,掌握提示词工程、LangChain 框架及垂直领域模型训练等关键技能,为进入人工智能领域打下基础。

综述由AI生成详细探讨了 RAG 与 GraphRAG 应用中知识文档增量更新的技术方案。文章首先分析了文档级与块级两种更新策略的需求,提出了基于 Hash 指纹与状态跟踪的核心原理。随后分别展示了 LangChain 的 index API 与 LlamaIndex 的 Ingestion Pipeline 的具体实现代码,重点解释了 cleanup 参数的不同模式及其影响。此外,还介绍了 nano-GraphRAG 在图谱层面的增量更新思路,并针…

综述由AI生成综述了小型语言模型(SLMs)的架构设计、训练技术及模型压缩方法。内容涵盖轻量化架构、高效自注意力近似、神经架构搜索及多模态模型,并讨论了预训练、微调策略如 LoRA 和数据增强,以及剪枝、量化等技术。文章还总结了评估基准与指标,分析了边缘计算、隐私保护和成本节约等应用场景,并指出了性能权衡、数据稀缺、硬件适配及安全对齐等未来挑战,旨在为资源受限场景下的模型部署提供指导。

RAG(检索增强生成)通过结合外部知识库与大语言模型,有效解决幻觉和知识过时问题。提供一份详细的 5 天学习路线图,涵盖 RAG 基础原理、检索系统构建、生成模型微调、可运行系统集成及性能优化评估,帮助开发者快速掌握 RAG 核心技术栈与工程实践方法。

人工智能大模型(LLM)面试的核心问题与解答,涵盖基础架构、微调技术(SFT/PEFT)、LangChain 应用、推理优化、评测标准及硬件配置等关键领域。内容涉及 Transformer 原理、位置编码、归一化方法、分词器机制以及 LoRA、QLoRA 等高效微调策略,旨在帮助开发者系统掌握大模型开发技能与面试要点。

综述由AI生成综述了近十年视觉任务中的对抗攻击研究。内容涵盖对抗性、可迁移性和泛化性等关键概念,将传统对抗攻击分为基础策略和攻击增强两个阶段,详细分析了单步、迭代、优化、搜索及生成模型等方法。文章还探讨了大型视觉 - 语言模型(LVLM)中的新型攻击模式,包括提示注入和越狱技术,对比了传统与 LVLM 攻击的联系与区别。最后总结了威胁模型、评估方法及防御策略,为未来研究提供了方向。

综述由AI生成大模型虽具备文本表征能力,但在检索场景中仍依赖专用 Embedding 模型以降低延迟与成本。介绍一种利用 LLM 生成合成数据改进文本嵌入的方法。该方法通过两步提示策略生成覆盖百种语言的查询 - 文档对,结合对比学习与 InfoNCE 损失函数进行微调。实验显示,无需标记数据即可在 MTEB 基准上取得优异性能,结合少量标记数据微调更能达到 SOTA 水平。该技术有效降低了数据标注成本,提升了语义检索的鲁棒性。