
跳到主要内容
极客日志极客日志面向AI+效率的开发者社区
首页博客我的书AI学习GitHub 精选镜像AI工具UI配色美学关于
搜索内容 / 工具 / 仓库 / 镜像...⌘K搜索
注册
博客列表
编程语言AI算法

中国人工智能大模型技术发展白皮书深度解析

深度解析了中国人工智能大模型技术发展白皮书,系统梳理了大模型技术演进历程、关键技术要素及未来展望。文章详细阐述了从统计语言模型到大模型的发展脉络,重点介绍了 Transformer 架构、预训练与微调范式、多模态技术体系以及开源生态现状。内容涵盖大模型在开发训练、推理部署、软硬件适配等方面的实践要点,并列举了其在金融、医疗、教育、制造等行业的广泛应用场景。同时,文章深入探讨了大模型面临的安全风险、治理政策及对齐技术,强调了构建自主可控技术栈与完善安全评测体系的重要性,为大模型技术的健康发展提供了全面的技术视角与战略思考。

黑客发布于 2025/2/6更新于 2026/10/2689 浏览
中国人工智能大模型技术发展白皮书深度解析

中国人工智能大模型技术发展白皮书深度解析

第 1 章 大模型技术概述

1.1 大模型技术的发展历程

自 2006 年 Geoffrey Hinton 提出通过逐层无监督预训练攻克深层网络训练难题以来,深度学习在众多领域均取得了显著的突破。其发展历程从最初的标注数据监督学习,逐渐演进到预训练模型,最终迈向大模型的新纪元。2022 年底,OpenAI 发布的 ChatGPT 凭借其卓越的性能引发了广泛的关注,充分展现了大模型在处理多场景、多用途、跨学科任务时的强大能力。因此,大模型被普遍认为是未来人工智能领域不可或缺的关键基础设施。

在这场技术热潮中,语言大模型作为领军者,通过大规模预训练学习了丰富的语言知识与世界知识,进而拥有了面向多任务的通用求解能力。其发展脉络清晰可见,历经统计语言模型、神经语言模型、预训练语言模型,直至现在的语言大模型(探索阶段)的四个阶段。

  1. 统计语言模型:虽然基于马尔可夫假设,但由于数据稀疏问题的影响,其能力有限,难以捕捉长距离依赖关系。
  2. 神经语言模型:通过神经网络对语义共现关系进行建模,成功地捕获了复杂语义依赖,显著提升了表示能力。
  3. 预训练语言模型:采用'预训练 + 微调'的范式,通过自监督学习使模型能够适配各种下游任务,如 BERT 等架构的出现标志着这一阶段的成熟。
  4. 大模型:基于缩放定律(Scaling Law)。简单来说就是,随着模型参数和预训练数据规模的不断增加,模型的能力与任务效果会持续提升,甚至展现出了一些小规模模型所不具备的独特'涌现能力'。

1.2 大模型技术的生态发展

当前,大模型技术生态正在蓬勃发展,多种服务平台向个人用户和商业应用开放。OpenAI API 让用户轻松访问不同 GPT 模型以完成任务。Anthropic 的 Claude 系列模型强调有用性、诚实性和无害性。百度文心一言基于知识增强的大模型,提供开放服务和插件机制。讯飞星火认知大模型具备开放式知识问答、多轮对话、逻辑和数学能力,以及对代码和多模态的理解能力。此外,华为联合发布了支持大模型训练私有化的'星火一体机',推动了企业级部署的落地。

1.3 大模型技术的风险与挑战

然而,大模型技术依然面临诸多风险与挑战。其可靠性尚未得到充分保障,合成内容在事实性和时效性上仍存在缺陷。大模型的可解释性相对较弱,其工作原理难以透彻理解。此外,应用大模型的部署成本高昂,涉及大量训练和推理计算,功耗高,应用成本高,且端侧推理存在延迟等问题。在大数据匮乏的情况下,大模型的迁移能力受到制约,鲁棒性和泛化性面临严峻挑战。更为严重的是,大模型还存在被滥用于生成虚假信息、恶意引导行为等衍生技术风险,以及安全与隐私问题。

第 2 章 语言大模型技术

2.1 Transformer 架构

Transformer 架构是当今大模型的核心基石。它摒弃了传统的循环神经网络(RNN)结构,完全基于注意力机制(Attention Mechanism)来处理序列数据。Self-Attention 机制允许模型在处理任意两个位置的关系时直接建立连接,无论它们之间的距离有多远,从而有效解决了长序列训练中的梯度消失问题。多头注意力机制(Multi-Head Attention)则让模型能够从不同的子空间同时关注信息,增强了表征能力。位置编码(Positional Encoding)的引入弥补了 Transformer 缺乏顺序信息的短板,使其能够理解文本的时序结构。

2.2 语言大模型架构

2.2.1 掩码语言建模 (MLM)

掩码语言建模是双向上下文建模的典型代表,如 BERT 模型。该方法随机掩盖输入序列中的一部分 token,要求模型根据左右两侧的上下文信息预测被掩盖的内容。这种训练方式极大地增强了模型对语义的理解能力,特别适用于分类、抽取等判别式任务。

2.2.2 自回归语言建模 (AR)

自回归语言建模是单向生成的基础,如 GPT 系列模型。模型按从左到右的顺序预测下一个 token,仅利用左侧的历史信息。这种方式更适合生成式任务,如文本续写、对话生成等,能够产生连贯的自然语言输出。

2.2.3 序列到序列建模 (Seq2Seq)

序列到序列建模结合了编码器和解码器结构,常用于机器翻译等任务。编码器将输入序列压缩为隐状态,解码器根据该状态生成输出序列。在大模型时代,这种架构演变为更高效的 Encoder-Decoder 混合模式,兼顾了理解与生成的优势。

2.3 语言大模型关键技术

2.3.1 语言大模型的预训练

预训练是大模型能力的来源。通过在海量无标注文本上进行自监督学习,模型学习到了语言的语法、常识及逻辑推理能力。预训练目标通常包括 Next Token Prediction 或 Masked Language Modeling。为了提升效率,研究者采用了混合精度训练、梯度累积等技术来应对显存限制。

2.3.2 语言大模型的适配微调

为了让通用模型适应特定领域,需要进行微调。全量微调(Full Fine-tuning)效果最好但成本高;参数高效微调(PEFT)如 LoRA、QLoRA 则通过冻结大部分参数并训练少量适配器,大幅降低了资源需求,使得单卡微调成为可能。

2.3.3 语言大模型的提示学习

提示学习(Prompt Learning)旨在通过设计特定的输入模板来激发模型的潜在能力,无需更新模型参数。少样本学习(Few-Shot Learning)是其中一种形式,通过提供少量示例引导模型完成新任务。思维链(Chain-of-Thought, CoT)提示技术则鼓励模型展示推理步骤,显著提升了复杂逻辑任务的表现。

2.3.4 语言大模型的知识增强

大模型虽然参数量巨大,但其内部知识仍可能过时或不准确。知识增强技术通过外挂知识库(Knowledge Base)或检索增强生成(RAG),让模型在生成答案时参考外部权威信息,减少幻觉现象,提高回答的准确性和时效性。

2.3.5 语言大模型的工具学习

工具学习(Tool Learning)赋予大模型调用外部程序的能力,如搜索、计算器、API 接口等。这使得模型不再局限于静态文本生成,而是能够执行动态操作,解决需要实时数据或精确计算的复杂问题。

第 3 章 多模态大模型技术

3.1 多模态大模型的技术体系

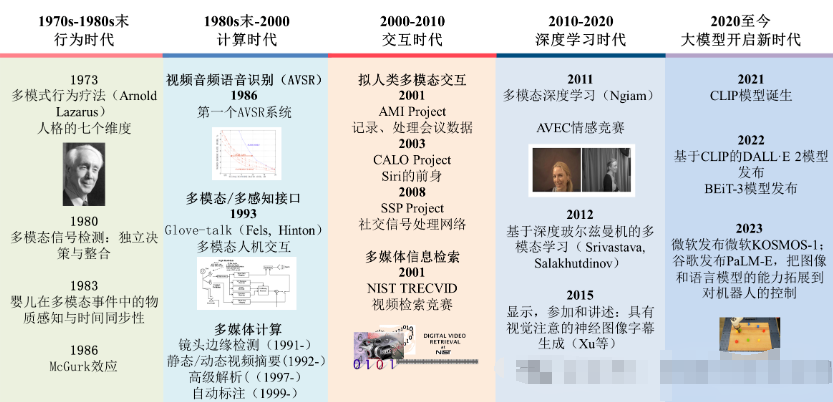
多模态大模型旨在统一处理文本、图像、音频、视频等多种模态的数据。

3.1.1 面向理解任务的多模态大模型

此类模型侧重于从多模态输入中提取语义信息,例如图像描述生成(Image Captioning)、视觉问答(VQA)。核心在于构建强大的视觉编码器,将图像特征映射到与文本相同的语义空间。

3.1.2 面向生成任务的多模态大模型

此类模型侧重于根据文本指令生成图像或视频,如 Stable Diffusion、DALL-E。扩散模型(Diffusion Model)是目前的主流技术,通过逐步去噪过程从随机噪声中生成高质量图像。

3.1.3 兼顾理解和生成任务的多模态大模型

统一架构模型试图在一个框架下同时实现理解与生成,如 Flamingo、LLaVA。这类模型通常将视觉编码器与大语言模型(LLM)结合,通过投影层对齐特征,实现了图文互动的闭环。

3.1.4 知识增强的多模态大模型

结合外部知识图谱或多模态数据库,进一步提升模型对现实世界的认知能力,解决纯视觉或纯文本模型在常识推理上的不足。

3.2 多模态大模型的关键技术

3.2.1 多模态大模型的网络结构设计

常见的结构包括 Cross-Attention 模块,用于融合不同模态的特征。此外,Q-Former 等轻量级查询机制也被广泛使用,以降低计算开销并提升对齐效率。

3.2.2 多模态大模型的自监督学习优化

利用大规模图文对数据进行对比学习(Contrastive Learning),拉近匹配图文的距离,推远不匹配图文的距离,从而学习到通用的多模态表示。

3.2.3 多模态大模型的下游任务微调适配

针对特定任务如医疗影像分析、工业质检等进行微调,通常需要高质量的标注数据集,并采用领域自适应技术防止灾难性遗忘。

第 4 章 大模型技术生态

4.1 典型大模型平台

目前市场上已有多个成熟的商业平台,提供 API 接入、模型托管及开发工具。这些平台降低了大模型的使用门槛,使得中小企业也能快速集成 AI 能力。

4.2 典型开源大模型

开源生态是推动技术普惠的关键力量。

4.2.1 典型开源语言大模型

LLaMA 系列由 Meta 发布,开启了开源大模型的新篇章。Falcon 和 GLM 系列也表现优异。Baichuan 系列模型支持中英双语,使用高质量训练数据,表现卓越,并开源了多种量化版本。CPM 系列在中文 NLP 任务上表现出色。

4.2.2 典型开源多模态大模型

Stable Diffusion 是开源图像生成的标杆。LLaVA 系列则在多模态对话领域取得了突破,证明了开源社区在创新上的活力。

4.3 典型开源框架与工具

开源框架如 PyTorch 和飞桨支持大规模分布式训练,OneFlow 则支持动静态图的灵活转换,而 DeepSpeed 则通过减少冗余内存访问以训练更大模型。Hugging Face Transformers 提供了统一的模型接口,加速了研发流程。

4.4 大模型的训练数据

4.4.1 大模型的训练数据处理流程和特点

数据处理包括清洗、去重、分词、质量过滤等环节。高质量数据是模型性能的上限,因此数据工程的重要性日益凸显。

4.4.2 大模型常用的公开数据集

Common Crawl、Wikipedia、GitHub 代码库、ArXiv 论文等构成了主要的预训练语料。针对垂直领域,还有专门的医学、法律、金融数据集。

第 5 章 大模型的开发训练与推理部署

5.1 大模型开发与训练

开发大模型需要庞大的算力集群支持。分布式训练策略如数据并行、模型并行、流水线并行是标配。混合精度训练(FP16/BF16)能有效节省显存并加速计算。Checkpoint 机制确保训练中断后可恢复。

5.2 大模型推理部署

5.2.1 大模型压缩

为了降低部署成本,常采用量化(Quantization)技术,将 FP16 权重转换为 INT8 甚至 INT4,在几乎不损失精度的情况下减少显存占用。剪枝(Pruning)和蒸馏(Distillation)也是常用手段。

5.2.2 大模型推理与服务部署

推理引擎如 vLLM、TensorRT-LLM 通过 PagedAttention 等技术优化显存管理,大幅提升吞吐量。服务部署需考虑负载均衡、弹性伸缩及高可用架构。

5.3 软硬件适配与协同优化

5.3.1 大模型的软硬件适配

针对 NVIDIA GPU、国产昇腾芯片等不同硬件,需进行算子层面的优化,以发挥最大性能。

5.3.2 大模型的软硬件协同优化

从系统层面优化通信带宽、存储层次,结合软件调度算法,实现端到端的效率提升。

第 6 章 大模型应用

大模型技术的应用场景广泛无比,为各行各业注入了新的活力。

  • 信息检索:智能搜索助手能理解自然语言提问,直接给出答案而非链接列表。
  • 新闻媒体:辅助撰写新闻稿、自动生成摘要,提高生产效率。
  • 智慧城市:优化交通流量控制、能源调度,提升城市治理水平。
  • 生物科技:蛋白质结构预测(如 AlphaFold)、药物分子筛选,加速科研进程。
  • 智慧办公:智能文档处理、会议纪要生成、邮件自动回复。
  • 影视制作:剧本辅助创作、视频特效生成、角色配音。
  • 智能教育:个性化辅导老师、作业批改、知识点讲解。
  • 智慧金融:风险评估、智能投顾、反欺诈检测。
  • 智慧医疗:辅助诊断、病历结构化、健康咨询。
  • 智慧工厂:设备故障预测、生产流程优化、质量检测。
  • 生活服务:智能客服、旅游规划、购物推荐。
  • 智能机器人:赋予机器人更强的环境理解与交互能力。
  • 其他应用:涵盖游戏、艺术创作、法律咨询等多个领域。

大模型都能显著降低生产成本,提高作品质量,助力产品营销,增强决策能力,使教育方式更加个性化和智能化,提高金融服务质量,赋能医疗机构诊疗全过程。更重要的是,大模型被认为是未来人工智能应用中的关键基础设施,能够带动上下游产业的革新,形成协同发展的生态,对经济、社会和安全等领域的智能化升级形成关键支撑。

第 7 章 大模型的安全性

7.1 大模型安全风险引发全球广泛关注

随着大模型能力的增强,其潜在风险也引起了各国政府和国际组织的重视。不当使用可能导致隐私泄露、偏见传播甚至社会动荡。

7.2 大模型安全治理的政策法规和标准规范

各国纷纷出台相关法规,如欧盟的《人工智能法案》、中国的《生成式人工智能服务管理暂行办法》,要求开发者落实主体责任,确保内容安全合规。

7.3 大模型安全风险的具体表现

7.3.1 大模型自身的安全风险

包括模型幻觉(Hallucination)、偏见(Bias)、毒性内容生成等。这些问题源于训练数据的偏差或模型架构的局限性。

7.3.2 大模型在应用中衍生的安全风险

如提示词注入(Prompt Injection)、越狱攻击(Jailbreaking)、数据投毒等。攻击者可能诱导模型输出敏感信息或执行恶意操作。

7.4 大模型安全研究关键技术

7.4.1 大模型的安全对齐技术

通过人类反馈强化学习(RLHF)或基于规则的奖励模型,调整模型输出以符合人类价值观和安全准则。

7.4.2 大模型安全性评测技术

建立标准化的评测基准(Benchmark),定期测试模型在各类安全场景下的表现,及时发现漏洞并修复。

第 8 章 总结与思考

8.1 协同多方合作,共同推动大模型发展

大模型的发展需要学术界、产业界和政府部门的紧密协作,共享资源,制定标准,避免重复建设。

8.2 建立大模型合规标准和评测平台

构建中立、透明的第三方评测体系,对模型能力与安全进行全面评估,为行业提供参考依据。

8.3 应对大模型带来的安全性挑战

持续投入安全研究,开发更有效的防御机制,平衡技术创新与风险控制。

8.4 开展大模型广泛适配,推动大模型技术栈自主可控

加强底层软硬件的自主研发,减少对单一供应链的依赖,确保国家信息安全与技术主权。

大模型技术,以其广阔的应用前景和巨大潜力,无疑成为了技术发展的焦点。然而,随之而来的挑战亦不容忽视:可靠性、可解释性的难题需要我们去攻克,数据质量与数量的提升成为迫切需求,应用部署成本的降低与迁移能力的增强同样重要,而安全与隐私保护的强化更是关键中的关键。此外,探索更为贴合实际、具备落地价值的应用场景,亦是我们需要努力的方向。这些挑战与机遇并存,将决定大模型技术未来的广泛应用与发展命运。

目录

  1. 中国人工智能大模型技术发展白皮书深度解析
  2. 第 1 章 大模型技术概述
  3. 1.1 大模型技术的发展历程
  4. 1.2 大模型技术的生态发展
  5. 1.3 大模型技术的风险与挑战
  6. 第 2 章 语言大模型技术
  7. 2.1 Transformer 架构
  8. 2.2 语言大模型架构
  9. 2.2.1 掩码语言建模 (MLM)
  10. 2.2.2 自回归语言建模 (AR)
  11. 2.2.3 序列到序列建模 (Seq2Seq)
  12. 2.3 语言大模型关键技术
  13. 2.3.1 语言大模型的预训练
  14. 2.3.2 语言大模型的适配微调
  15. 2.3.3 语言大模型的提示学习
  16. 2.3.4 语言大模型的知识增强
  17. 2.3.5 语言大模型的工具学习
  18. 第 3 章 多模态大模型技术
  19. 3.1 多模态大模型的技术体系
  20. 3.1.1 面向理解任务的多模态大模型
  21. 3.1.2 面向生成任务的多模态大模型
  22. 3.1.3 兼顾理解和生成任务的多模态大模型
  23. 3.1.4 知识增强的多模态大模型
  24. 3.2 多模态大模型的关键技术
  25. 3.2.1 多模态大模型的网络结构设计
  26. 3.2.2 多模态大模型的自监督学习优化
  27. 3.2.3 多模态大模型的下游任务微调适配
  28. 第 4 章 大模型技术生态
  29. 4.1 典型大模型平台
  30. 4.2 典型开源大模型
  31. 4.2.1 典型开源语言大模型
  32. 4.2.2 典型开源多模态大模型
  33. 4.3 典型开源框架与工具
  34. 4.4 大模型的训练数据
  35. 4.4.1 大模型的训练数据处理流程和特点
  36. 4.4.2 大模型常用的公开数据集
  37. 第 5 章 大模型的开发训练与推理部署
  38. 5.1 大模型开发与训练
  39. 5.2 大模型推理部署
  40. 5.2.1 大模型压缩
  41. 5.2.2 大模型推理与服务部署
  42. 5.3 软硬件适配与协同优化
  43. 5.3.1 大模型的软硬件适配
  44. 5.3.2 大模型的软硬件协同优化
  45. 第 6 章 大模型应用
  46. 第 7 章 大模型的安全性
  47. 7.1 大模型安全风险引发全球广泛关注
  48. 7.2 大模型安全治理的政策法规和标准规范
  49. 7.3 大模型安全风险的具体表现
  50. 7.3.1 大模型自身的安全风险
  51. 7.3.2 大模型在应用中衍生的安全风险
  52. 7.4 大模型安全研究关键技术
  53. 7.4.1 大模型的安全对齐技术
  54. 7.4.2 大模型安全性评测技术
  55. 第 8 章 总结与思考
  56. 8.1 协同多方合作,共同推动大模型发展
  57. 8.2 建立大模型合规标准和评测平台
  58. 8.3 应对大模型带来的安全性挑战
  59. 8.4 开展大模型广泛适配,推动大模型技术栈自主可控

更多推荐文章

查看全部
  • 早期项目复盘:基于 Spring Cloud 的统一认证与业务实践
  • JDK 自带工具 jmap:Java 堆内存分析与排查实战
  • ROS2 中的 TF 系统:机器人坐标系管理
  • SubtitleEdit Purfview Faster Whisper XXL 引擎安装失败修复指南
  • 基于 AI 大模型与 Playwright 的 Web UI 自动化测试实践
  • AutoGPT 与 Python:构建自主 AI 智能体的实战指南
  • OpenClaw Web Search 工具配置与渠道详解
  • AI 大模型:何时使用或不使用 GraphRAG
  • 阿里开源纯前端浏览器自动化框架 PageAgent 深度解析
  • 通义万相 2.1:基于 C++ 的高效 AI 视频生成实践
  • 从 2025 看 2026 前端发展趋势
  • Linux 进程优先级与 O(1) 调度算法解析
  • Go Web 必备理论
  • 如何在 GitHub Copilot 中使用 MCP 服务
  • Spring 事务与传播机制详解
  • 使用通义千问 API 实现非结构化数据提取与分析
  • FPGA 实现任意角度图像旋转原理与代码设计
  • iPhone 两秒出图,目前最快的移动端 Stable Diffusion 模型
  • AI 驱动 PCB 设计:自然语言生成电路板方案
  • 国产大模型挑战 2024 高考:作文数学物理三科评测结果分析

相关免费在线工具

  • 加密/解密文本

    使用加密算法(如AES、TripleDES、Rabbit或RC4)加密和解密文本明文。 在线工具,加密/解密文本在线工具,online

  • RSA密钥对生成器

    生成新的随机RSA私钥和公钥pem证书。 在线工具,RSA密钥对生成器在线工具,online

  • Mermaid 预览与可视化编辑

    基于 Mermaid.js 实时预览流程图、时序图等图表,支持源码编辑与即时渲染。 在线工具,Mermaid 预览与可视化编辑在线工具,online

  • 随机西班牙地址生成器

    随机生成西班牙地址(支持马德里、加泰罗尼亚、安达卢西亚、瓦伦西亚筛选),支持数量快捷选择、显示全部与下载。 在线工具,随机西班牙地址生成器在线工具,online

  • Gemini 图片去水印

    基于开源反向 Alpha 混合算法去除 Gemini/Nano Banana 图片水印,支持批量处理与下载。 在线工具,Gemini 图片去水印在线工具,online

  • Base64 字符串编码/解码

    将字符串编码和解码为其 Base64 格式表示形式即可。 在线工具,Base64 字符串编码/解码在线工具,online