

PythonAI算法
2024 年 LLM 大模型学习路线:从入门到实战
详细梳理了 2024 年 LLM 大模型的学习路线,涵盖从基础架构理解到行业应用落地的全过程。内容包括大模型分类(NLP、CV、多模态等)、七大学习阶段(系统设计、提示词工程、RAG、微调、多模态实战等)、不同背景人群的适配方案以及核心能力提升点。文章提供了 Python 和 LangChain 的代码示例,旨在帮助读者系统掌握大模型技术,适应 AI 时代的…
发布于 2025/2/7102 浏览0 点赞

博客作者
必有回响
314
已发布文章
8.3K
博客获赞
456K
博客浏览
第 15 页
详细梳理了 2024 年 LLM 大模型的学习路线,涵盖从基础架构理解到行业应用落地的全过程。内容包括大模型分类(NLP、CV、多模态等)、七大学习阶段(系统设计、提示词工程、RAG、微调、多模态实战等)、不同背景人群的适配方案以及核心能力提升点。文章提供了 Python 和 LangChain 的代码示例,旨在帮助读者系统掌握大模型技术,适应 AI 时代的…

详细阐述了 Python 在网络数据采集、Web 开发及数据分析领域的兼职应用。内容涵盖常见项目类型、核心技术栈(Requests、Selenium、Pandas)、反爬机制应对策略以及代码实战示例。同时强调了项目管理中的需求确认、报价合同、时间分配及法律合规风险,为希望利用 Python 技能开展副业的开发者提供了系统的技术路径与商业指导。

大模型推理涉及预填充和解码两个阶段,分别处理提示输入和生成新 token。在线推理用于实时交互,离线推理用于批处理任务。关键性能指标包括延迟、吞吐量、首 Token 时间(TTFT)和每输出 Token 时间(TPOT)。内存管理核心在于 KV Cache 的优化,通过分页注意力等技术提升利用率。主流推理框架如 vLLM、TensorRT-LLM 等各有特点…

医疗大模型成为 AI 落地关键场景。互联网大厂依托通用模型与数据积累入局,垂直医疗企业凭借专业数据与业务场景跟进。面临容错率低、隐私保护及数据标准化等挑战。技术实现涉及微调、RAG 及知识图谱融合,需持续打磨以确保安全有效。

探讨了大模型 LLM 在数据领域的四大核心应用场景。首先介绍了利用 Embedding 技术替代传统关键词搜索,通过向量数据库实现语义检索,解决同义词匹配难题。其次阐述了搭建基于 RAG 架构的领域知识库,通过文档切块、向量化存储和检索增强生成,满足行业知识问答与数据隐私保护需求。第三部分讲解了 Text2SQL 技术,使自然语言能直接转换为 SQL 查询并…

Flutter 缓存管理库 flutter_cache_manager 的核心功能与使用方法。该库支持下载和缓存应用目录中的文件,利用 Cache-Control 和 ETag 头部高效管理文件生命周期。内容涵盖基础文件获取、图片缓存、自定义配置(包括过期时间、数量限制、存储仓库)、常见问题解答以及 v2 版本的破坏性变更说明。文章强调了 Key 唯一性的重…

对比了 UniApp 与 Flutter 两款主流跨平台开发框架。UniApp 基于 Vue 语法,上手快且支持小程序,但依赖 WebView 渲染;Flutter 采用自研引擎,UI 一致性好、性能优,但需学习 Dart 语言。文章指出性能要求极高时应选原生,并提供了详细的 Flutter 学习路径,涵盖 Dart 异步编程、Widget 布局、状态管理及…

如何使用 LLaMA-Factory 工具在云 GPU 环境下对 Llama3 模型进行微调。内容包括模型微调的基本概念、LLaMA-Factory 的核心优势与功能特性、基于 Paperspace 的环境搭建流程、WebUI 界面操作指南以及命令行配置详解。文中提供了完整的代码示例,涵盖依赖安装、数据集准备、训练参数配置(如 LoRA、QLoRA、SFT…

大语言模型训练面临显存与通信瓶颈,了 CPU Offload、Checkpointing、量化压缩等显存优化技术,以及 Ring AllReduce、混合精度训练等通信与精度策略。重点阐述了 Zero 优化器的三个阶段及其显存节省原理,对比了数据并行、流水线并行、张量并行及 3D 并行的优缺点。此外,文章提供了 Transformer 架构的 FLOPs 计…

如何在本地环境中部署 Ollama 与 OpenWebUI 以实现大型语言模型的交互式聊天。内容涵盖 Ollama 的安装方法(Mac、Windows、Linux)、模型管理与自定义 Modelfile 配置,以及基于 Docker 部署 OpenWebUI 的具体步骤。此外,还补充了跨服务器连接、API 兼容性设置、常见问题排查及高级功能配置指南,帮助用户…

详细解析了大型语言模型(LLM)的核心架构,涵盖 GPT 模型的基本原理与 Transformer 架构的关键组件。内容从神经网络基础出发,逐步推导至注意力机制、前馈网络及位置编码的实现细节,并对比了编码器与解码器在序列生成任务中的不同作用。通过矩阵运算与统计概念补充,帮助读者理解模型底层逻辑,为掌握大模型开发与应用奠定理论基础。

大模型应用开发工程师所需掌握的核心技术与实战路径。内容涵盖提示词工程、检索增强生成 (RAG)、大模型微调 (Fine-tuning) 及智能体 (Agent) 架构的原理与应用。同时分析了 LangChain 等主流开发框架的使用,并通过电商试衣、物流问答、医疗垂直模型等案例展示了技术落地方案。文章最后梳理了从基础编程到 AI 工程化的技能树,为开发者提供…

大模型微调效果高度依赖数据质量。介绍微调概念、与 RAG 的区别及基本步骤,重点阐述数据集清洗、标注与格式化的重要性。通过单轮客服对话、多轮讽刺聊天及图文多模态三个实例,展示 JSON Lines 格式的数据设计方法,强调高质量数据对模型性能的决定性作用,并提供数据清洗与优化的通用建议。

详细记录了 LangChain-Chatchat 的本地化部署过程,涵盖硬件软件环境要求、代码拉取与依赖安装、模型下载配置、常见问题排查及量化加速方案。重点解决了国内网络环境下的模型下载、WSL 兼容性、CUDA 版本冲突等问题,并介绍了项目结构与处理流程,为构建离线中文知识库问答系统提供参考。

使用 Stable Diffusion 制作 AI 赛博机车图的完整流程。内容涵盖模型选择策略、提示词编写技巧、基础参数设置、ControlNet 结构控制、高清修复处理及视频合成方法。教程旨在帮助用户快速上手,通过调整 Comix 等模型及 DPM++ 采样器,结合线稿控制实现高质量的机械风格图像生成,并提供常见问题的解决方案。
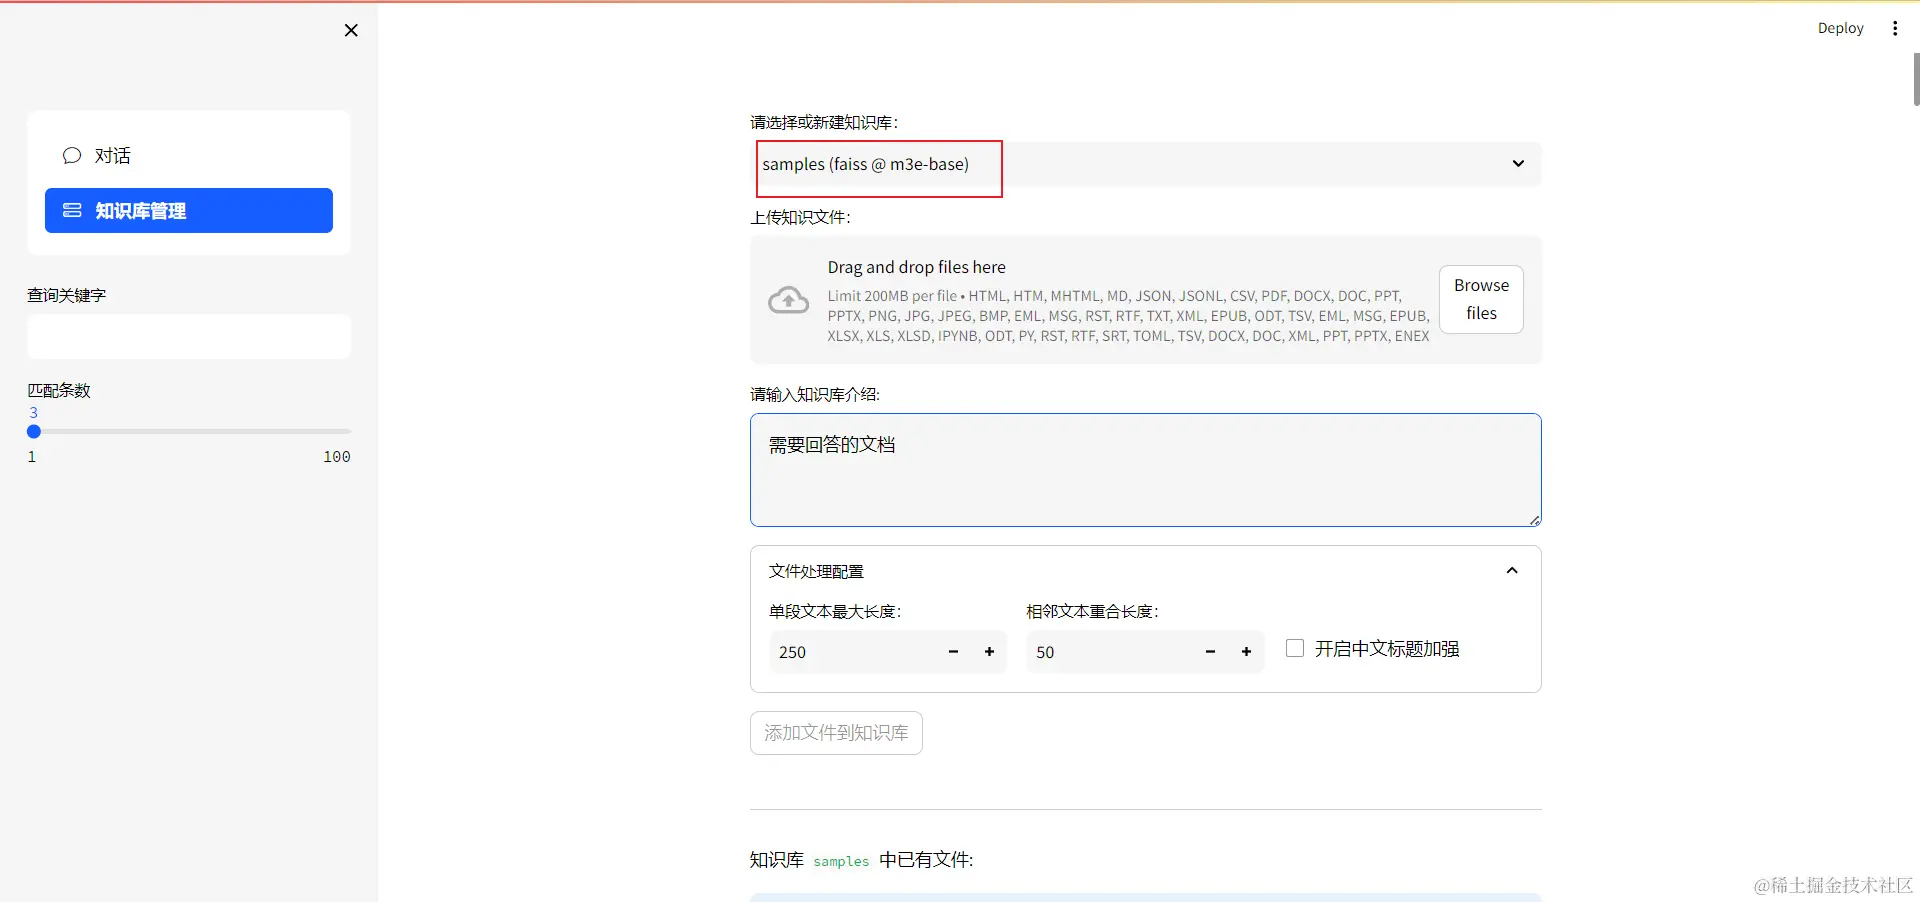
本地知识库大模型的部署与使用方法,涵盖环境准备、服务启动、知识库构建与管理、对话参数调优及性能优化。详细说明了文件上传规范、分块策略配置、向量化处理流程以及常见问题排查方案,旨在帮助用户在本地环境下搭建安全、可控的 RAG 系统。
Ollama 是一款用于构建大语言模型应用的工具,提供 CLI 和服务器接口管理开源 LLM。详细说明了在 Windows 和 Linux 环境下安装 Ollama 的步骤,涵盖 Docker CPU 与 GPU 版本的部署方式。通过下载 Codeqwen 和 Qwen2 模型,配合 VS Code 的 Continue 插件配置,实现了本地代码自动补全与…

梳理了 Python 在基础语法、数据库操作、网络爬虫、数据分析及 Web 开发等核心方向的技术栈与学习路径。重点介绍了各阶段所需的关键库与框架,如 Pandas、Scrapy、Django 等,旨在帮助学习者构建完整的知识体系,避免盲目学习。通过明确不同职业方向的能力要求,为初学者提供清晰的进阶规划。

介绍使用 Python 和 Selenium 库实现网页商品自动抢购的技术方案。通过模拟浏览器操作,结合系统时间比对策略,在指定时刻自动执行登录、加购及结算流程。内容涵盖环境搭建、核心逻辑分析、代码实现细节以及相关的风险控制与伦理说明,旨在提供一份完整的自动化测试与脚本开发参考指南。

探讨了 Python 在金融科技领域的应用价值及学习路径。通过分析 Python 开源、强大、简洁的特性,阐述了其在金融数据分析、风险管理和量化交易中的核心作用。文章结合从业经验,分享了从入门到精通的学习三部曲,并介绍了 Pandas、NumPy 等关键库的使用场景及代码示例。旨在帮助金融从业者掌握编程技能,提升决策效率,实现职业转型与发展。