
PythonAI算法
Phi-3-Vision-128K-Instruct 开源镜像:国产昇腾/寒武纪平台适配指南
介绍 Phi-3-Vision-128K-Instruct 多模态模型在国产昇腾和寒武纪平台的部署指南。内容包括环境硬件要求、服务启动验证、Chainlit 前端及 REST API 调用方法,并提供图片识别与多轮对话示例。此外涵盖服务启动失败及响应慢等常见问题的解决方案,适用于智能客服、内容审核等场景。
介绍 Phi-3-Vision-128K-Instruct 多模态模型在国产昇腾和寒武纪平台的部署指南。内容包括环境硬件要求、服务启动验证、Chainlit 前端及 REST API 调用方法,并提供图片识别与多轮对话示例。此外涵盖服务启动失败及响应慢等常见问题的解决方案,适用于智能客服、内容审核等场景。
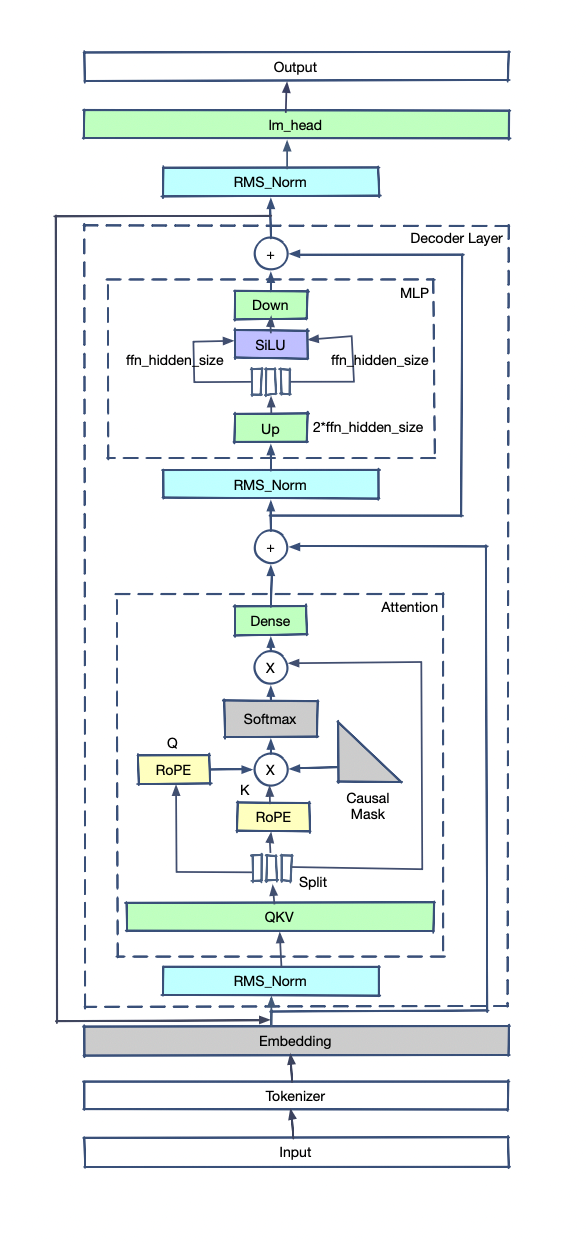
综述由AI生成LLM 大模型训练的基础概念,涵盖预训练、微调和人类对齐三种范式及其适用场景。内容详述了 PyTorch 框架下的张量操作、自动求导及模型构建流程,并深入解析了 Transformer 架构原理。文章对比了 Transformer 与 CNN、LSTM 的差异,重点讲解了 LLaMA2 和 ChatGLM2 模型的关键组件改进,包括 RMSNorm 归一化、RoPE 位置编码、SwiGLU 激活函数以及 GQA 注意力机制,为理解大模型…

综述由AI生成检索增强生成(RAG)通过整合外部知识库提升大模型性能,而 Graph RAG 引入图结构数据以捕捉实体间复杂关系。对比了两者在知识表示、检索机制及推理能力上的差异。标准 RAG 依赖向量相似度搜索平面文档,适合简单查询;Graph RAG 利用图遍历进行多跳推理,能处理复杂上下文和深层关联。Graph RAG 在需要深度理解和关系分析的任务中优势明显,随着图谱技术发展,其在高级 AI 应用中的价值将进一步提升。文章还分析了各自的适用场…
综述由AI生成阐述了无模型自适应控制(MFAC)的核心原理,利用动态线性化技术及伪偏导数构建虚拟数据模型,无需精确数学模型即可设计控制器。详细分析了步长因子、权重因子等参数对算法收敛性的影响,并通过 MATLAB 仿真对比了 MFAC 与增量式 PID 在非线性系统正弦轨迹跟踪中的性能。结果表明,MFAC 在参数设置上较 PID 更为简便,能有效实现稳定控制。

综述由AI生成评测了文心一言 4.5 在图像识别、逻辑推理及通识问答方面的能力,并与 Claude、DeepSeek、Qwen3 等模型进行对比,结果显示其在中文处理上表现优异。文章详细提供了基于 FastDeploy 和 PaddlePaddle 的本地部署方案,涵盖 Linux 环境配置、CUDA 安装及 Windows 下的 WSL/Docker 部署步骤,适合希望私有化部署大模型的开发者参考。

综述由AI生成Python 是一种广泛使用的解释型编程语言,适用于 Web 开发、数据分析及人工智能等领域。本指南详细说明了在 Windows 系统下安装 Python 环境的具体步骤,包括从官网下载、配置环境变量及验证安装。同时涵盖了 PyCharm 集成开发环境的下载、社区版与专业版的区别选择、安装配置以及创建第一个 Hello World 项目的完整流程。文中还补充了常见安装问题的排查方法,帮助初学者快速搭建本地开发环境。
Epoll 提供水平触发(LT)和边缘触发(ET)两种模式。LT 类似 select/poll,只要 FD 就绪就持续通知,容错性好但可能产生冗余;ET 仅在状态变化时通知一次,需配合非阻塞 IO 全量读写,系统调用少、性能更高。面试中常考察两者的机制差异及适用场景。
针对 Ollama 拉取模型速度慢的问题,通过配置国内 HuggingFace 镜像源(如 ModelScope)可显著提升下载效率。结合 LLama-Factory 工具,利用 QLoRA 技术可在消费级显卡上高效完成大模型微调。方案涵盖环境配置、数据准备、可视化训练及部署流程,降低本地化大模型应用门槛,实现低成本私有化部署。

Google Scholar 常因频繁请求或自动化工具触发反爬机制,导致访问受限。解决方法包括更换网络 IP、清除浏览器缓存 Cookies、禁用 QUIC 协议、使用无痕模式及避免脚本工具。若无效可联系支持。建议控制搜索频率并分散使用不同搜索引擎以防再次被封禁。

综述由AI生成系统讲解了人工智能与大模型的发展脉络,涵盖 Transformer 架构、分布式训练策略、有监督微调(SFT)、强化学习(RLHF)及模型评估等核心技术。通过理论结合实践,帮助读者掌握大语言模型的构建与应用流程,适合希望深入理解 AI 底层逻辑的开发者。文章详细介绍了从数据准备、预训练、微调到部署的全链路知识,并提供了具体的技术栈和实践建议。

工业大模型在提升生产效率方面潜力巨大,但落地面临多重挑战。主要包括高质量数据供给不足及治理滞后、模型复杂性与可解释性难以平衡、训练与推理算力成本高昂、行业专业知识语料短缺、应用场景适配性差以及技术与商业壁垒高等问题。解决这些难题需要完善数据治理机制、优化模型架构、降低算力依赖、加强行业知识注入并推动产业协作。未来将朝着定制化、边缘计算及生态协同方向发展。

综述由AI生成ComfyUI Web Viewer 插件解决了图像生成过程中缺乏实时反馈的问题,支持浏览器端即时预览工作流结果。相比传统等待模式,它能显著提升创作效率与团队协作体验,支持跨设备访问及教学展示。安装可通过 Manager 一键完成或手动部署至 custom_nodes 目录。核心节点包括初始化器、输出节点及分享链接生成器,配置服务器地址、端口及安全密码即可启用。该工具适用于本地开发、远程协作及教学场景,是优化 ComfyUI 工作流的重…
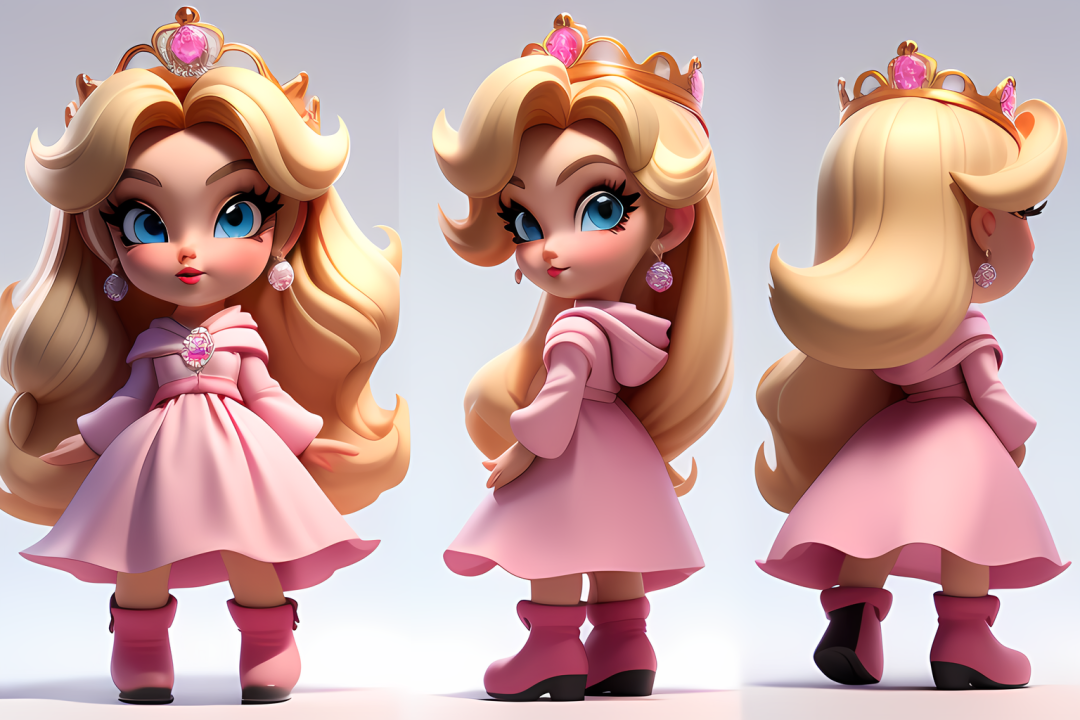
综述由AI生成Stable Diffusion 生成人物三视图的三种核心方法。第一种为纯提示词法,通过调整权重和关键词引导模型,适合快速尝试但可控性较低。第二种为引入专用三视图 LoRA 模型,显著提升生成稳定性和风格统一性,适合批量生产。第三种为使用 ControlNet OpenPose 插件,通过骨架图精确控制人物姿态,可实现任意视角组合且稳定性最高,适合专业设计需求。文章还提供了详细的参数配置、优缺点对比表及常见问题解决方案,帮助用户根据实际…
综述由AI生成如何在 Android 设备上利用 Whisper 和 TensorFlow Lite 实现离线语音识别。文章分析了离线识别的优势,包括解决网络依赖、保护隐私及提升响应速度。提供了从克隆项目、选择 Java 或 Native 技术路线、导入 Android Studio 到实际使用的完整步骤。此外,还涵盖了录音质量优化、转录效果提升技巧、多场景应用(学习、工作、生活)、模型定制化及常见问题解答,旨在帮助开发者构建高效的本地语音转文字应用…

综述由AI生成数组区间求和如果每次都遍历,数据量大时会很慢。前缀和先预处理出 dp[i] 表示前 i 项和,之后任意区间 [l, r] 都能用 dp[r] - dp[l-1] 在 O(1) 时间得到。实现时要把数组开成 n+1 并设 dp[0]=0,避免 l=1 的边界问题;同时前缀和需要用 long,防止累加溢出。

综述由AI生成回顾了 Boston Dynamics 自 1992 年成立以来的发展历程,重点分析了以 BigDog 为代表的第一代液压驱动四足机器人的设计哲学、机械结构、传感与控制架构。文章探讨了其在动态鲁棒性方面的工程突破,以及液压系统带来的能耗、噪声与维护成本等商业化局限。同时总结了从实验验证到电驱动转型的技术演进路径,强调了底层控制与感知智能协同对机器人产品化的重要性。
DeepSeek 系列语言模型涵盖 V1 至 R1 等多个版本,逐步增强编码、推理及多模态能力。V1 侧重基础 NLP 与编码;V2 提升性能并开源;V2.5 融合 Chat 与 Coder 模型,增强数学与联网搜索;R1-Lite 预览版对标 o1,强化推理过程;V3 采用 MoE 架构,提升推理速度;R1 正式版基于强化学习,支持蒸馏。各版本在参数规模、训练成本及应用场景上各有优劣,用户可根据需求选择。

一款结合 DeepSeek 与本地 Ollama 部署的代码审计及 WebShell 检测工具。该工具支持流量分析、JS 代码审计、进程分析及多语言代码审计功能。通过本地模型运行,有效降低 Token 成本并提升处理速度。配置简单,支持切换 API 类型,适合安全工程师进行自动化辅助工作。使用建议优先选择本地大模型如 Qwen2.5 系列以获得更佳效果,但需注意 AI 输出结果仍需人工复核。

综述由AI生成C++ STL 中 Vector 容器的常用接口、底层结构及实现细节。重点分析了 Vector 在扩容时的内存管理问题,指出 memcpy 浅拷贝对自定义类型可能导致析构异常或资源泄漏,建议使用深拷贝。同时详细阐述了 Vector 迭代器失效的场景,包括 insert、erase 等操作引起的底层空间变化,解释了野指针产生的原因,并提供了通过更新迭代器位置来避免失效的正确实践方法。

综述由AI生成Python 副业实战主要通过爬虫技术实现。文章介绍了爬虫的基本原理与步骤,包括页面抓取、分析及存储。针对大型站点的反爬虫措施,如 IP 封锁、数据加密、验证码等,提供了应对思路。列举了多个接单渠道,涵盖专业外包平台、社群、电商及自媒体等方向,并强调了防骗意识与报价策略。内容旨在帮助技术人员利用 Python 技能拓展收入来源,同时提醒注意时间管理与主业平衡。