
JavaAIjava算法
Spring AI 框架入门与实战指南
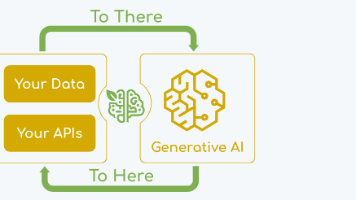
综述由AI生成Spring AI 是 Spring 生态推出的 AI 工程化框架,旨在简化大模型应用开发。其核心功能,包括聊天模型、函数调用、图像及语音生成,并演示了如何集成 DeepSeek、Ollama 和阿里云通义千问。内容涵盖从环境搭建到 RAG(检索增强生成)的完整实战流程,帮助开发者快速构建智能应用。
综述由AI生成Spring AI 是 Spring 生态推出的 AI 工程化框架,旨在简化大模型应用开发。其核心功能,包括聊天模型、函数调用、图像及语音生成,并演示了如何集成 DeepSeek、Ollama 和阿里云通义千问。内容涵盖从环境搭建到 RAG(检索增强生成)的完整实战流程,帮助开发者快速构建智能应用。
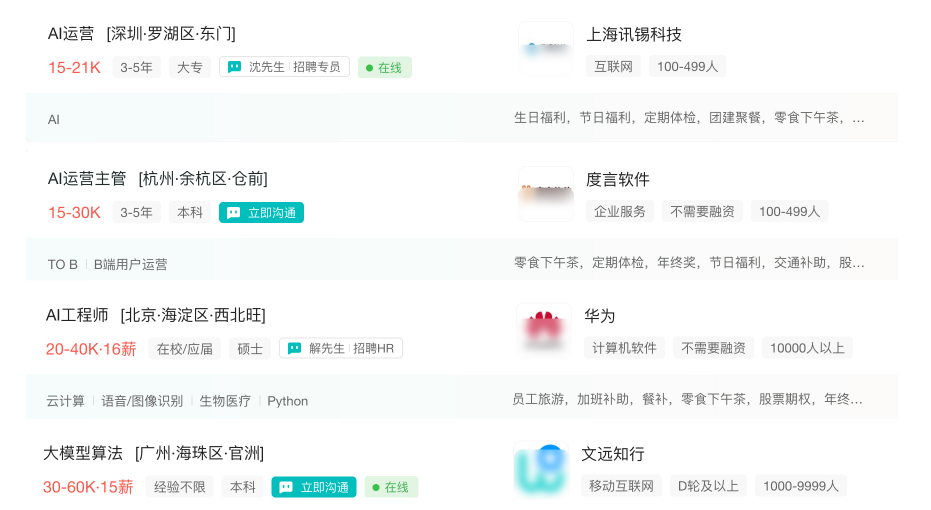
综述由AI生成详细解析了 2024 年大模型 LLM 的学习路径与技术生态。首先介绍了大模型在 NLP、CV、科学计算及多模态领域的分类与特点,分析了当前市场对 AI 工程师及算法人才的薪资需求。接着梳理了核心开发技术栈,涵盖 Python、PyTorch、LangChain 及向量数据库等关键组件。文章针对不同基础人群提供了定制化的学习方案,从零基础入门到资深研发人员的微调与部署优化均有涉及。最后探讨了智能客服、代码辅助、内容创作等典型应用场景,并…
2026 年 AI 论文写作工具覆盖全流程生成、文献处理、降重润色及格式排版四大场景。主流工具如 PaperRed、毕业之家支持一站式服务,锐智 AI、云笔 AI 适合极速出稿,DeepSeek 学术版则针对理工科公式代码需求。实操中建议组合使用各工具优势,从选题大纲到终稿检查分步推进。需注意 AI 仅作为辅助,核心论证与数据须由作者独立完成,确保参考文献真实可溯源并控制 AI 内容占比以符合学术规范。
综述由AI生成OpenClaw 通过网关、节点、渠道三层架构实现 AI 自主执行。其采用文件即状态存储与混合记忆系统,支持多模型兼容及本地优先部署。核心能力涵盖系统级操作、多渠道交互及插件扩展,适用于办公自动化与企业流程重构。当前面临安全合规挑战,但代表了 AI 从对话向执行转型的趋势。
综述由AI生成探讨了基于 ASR 的语音切分与说话人区分技术。分析了连续语音流处理中静音段判断、说话人重叠及噪声干扰等痛点。对比了 WebRTC VAD 与端到端 ASR 模型的延迟、准确率及资源占用差异,提出了针对不同场景的选型建议。核心部分介绍了基于 x-vector 的说话人嵌入提取方法,以及带缓冲的音频切分实现逻辑。在生产环境部署方面,涵盖了环形缓冲区设计、内存泄漏检测、采样率一致性处理及线程优先级配置等关键考量。最后延伸至说话人自适应技术,…
综述由AI生成记录了在 ZYNQ 平台上将 HLS 生成的 IP 核集成至 Vivado 并部署 LeNet 神经网络的完整流程。涵盖 IP 核导出、Block Design 连接、Vitis 工程配置及 FATFS 文件系统挂载。重点分享了 PS 端配置、BRAM 数据交互及调试经验,包括解决输出异常值的排查思路。
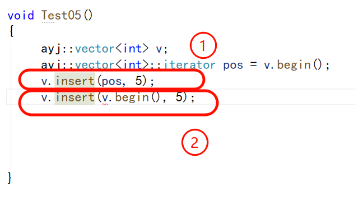
综述由AI生成详细讲解了 C++ STL 中 vector 容器的底层模拟实现。内容涵盖 vector 的内存结构定义(_start/_finish/_endofstorage),默认成员函数(构造函数、拷贝构造、赋值重载、析构函数)的实现细节,以及迭代器的管理。重点阐述了容量相关接口(size/capacity/reserve/resize)的逻辑,并深入分析了增删查改操作(push_back/insert/erase/pop_back)中的内存管…
综述由AI生成从零实现 STL vector 类模板,涵盖动态内存管理、迭代器机制及拷贝控制等核心知识点。文章详细拆解了构造函数、赋值运算符重载、空间扩容策略及插入删除操作,通过对比标准库实现加深理解,适合希望深入掌握 C++ 底层原理的开发者。
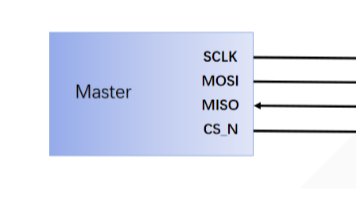
综述由AI生成SPI 通信协议通过 SCLK、MOSI、MISO、CS_N 四线实现主从设备数据传输。介绍基于 FPGA 设计 SPI 控制器读写 M25P16 Flash 存储器的方案。内容包括 SPI 协议时序分析、M25P16 芯片特性及指令集、状态机设计思路以及上板验证结果。通过按键触发读 ID、读数据、扇区擦除及页编程操作,并利用数码管与串口显示交互信息,实现了稳定的 Flash 读写功能。
综述由AI生成梳理了傅里叶分析的核心概念体系,涵盖傅里叶级数 (FS)、傅里叶变换 (FT)、离散时间傅里叶变换 (DTFT)、离散傅里叶级数 (DFS) 及离散傅里叶变换 (DFT)。重点阐述了时域与频域的连续性、周期性关系,以及采样和截断操作如何导致不同变换形式的产生,总结了四种信号类型对应的频谱特征。
综述由AI生成环形链表检测是链表操作中的经典问题。对比哈希表法和快慢指针法两种解决方案,前者直观但占用 O(n) 空间,后者利用双指针原理仅需 O(1) 额外空间。重点讨论了边界条件处理及代码健壮性优化,帮助开发者在时间与空间复杂度间做出合理权衡。
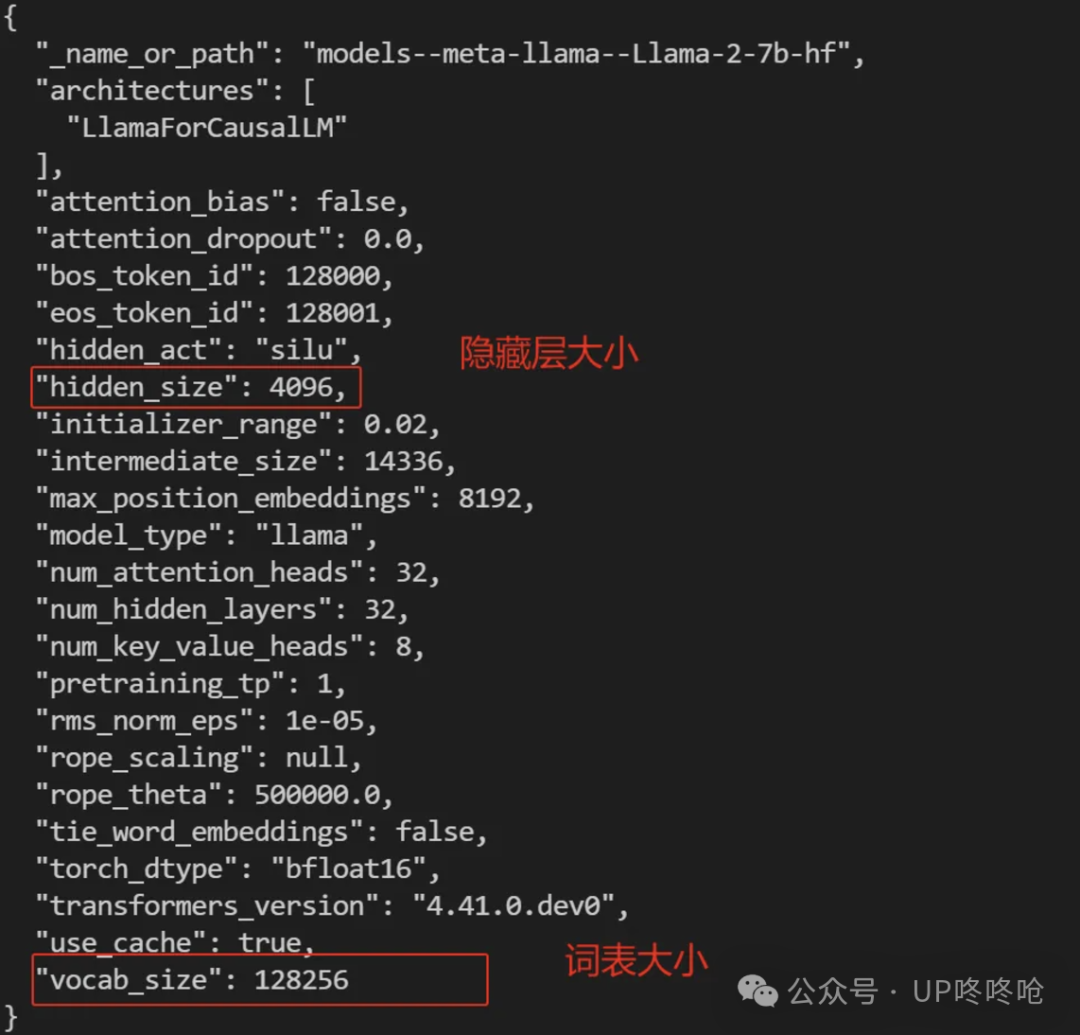
综述由AI生成从计算视角深入解析大型语言模型(LLM)的内部结构,涵盖张量形状(Tensor Shape)、Embedding 层、多头注意力机制(MHA)及前馈神经网络(MLP)的输入输出数据结构与计算量分析。详细阐述了各算子的矩阵运算逻辑、维度变换过程及浮点运算次数估算,帮助读者建立对 LLM 推理过程中数据流转与计算负载的直观理解。文中还补充了 PyTorch 代码示例以辅助理解实际计算流程。
综述由AI生成演示了使用 LLaMA-Factory 框架对 Qwen3.5-4B 模型进行 LoRA 微调,构建专业医疗问答助手的完整流程。涵盖硬件选型、环境搭建、数据集准备、训练配置及模型部署等关键步骤。通过对比不同量化方案显存需求,提供 RTX 4070 至 3060 的显卡适配建议。包含具体命令行操作、YAML 配置文件解析及常见问题排查指南,助力开发者快速落地垂直领域大模型应用。注意医疗场景下的合规性与免责声明。
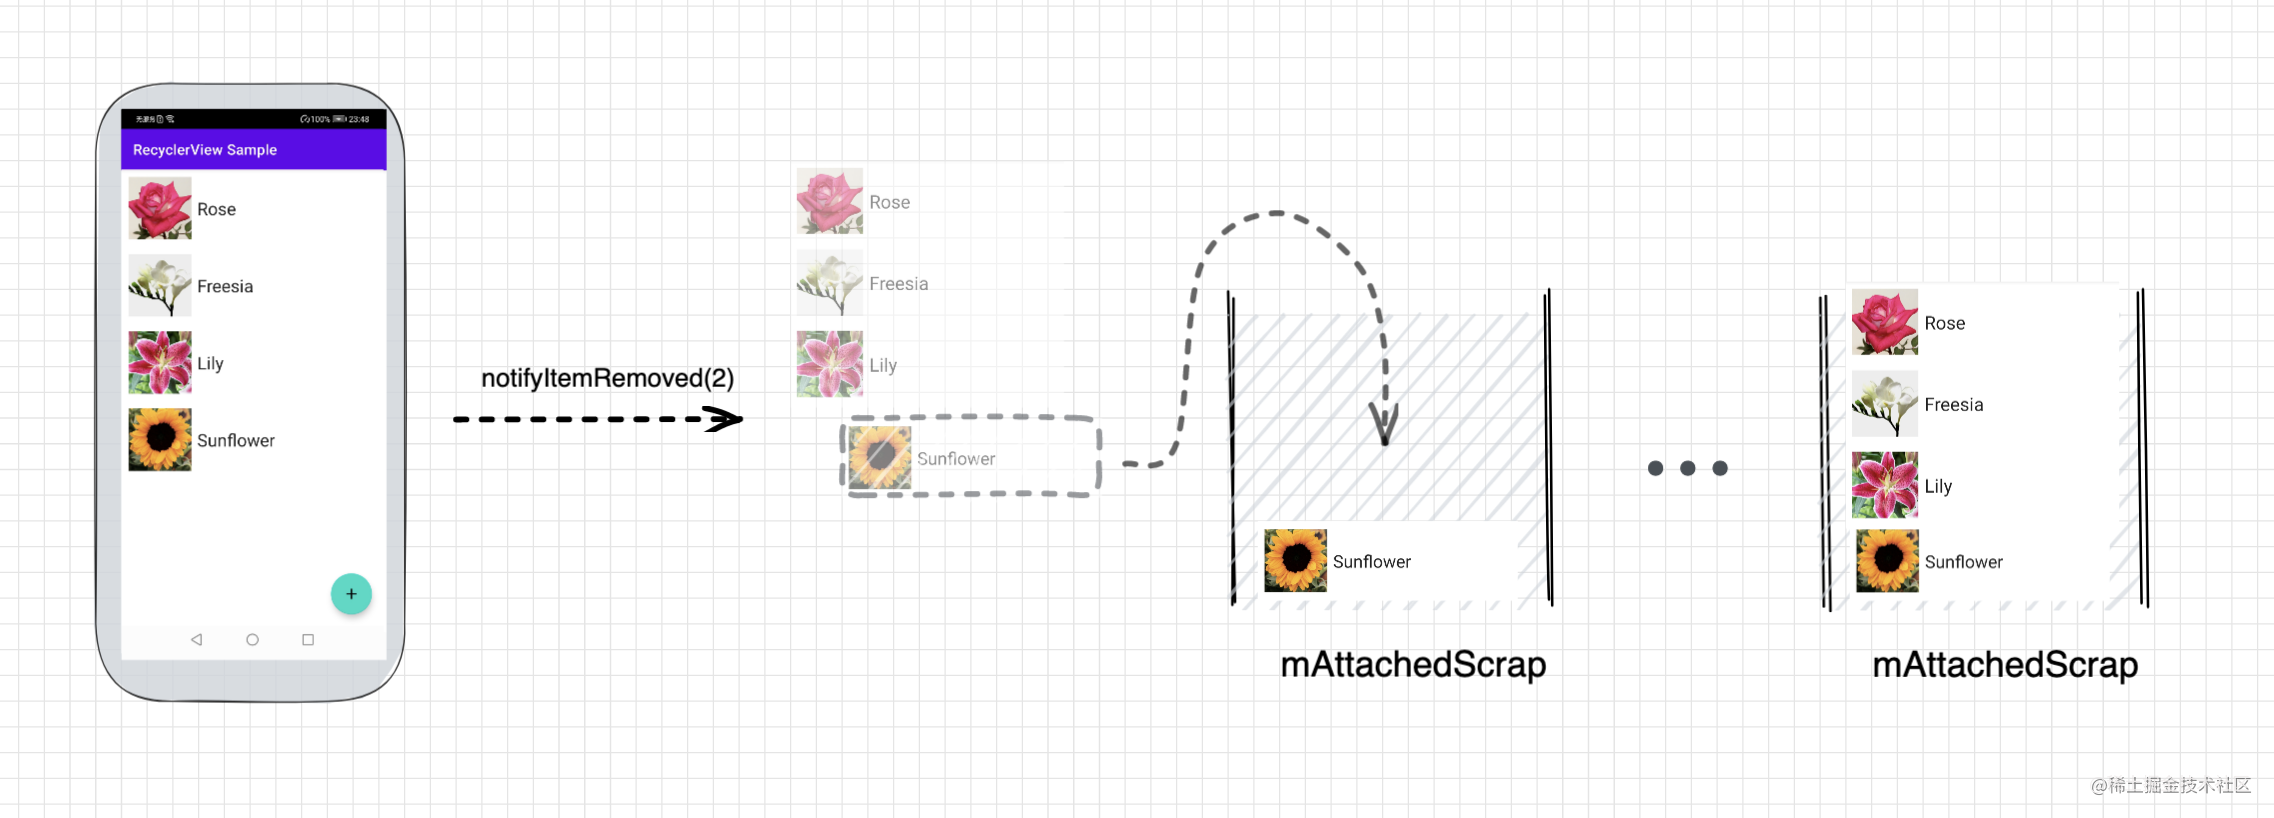
综述由AI生成RecyclerView 通过缓存复用机制优化列表性能,避免重复创建视图和查找控件。核心涉及 ViewHolder、Adapter 及 Recycler 类。缓存层级包括 mChangedScrap/mAttachedScrap(屏幕内重用)、mCachedViews(近屏缓存)、mRecycledViewPool(远屏池化)。Recycler 按优先级依次查找这些缓存,命中则复用,未命中则创建新对象并绑定数据。合理配置可提升滑动流畅度…
综述由AI生成对比了 C++ 中 memcpy 与赋值拷贝的区别。memcpy 是内存层面的二进制逐字节拷贝,适用于平凡可拷贝类型,但存在安全风险;赋值拷贝是语法层面的逻辑拷贝,支持内置及自定义类型,更安全。建议优先使用赋值拷贝,仅在特定性能场景下使用 memcpy,避免在非平凡可拷贝类型上使用导致崩溃。
在免费 Google Colab 环境下利用 llama.cpp 加载 LLaMA-13B 模型,结合 LangChain 实现聊天、路由、记忆及 Python 代理功能。通过量化优化资源,展示开源大模型本地推理可行性。
综述由AI生成系统介绍了大语言模型(LLM)的构建与优化指南,涵盖 Transformer 架构原理、BERT 与 GPT 系列模型详解、数据预处理、微调策略及下游任务应用。内容涉及机器翻译、文本摘要、情感分析、问答系统及可解释性 AI 等多个领域,并结合 ChatGPT 和 GPT-4 的最新进展,提供从理论到实践的全面技术解析,适合希望深入理解 NLP 与大模型技术的开发者阅读。

提示词工程师是 AI 大模型时代催生的新兴职业,主要负责设计和优化 AI 提示词以提升模型响应质量。该岗位在互联网、医疗、金融等行业需求旺盛,薪资水平较高。从业者需具备跨学科知识,包括计算机科学、语言学及特定领域经验。核心技能涵盖零样本/少样本提示、思维链技术及 API 调用。适合人群包括科研人员、产品经理、NLP 专家及程序员。学习路径应从基础认知入手,通过实践操作和进阶优化逐步掌握,最终实现高效的人机协作。
PyMAVLink 是基于 Python 的 MAVLink 协议实现库,支持 v1/v2 版本及 UDP/TCP/串口通信。文章涵盖安装部署、基础连接建立、实时数据监控及核心功能解析。包含多协议通信支持、智能代码生成引擎及数据分析工具集。实战部分展示飞行数据处理、通信性能优化及地理信息可视化方法。提供高级开发技巧如自定义协议扩展、多设备协同管理及错误处理机制。环境配置推荐 Python 3.7+,强调依赖管理与性能调试。旨在帮助开发者…

综述由AI生成FunASR 是阿里巴巴达摩院开源的语音识别工具包,支持 ASR、VAD、标点恢复等功能。介绍其核心功能、安装方法及非实时/实时识别、VAD、标点恢复、时间戳预测和情感识别的运行示例,帮助用户快速部署语音识别服务。文章还补充了部署建议与最佳实践,涵盖硬件资源、模型选择、缓存机制及热词增强等关键要点。