
编程语言算法
华为 OD 机试:流水线调度问题
华为 OD 机试中的流水线调度问题。题目要求在 m 条流水线上并行完成 n 个独立作业,调度策略为优先处理处理时间最短的作业。当作业数大于流水线数时,初始将最短的 m 个作业分配给流水线,后续作业在流水线空闲时按时间最短原则依次补充。输入包括流水线数量、作业数量及各作业时长,输出为完成所有作业的总耗时。
华为 OD 机试中的流水线调度问题。题目要求在 m 条流水线上并行完成 n 个独立作业,调度策略为优先处理处理时间最短的作业。当作业数大于流水线数时,初始将最短的 m 个作业分配给流水线,后续作业在流水线空闲时按时间最短原则依次补充。输入包括流水线数量、作业数量及各作业时长,输出为完成所有作业的总耗时。
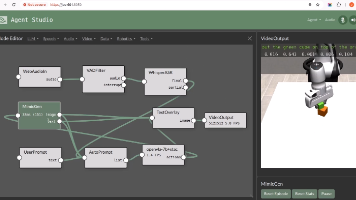
综述由AI生成OpenVLA 模型微调与机器人部署实战涉及量化优化、合成数据生成及多硬件环境测试。通过在 Jetson AGX Orin 上应用 INT4/FP8 量化,显著降低了推理延迟,同时保持较高精度。利用 MimicGen 进行领域随机化数据增强,解决了真实场景数据稀缺问题。实验表明,增加训练回合数比单纯增加 Epoch 更能提升模型成功率,但在复杂任务中需警惕过拟合。最终在积木堆叠任务中达到 85% 准确率,为 VLA 模型在边缘设备上的落…
AI 大模型如 Sora 的发布对多个行业产生深远影响,同时也带来就业结构变化。普通人应深耕垂直领域,提升深度思考能力以构建竞争力护城河。算力付费将成为常态,单人独角兽模式可能兴起。投资建议上,全球股市中 AI 上游硬科技公司表现确定,推荐关注费城半导体 ETF。个人发展方面,掌握大模型技术至关重要,相关岗位薪资持续走高,建议系统学习以提升职业竞争力。
AIGC 插画生成基于扩散模型原理,通过文本提示词引导图像合成。本文结合 Stable Diffusion 与 Diffusers 库,演示从零搭建环境、加载模型、构建提示词及参数调优的全流程。涵盖正向扩散与逆向去噪机制,提供游戏角色设计与海报生成的实战代码示例。重点解析 num_inference_steps、guidance_scale 等关键参数对效果的影响,并探讨版权伦理与计算资源优化方案。适合希望掌握 AI 绘画底层逻辑与工程…
OpenCode 是一款开源 AI 编程智能体,由 anomaly 团队开发,采用 MIT 协议。支持 75+AI 提供商,涵盖终端、IDE 插件及桌面版模式。具备 Plan 和 Build 双代理模式,深度集成 LSP,强调隐私保护与本地模型支持。相比闭源商业产品,其优势在于代码透明、无供应商锁定及高度可定制性。适用于个人开发者、企业团队及技术爱好者进行代码重构、Bug 修复及原型开发。
通过四个经典算法题讲解 C++ string 类的常用操作。包括使用 getline 读取整行输入,利用 rfind 查找最后一个空格获取单词长度;通过双指针法验证回文串并过滤非字母数字字符;使用数组统计字符频率找出第一个唯一字符;以及利用 swap 函数反转字符串。内容涵盖输入处理、字符串遍历、索引计算及标准库函数应用。
综述由AI生成AIGC 即人工智能生成内容,利用深度学习模型自动生成文本、图像、音频及视频。阐述了 AIGC 的技术原理,包括 GAN、Transformer 及扩散模型。回顾了从早期实验到当前爆发式增长的发展历程。详细分析了在文本、图像、代码生成等领域的应用现状,对比了 B 端与 C 端市场差异。针对隐私泄露、版权争议等伦理问题提出监管建议。通过 Python 代码示例展示 AIGC 辅助开发能力,并展望了未来跨领域协同创新的方向。
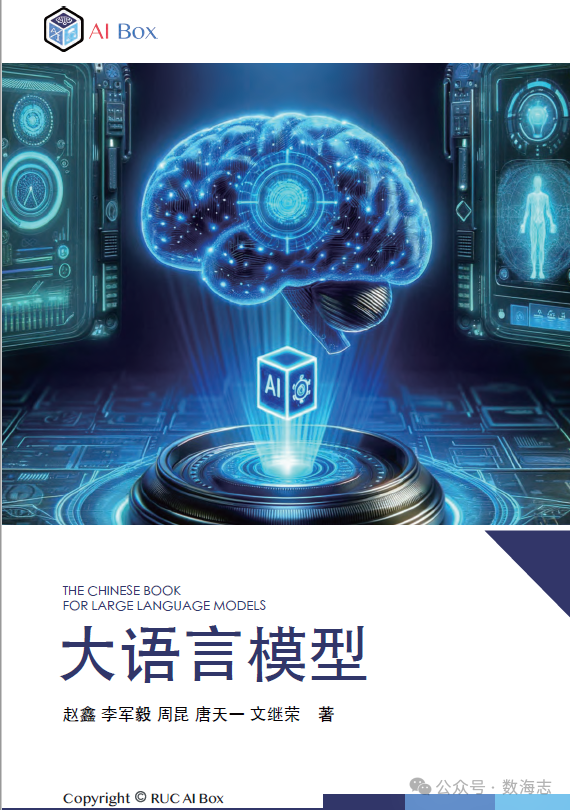
综述由AI生成基于中国人民大学高瓴人工智能学院发布的《大语言模型综述》,系统梳理了大语言模型的技术体系。内容涵盖背景基础、预训练技术、微调与对齐、推理部署及评测应用五大板块。文章详细解析了 Transformer 架构、指令微调、RLHF 与 DPO 对齐方法、提示工程及主流评测基准,旨在为研究者和工程师提供全面的技术指南与知识框架。
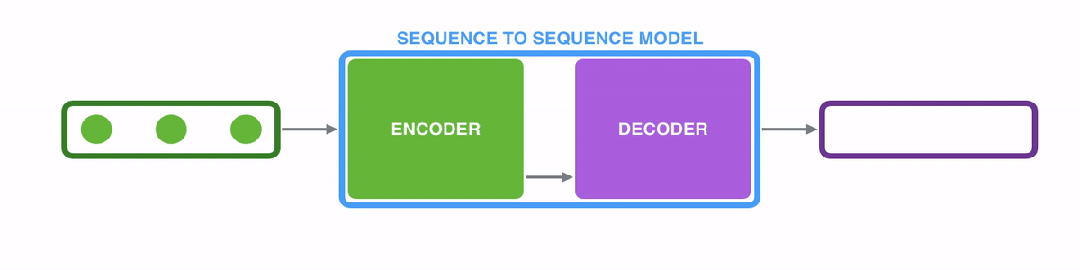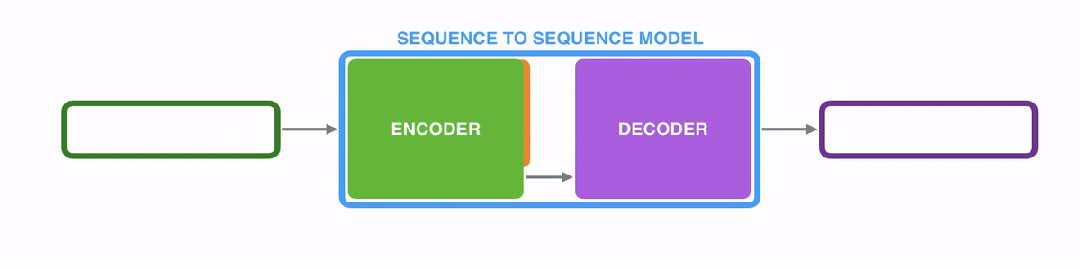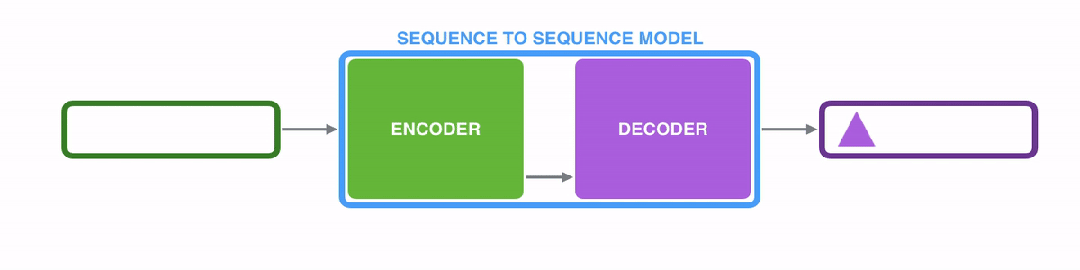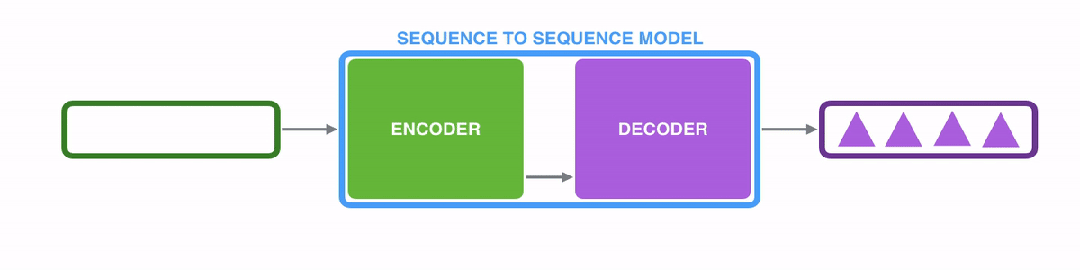
综述由AI生成深入探讨大语言模型(LLM)为何普遍采用 Decoder-Only 架构。通过对比 Encoder-Only、Encoder-Decoder 及 Decoder-Only 三种结构,分析其在预训练目标、泛化能力、训练成本及推理效率上的差异。研究表明,纯因果解码器在自监督预训练下具备更强的零样本泛化能力,且 KV Cache 机制显著提升了推理效率。尽管双向注意力有助于理解任务,但生成任务更依赖自回归特性。随着模型规模扩大,涌现能力缩小了…
四道经典的动态规划题目:按摩师、打家劫舍 II、删除并获得点数、粉刷房子。通过定义状态 f[i](选)和 g[i](不选),推导状态转移方程,解决线性及环形数组的最优选择问题。代码采用 Java 实现,包含预处理逻辑及边界条件处理,适合算法初学者理解多状态 DP 模型。
综述由AI生成教育元宇宙中 VR 协作工具的交互延迟测试。首先定义了端到端、网络及渲染延迟及其对教学体验的影响。其次介绍了分层测试方法,涵盖 Unity Profiler、Wireshark 等工具及 Motion-to-Photon 等关键指标。提供了单用户基准、多用户压力及边界条件测试场景设计。针对设备异构与实时性验证挑战提出优化策略,如自适应测试套件与边缘计算。旨在构建零感知延迟的测试体系,提升 VR 教育应用可靠性。
综述由AI生成探讨了现有 AI 助手在算力成本、记忆能力及本地化支持方面的不足,提出了一种基于 Go 语言构建的可自我演进 AI 助手方案。核心架构采用微内核与插件化设计,结合整洁架构风格。通过引入本地量化大模型替代部分云端调用以降低 Token 消耗,并模拟人脑记忆机制解决健忘症。系统包含潜意识层处理日常技能,主意识层负责复杂推理,配合定时任务实现自我总结与模型微调,从而实现数字化分身的自我演进。
综述由AI生成对比了传统爬虫编程与基于 AI 大模型(如通义千问、OpenAI)的爬虫实现方式。通过豆瓣电影数据爬取示例,展示了使用 Cheerio 和 BeautifulSoup 的传统流程,以及利用 Prompt 工程让大模型解析 HTML 并提取结构化数据的方案。文章还分析了 Python 与 JavaScript 在异步处理、类型系统及生态上的差异,探讨了 AI 辅助编程如何提升开发效率及扩展情感分析等智能功能的可能性,并补充了提示词优化、安…
综述由AI生成Llama API 提供托管式 Llama 2 服务,支持函数调用。通过 LlamaIndex 集成该 API,可实现文本补全、对话交互、函数调用及结构化数据提取。示例涵盖环境配置、密钥设置及 Pydantic 模型定义,演示了如何从非结构化文本中提取专辑信息。利用 OpenAI 兼容性接口简化开发,无需本地部署即可快速构建应用,并提供错误处理与性能监控等扩展建议。
AI Agent 推理架构主要包含 ReAct 与 Plan-and-Execute 两种模式。ReAct 交替思考与行动,适合简单任务但缺乏全局视野且上下文成本高;Plan-and-Execute 先规划后执行,具备全局视角、成本可控及可审计优势,但可能过度设计简单任务。建议采用混合架构,以 Plan-and-Execute 管理全局流程,Executor 内部保留 ReAct 能力实现局部灵活执行,兼顾稳定性与适应性。
FedML 是一款端到端生产级联邦学习开源框架,由北卡州立大学和斯坦福大学联合研发。它支持水平、垂直及联邦迁移学习三大范式,内置 100+ 算法,覆盖科研与工业场景。架构分为通信、核心、算法、应用四层,具备跨平台兼容性(终端/服务端)和高并发工程化能力。提供 Python SDK 及可视化监控工具,适用于金融、医疗、物联网等领域,旨在解决数据孤岛与隐私保护问题。
综述由AI生成OpenClaw 是一款自托管、无代码的开源 AI Agent 框架。它通过微内核架构支持多智能体协同,提供本地化部署以保障数据主权。核心组件包括上下文引擎、任务调度器及工具注册中心。相比 LangChain 等框架,OpenClaw 降低了开发门槛,适合个人效率助手、企业知识管理及内容创作流水线等场景。项目采用 MIT 协议,支持 Docker 快速部署,并持续扩展插件生态。
综述由AI生成内容创作模式的核心差异在于创作者身份。UGC 是大众自发分享,PGC 源自专业机构,PUGC 结合了专业背景与用户灵活性。OGC 侧重职业属性,MGC 早期依赖机器规则,BGC 服务于品牌营销。当前 AIGC 利用深度学习技术大幅降低创作门槛,推动人机协同成为主流。理解这些概念有助于把握内容生态的演变趋势与未来机会。
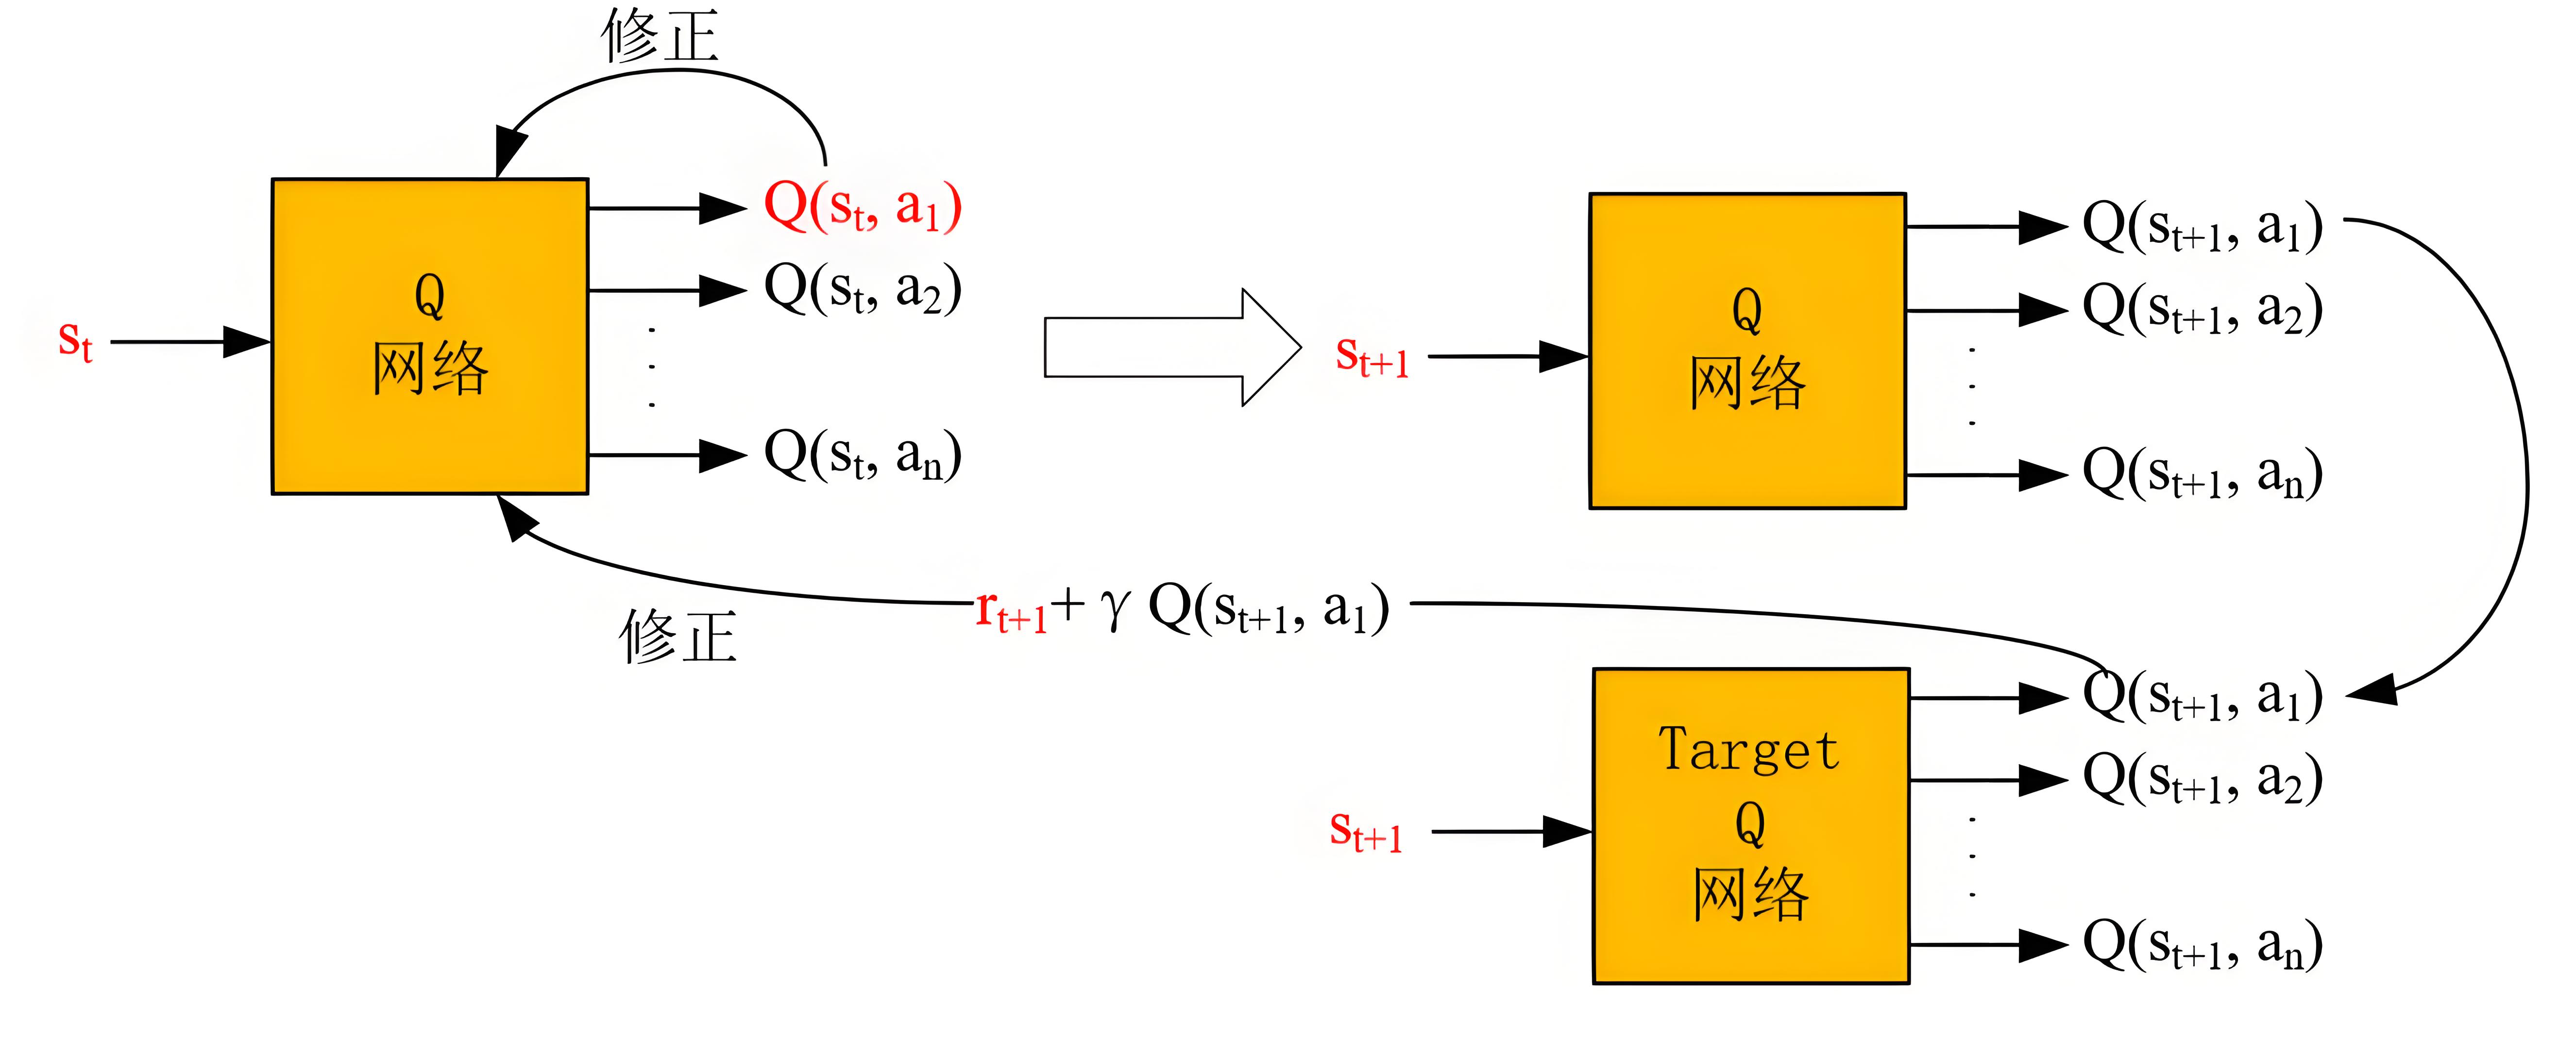
Double DQN 针对 DQN 过估计偏差问题,通过分离动作选择与价值评估网络提升稳定性。解析其核心思想、数学推导及 PyTorch 代码实现,帮助理解双网络机制在强化学习中的应用。

基于 Java SSM 框架的咖啡奶茶点餐推荐系统,采用 B/S 架构,前端结合 HTML5、CSS3 与 Layui/Bootstrap,后端整合 Spring、Spring MVC 及 MyBatis,数据库选用 MySQL。系统核心功能包括用户管理、商品分类、智能推荐、订单处理及数据统计,利用协同过滤算法分析用户偏好生成个性化列表。此外,集成第三方支付接口并支持实时反馈优化模型,旨在提升点餐体验与商家运营效率,适用于餐饮行业数字化…