
SQLjava算法
MySQL 数据类型深度解析:选对类型提升性能
MySQL 数据类型选择直接影响存储空间与查询效率。数值类型需按范围选最小整型,金额必用 DECIMAL 避免浮点误差。字符串类型中 CHAR 适合定长,VARCHAR 适合变长,避免无脑 VARCHAR(255)。日期时间类型注意 TIMESTAMP 时区与范围限制。特殊类型 ENUM 和 SET 可简化单选多选逻辑。遵循宁小勿大、优先原生类型等法则,能有效规避表设计坑点,优化数据库性能。
MySQL 数据类型选择直接影响存储空间与查询效率。数值类型需按范围选最小整型,金额必用 DECIMAL 避免浮点误差。字符串类型中 CHAR 适合定长,VARCHAR 适合变长,避免无脑 VARCHAR(255)。日期时间类型注意 TIMESTAMP 时区与范围限制。特殊类型 ENUM 和 SET 可简化单选多选逻辑。遵循宁小勿大、优先原生类型等法则,能有效规避表设计坑点,优化数据库性能。
综述由AI生成C++ 网络编程实战,涵盖 JSON 序列化与反序列化原理,HTTP 协议报文结构解析,以及基于 Socket 与线程池的 Web 服务器实现。文章详细讲解了 GET 与 POST 请求的处理逻辑,静态资源映射与动态计算功能的具体代码实现,适合希望深入理解网络服务端的开发者参考。
Llama 3-8B-Instruct 在昇腾 NPU 上基于 SGLang 进行性能实测,涵盖环境搭建、模型加载及吞吐量、时延、显存占用测试。结果显示该组合在高并发与长序列场景下具备高吞吐、低延迟优势,适合大模型推理部署。
宇树机器人 SDK2 开发流程涵盖 C++ 与 Python 版本,基于 CycloneDDS 通信。需 Ubuntu 20.04 环境,配置静态 IP 连接机器人(192.168.123.161)。步骤包括克隆仓库、编译依赖、网络调试及运行关节摆动或音频播放 Demo。常见问题涉及 DDS 库安装、网卡名称匹配及调试模式进入方法。
综述由AI生成基于 Vitis AI 将 PyTorch 模型部署至 FPGA 的完整流程,涵盖环境搭建、ONNX 导出、INT8 量化校准及 DPU 编译。通过 KV260 平台实测,ResNet-50 在 INT8 量化下可达 1200 FPS,功耗约 5W。文章重点解析了 Vitis AI 工具链的使用细节,包括 Docker 镜像配置、模型分割策略及常见报错排查,为边缘计算场景提供高能效推理方案。
综述由AI生成收录了青少年软件编程(Python)等级考试三级的部分真题试卷,包含单选题。内容涵盖二进制与十六进制转换、列表切片操作、二维数组索引、文件读写模式(如CSV写入、追加模式)、十进制转二进制及八进制、以及算法基本概念(输入输出、结构)。每道题均附带标准答案与详细解析,旨在帮助考生复习备考,掌握Python基础语法及计算机基础知识。
Stable Diffusion 启动时报错 CheckpointLoaderSimple 验证失败,提示模型文件不在列表中。问题源于本地模型目录缺少指定的 checkpoint 和 vae 文件。需从 HuggingFace 下载 v1-5-pruned-emaonly-fp16.safetensors 至 models/checkpoints 目录,并下载 vae-ft-mse-840000-ema-pruned.safetenso…
综述由AI生成AI Skills 作为模块化、可组合的 AI 功能单元,正成为构建复杂应用的关键基础设施。文章解析其与传统模型的区别,列举在内容创作、数据分析等场景的应用价值。通过 Python 代码示例,演示了基于 OpenAI API 的技能编排、FastAPI 集成方案以及完整的开发流程,涵盖需求分析、Prompt 工程、测试评估至 Docker 部署。重点强调单一职责、接口标准化与安全成本控制,为开发者提供从理论到落地的系统性参考。
华为 HCIP-AI Solution Architect H13-323 认证考试的题库及解析。内容涵盖 MindSpore 架构、Hugging Face Transformers 与 DeepSpeed 集成、梯度优化理论、BERT 模型原理、Megatron-LM 并行框架、TensorFlow Keras 指标、华为 HiAI 与 ModelArts 服务、大模型推理技术(思维链、Prompt Tuning)、分布式训练(Ze…
综述由AI生成LeetCode 128 要在未排序数组中找最长连续序列,并把时间复杂度控制在 O(n)。做法是先把所有数字放入哈希集合,利用 O(1) 查找判断某个数是否存在,再只把'前一个数不存在'的元素当作起点,从起点向后扩展统计长度。这样每个数最多被处理一次,最终时间复杂度为 O(n),空间复杂度为 O(n)。

综述由AI生成AI 大模型在商业落地中面临机遇与挑战。通过分析 ChatGPT、Stable Diffusion 等主流工具特性,结合 IBM Watson 失败与瑞幸咖啡成功的案例,探讨了 AI 在企业中的实际应用价值。重点介绍了基于 GPT 的 PRD 文档生成与素材库自动化打标实践,并总结了高效 Prompt 编写原则及落地过程中的关键注意事项,旨在帮助技术团队将 AI 有效嵌入工作流,实现效率提升与业务创新。
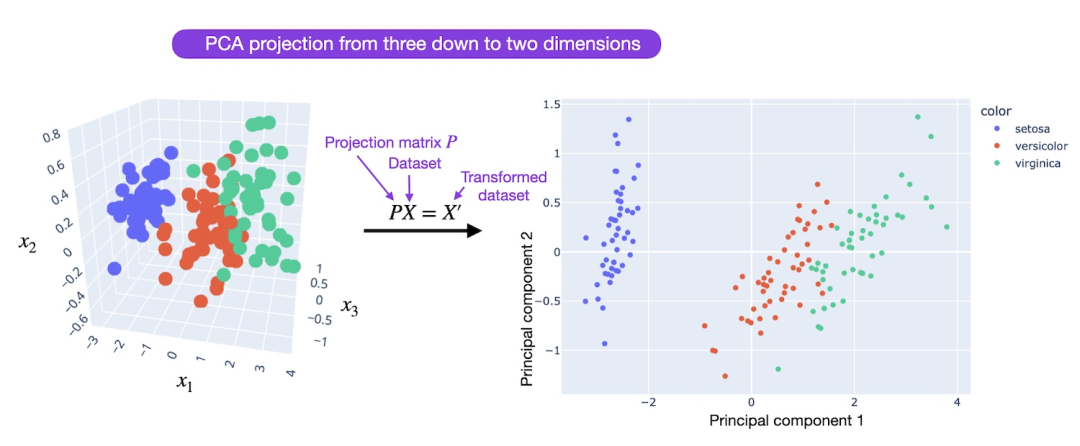
低秩自适应(LoRA)是一种高效的参数微调技术,通过冻结预训练权重并引入可训练的低秩分解矩阵,大幅减少下游任务的可训练参数量。 LoRA 的原理、秩的选择策略及其在 LLaMA 模型上的实战效果。实验表明,LoRA 能在单卡 GPU 上以较低资源消耗实现接近全量微调的性能,且推理时无额外开销,适合资源受限场景下的指令微调。
综述由AI生成人工智能行业的市场趋势与人才需求,指出 AI 专业人才需求预计显著增长。探讨了美国相关政策对留学生移民的影响,详细解析了 ChatGPT、DALL-E 3、Midjourney、Stable Diffusion 及 Leonardo 等主流 AI 工具的技术原理与应用场景。文章还梳理了全球高校对 AI 生成作品集的政策差异,强调了透明度与辅助作用的重要性,并为开发者提供了 Python 技术栈建议及伦理合规指导,旨在帮助读者全面了解 A…
综述由AI生成后量子密码(PQC)的五种主流技术路线:基于格、哈希、编码、多变量及同源算法。详细阐述了各路线的原理、典型算法(如 Kyber、Dilithium、SPHINCS+ 等)、优缺点及标准化进展。指出基于格算法因平衡性成为核心,基于哈希算法安全性强但签名体积大,基于编码算法密文小但公钥大,同源算法尺寸小但效率低且面临安全挑战。未来趋势包括标准体系完善、算法优化融合及应用场景加速渗透,强调 2027 年前支持 PQ-TLS 混合加密,2030…
综述由AI生成详细解析了 C++11 引入的核心新特性,包括初始化列表的统一语法、std::initializer_list 的使用机制、auto 与 decltype 的类型推导功能、nullptr 的安全空指针表示,以及左值与右值引用的区别。重点阐述了右值引用如何通过移动构造优化资源管理,减少不必要的深拷贝开销,并结合万能引用与 std::forward 讲解了完美转发的实现原理,帮助开发者编写更高效、安全的现代 C++ 代码。
综述由AI生成Unitree SDK2 Python 提供了基于 DDS 通信机制的机器人控制接口。配置需满足 Python 3.8 及以上环境,安装依赖包括 CycloneDDS、numpy 和 opencv-python。通过克隆仓库、编译 CycloneDDS 并设置环境变量完成安装。支持 B2、G1、Go2、H1 等机型。功能涵盖高级状态读取、运动控制、低级电机控制、无线控制器状态获取、前摄像头画面及避障开关控制。开发者可参考示例程序进行调试…
综述由AI生成详细阐述了大语言模型(LLM)的基础知识、核心架构及工作原理。内容涵盖 LLM 的定义、不同类型(如 Transformer、BERT)、关键组件(预训练、微调)、训练全流程(数据收集、模型配置、训练评估)以及具体工作机制(分词、嵌入、注意力机制)。文章列举了 LLM 在聊天机器人、代码生成、医疗、教育等领域的广泛应用场景,并探讨了未来在上下文理解、伦理偏见、持续学习及成本优化方面的趋势与挑战。旨在为读者提供一份全面的技术指南,帮助理解…
OpenClaw 框架发布 2026.3.7 版本,新增对 GPT-5.4 支持及记忆系统热插拔功能。引入 Context Engine 插件体系突破上下文窗口限制,优化 Discord 与 Telegram 持久化绑定。工具链重构提升搜索精确度,增强网关认证与安全机制。性能测试显示在长上下文场景下优势明显,社区规模持续增长。
综述由AI生成介绍逆向工程基础及 IDA Pro 工具在 CTF 中的应用。通过静态分析(望闻问切)定位关键字符串和交叉引用,利用 F5 生成伪代码还原程序逻辑。示例展示了如何分析输入校验循环与 ASCII 码变换,最终实现算法还原。
LLaMA-Factory 是一款基于 Python 的低代码大模型微调框架,支持多种主流模型与高效微调算法。它提供 Web UI 和命令行接口,涵盖预训练、指令微调及强化学习等任务。通过集成 LoRA、QLoRA 等技术,显著降低显存消耗并提升训练效率。详细介绍其安装配置、参数设置、训练流程及推理部署方法,帮助用户快速上手大模型定制开发。