LightRAG 本地部署与 WebUI 应用实战
综述由AI生成LightRAG 是一种基于图结构的检索增强生成框架,通过构建知识图谱实现双层检索范式。介绍其核心原理、技术栈选型及本地部署流程。涵盖 LLM 与 Embedding 模型配置、Bun 环境搭建、WebUI 界面操作(文档管理、知识图库、检索)以及 API 使用。对比了传统 RAG 与 GraphRAG 的优劣,重点解析 LightRAG 的增量索引与混合查询机制,适合希望快速落地高效 RAG 系统的开发者参考。
综述由AI生成LightRAG 是一种基于图结构的检索增强生成框架,通过构建知识图谱实现双层检索范式。介绍其核心原理、技术栈选型及本地部署流程。涵盖 LLM 与 Embedding 模型配置、Bun 环境搭建、WebUI 界面操作(文档管理、知识图库、检索)以及 API 使用。对比了传统 RAG 与 GraphRAG 的优劣,重点解析 LightRAG 的增量索引与混合查询机制,适合希望快速落地高效 RAG 系统的开发者参考。
介绍基于 ViT 模型的图像分类 Web 应用开发。采用前后端分离架构,后端使用 FastAPI 和 ModelScope 提供 API 服务,前端利用 HTML 和 JavaScript 构建界面。支持 1300 多种日常物品识别,涵盖日用品、动物、植物等类别。内容包含环境配置、API 实现、前端交互逻辑、性能优化及部署安全建议。该方案适用于电商搜图、智能相册等场景,具备良好的扩展性与易用性。

介绍 AR 眼镜光学镜头设计实例,涵盖应用领域、设计规格、系统拓扑、参数设置及优化策略。设计规格包括 50 度 FOV、20mm 眼动距、小于 1.5% 畸变等关键指标。系统采用 4P1BS 非对称结构,结合自由曲面与非球面技术。优化分为五个阶段:基础框架锁定、畸变重影优化、效率轻量化平衡、环境适应性及可制造性收敛。方案旨在解决传统 AR 镜头视场窄、重影眩晕等问题,实现轻量化佩戴与高质量虚实叠加。

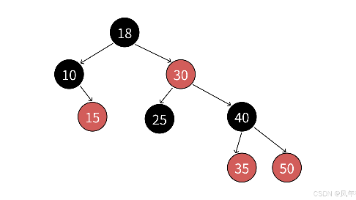
红黑树是一种自平衡二叉搜索树,通过颜色约束确保路径长度不超过两倍,维持 O(logN) 的时间复杂度。文章详细解析其四条核心规则,对比 AVL 树平衡策略,重点阐述插入操作中的变色、单旋与双旋调整逻辑,并给出完整的 C++ 节点结构定义、插入查找实现及校验代码,适合希望深入理解 STL map 底层机制的开发者阅读。

微软 Copilot Cowork 从代码补全工具进化为具备感知、规划、执行能力的智能体。解析其核心逻辑,并演示如何利用 Kotlin 结合大模型 API 构建简易 AI Agent,探讨个人开发者如何低成本打造具备协作能力的智能应用。

JavaScript 单线程特性导致高负载时界面易卡顿。Web Worker 提供子线程机制,将耗时计算移至后台,确保主线程流畅。涵盖基础用法、大数据处理实战及 Vue3 封装方案,重点解析通信机制、DOM 限制及内存管理,帮助开发者有效优化前端性能。
综述由AI生成C++ multiset 是 STL 中支持重复元素的有序关联容器,底层基于红黑树实现。其核心特性(有序性、允许重复、高效操作)、常用接口(构造、插入删除、查找统计)及实战场景(频率统计、中位数查询)。重点对比了 multiset 与 set 的区别,强调禁止直接修改元素值、迭代器失效规则及使用注意事项。通过 equal_range 等接口可高效处理重复数据,适用于需保留重复序列且保持有序的场景。
Zotero 论文阅读颜色标记体系通过黄绿红蓝紫橙灰粉八种颜色区分核心价值、技术细节及延伸背景,辅助科研人员快速筛选、精读及复用文献。该体系包含三阶段工作流:筛选期关注摘要结论,精读期深入方法实验,复用期针对性回顾代码或灵感。红色标记缺陷,橙色记录启发,蓝色解析实现,确保标记直接服务于科研行动。
综述由AI生成介绍逻辑回归算法原理及其在癌症识别中的应用。核心在于使用 Sigmoid 函数将输出映射至 (0,1) 区间,具备概率可解释性。文中展示了 Sigmoid 函数的 Python 实现细节,包括处理数值溢出的安全写法及向量化计算优化。此外,强调了特征标准化对模型性能的重要性,特别是在特征尺度差异较大的医疗场景下。

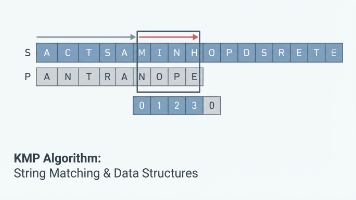
综述由AI生成KMP 算法通过预处理模式串生成 next 数组,记录最长公共前后缀长度,从而在字符串匹配失配时避免主串指针回溯。相比暴力匹配 O(mn) 复杂度,KMP 将时间复杂度优化至 O(m+n)。核心在于利用已匹配部分的对称性,当字符不匹配时,模式串指针根据 next 数组回退,而非从头开始。文章详细讲解了 next 数组构建逻辑及主匹配过程,并通过 C++ 代码示例展示了具体实现。

讲解 LeetCode 301 删除无效括号问题,要求删除最小数量括号使字符串有效并返回所有可能结果。提供 BFS 和 DFS 两种解法,BFS 保证最少删除,DFS 配合剪枝优化。包含 Java 和 Go 代码实现,分析时间与空间复杂度,涵盖空串、全无效等边界情况处理。
综述由AI生成结合 Whisper 模型与联邦学习,实现语音识别的分布式隐私保护训练。在本地客户端更新模型只上传参数差值,聚合时叠加高斯噪声满足差分隐私。给出从环境搭建到完整训练循环的 PyTorch 代码,并讨论实际应用场景、框架选择及通信开销、数据异质性等挑战。

Python 爬虫技术涵盖静态网页抓取、动态渲染处理及分布式部署。核心流程包括发送 HTTP 请求、解析 HTML 数据(使用 BeautifulSoup、lxml)、存储至数据库或文件。进阶内容涉及 Scrapy 框架搭建、Selenium/Playwright 浏览器自动化、aiohttp 异步并发优化。同时需应对反爬策略,如 User-Agent 伪装、代理 IP 池、验证码识别等。提供从零开始的代码示例与工具盘点,帮助开发者构建…
具身智能强调物理身体与环境的实时互动。解析其核心定义,对比传统机器人与虚拟 AI 的差异。介绍 EIBench 和 GM-100 评测体系的具体量化指标,涵盖双臂协同与力觉控制表现。同时梳理工信部标委会的标准建设方向,包括基础定义、智能化及适配标准,为理解从专用工具向通用智能体跨越提供依据。

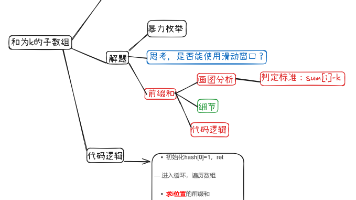
针对和为 K 的子数组问题,暴力枚举时间复杂度过高。由于数组包含负数,滑动窗口无法保证单调性,故不可用。核心思路采用前缀和配合哈希表。遍历数组计算当前前缀和,若哈希表中存在前缀和减去 K 的值,则说明存在满足条件的子数组。初始化哈希表记录前缀和为 0 的情况,遍历时先查询再插入,避免自身干扰。该方法将时间复杂度优化至 O(N)。

模拟算法专题涵盖替换问号、提莫攻击、Z 字形变换、外观数列及数青蛙五个经典题目。通过 C++ 实现展示字符串遍历、时间区间差值计算、字符排列规律寻找及状态变化统计方法。重点在于理解贪心策略、周期性规律和有限状态机等逻辑模型,帮助读者掌握模拟类问题的通用解题思路。
AMD 锐龙 AI 7 H 350 与锐龙 7 H255 两款处理器在架构、AI 能力及功耗策略上存在显著差异。H350 凭借 Zen 5 架构与 50 TOPS NPU 算力在单核及 AI 任务中占优,适合轻薄本场景;H255 则拥有更高的默认功耗与更强的核显规格,更适合传统高性能需求。综合来看,若无需本地 AI 加速,H255 性价比略高;反之 H350 更具前瞻性。

综述由AI生成Claude 官方 Skill-Creator 是一套将 AI 技能开发标准化、流程化、工程化的完整体系。它解决了技能质量无法保证、触发精度低及难以持续迭代三大痛点。系统包含创建、评测、优化三大模块,通过多智能体协作实现自动化测试与评估。核心文件 SKILL.md 定义技能元数据与指令,配合描述优化系统提升触发率。企业落地需遵循规范目录结构,设置明确指标,分阶段推进从试点到规模化应用。该工具链让非技术人员也能开发高质量可迭代的 AI 技…

综述由AI生成2023 年网络安全领域的五大发展趋势,包括人工智能应用、区块链技术、物联网安全、零信任模型及人机协同。文章详细阐述了网络安全的重要性,并提供了从零开始为期三个月的系统化学习路径,涵盖基础理论、渗透测试、操作系统、网络协议、数据库及 Web 安全等内容。同时强调了编程能力在安全工程师职业晋升中的关键作用,并推荐了权威的学习资源和进阶方向,旨在帮助读者建立完整的知识体系并顺利入行。
介绍在 Windows 系统下配置 Python 环境变量的方法。推荐安装时勾选 Add Python to PATH,若已安装未勾选则需手动添加路径至系统环境变量 Path 中。步骤包括查找安装路径、打开环境变量设置、新建 Path 条目并包含 Scripts 目录。最后通过 CMD 验证 python 和 pip 命令是否生效。常见问题包括未重启 CMD、遗漏 Scripts 目录等。