
编程语言SaaSAI算法
万方AIGC检测降重工具实测与选择指南
综述由AI生成万方检测算法与知网维普存在差异,通用降重工具未必适用。对比了多款支持万方的在线工具,分析了它们在降低 AI 率方面的实际表现及价格策略。重点在于确认工具是否明确支持万方平台,避免使用仅针对知网优化的方案导致复检失败。建议优先利用免费额度测试效果,并预留复检时间以确保达标。
综述由AI生成万方检测算法与知网维普存在差异,通用降重工具未必适用。对比了多款支持万方的在线工具,分析了它们在降低 AI 率方面的实际表现及价格策略。重点在于确认工具是否明确支持万方平台,避免使用仅针对知网优化的方案导致复检失败。建议优先利用免费额度测试效果,并预留复检时间以确保达标。
综述由AI生成汇总了 Python 面试核心知识点。涵盖装饰器的原理、实现及注意事项;深浅拷贝的区别与应用场景;常见数据结构(List、Set、Dict)特性对比及数组链表差异;List 去重方法;递归的使用场景与循环对比;以及 Python2 与 Python3 在语法、编码、库等方面的主要区别。旨在帮助开发者巩固基础,应对技术面试。
综述由AI生成GitHub Copilot 是一款由 GitHub 和 OpenAI 合作开发的 AI 编程助手,基于 GPT 模型在大量开源代码上训练,能根据上下文自动生成代码并提供智能建议。其在 Python 开发中的代码生成、补全、优化等应用场景,分析了提高效率、辅助学习和提升代码质量等优势,同时也指出了可能生成错误代码、依赖上下文及版权风险等局限性。通过提供明确上下文、验证生成代码及持续学习,开发者可有效利用该工具提升开发效率与代码质量。
Python 核心技术点涵盖装饰器原理与实现、深浅拷贝区别及场景、常见数据结构特性对比。内容包含列表去重技巧、递归与循环选用策略,以及 Python 2 与 3 版本关键差异。旨在帮助开发者巩固基础,理解底层机制,避免常见陷阱。
综述由AI生成通过双哨兵节点将链表分为小于 x 和大于等于 x 两部分,保持原有相对顺序。遍历原链表进行尾插操作,最后拼接两个子链表并断开尾部指针防止成环。该方法时间复杂度 O(n),空间复杂度 O(1),有效解决了链表分区问题。
综述由AI生成Python 核心知识点涵盖装饰器原理与实现、深浅拷贝区别、常用数据结构对比、列表去重方法、递归应用场景及 Python2 与 Python3 版本差异。文章通过类比和代码示例解析了装饰器的闭包机制、深拷贝的递归复制特性,对比了 List 与 Set 的性能差异,阐述了递归在树形结构中的优势,并总结了两个主要版本在语法、编码及库兼容性上的关键变化,适合用于技术面试准备或基础巩固。
Python 面试常考知识点涵盖装饰器原理、深浅拷贝区别、数据结构选择及递归应用等。装饰器通过闭包在不修改原代码前提下增强功能;深浅拷贝涉及内存复制策略;列表与集合各有优劣;递归适合树形结构但需注意栈溢出。此外,Python2 与 3 在语法和编码上存在显著差异,新项目建议直接使用 Python3。
算法是解决特定问题求解步骤的描述,表现为指令的有限序列。其具备输入输出、有穷性、确定性、可行性五个基本特性。设计良好算法需满足正确性、可读性、健壮性及高效率低存储量要求。效率度量主要采用事前分析估算方法,通过分析程序运行时间依赖因素来评估。算法复杂度分为时间复杂度和空间复杂度,是衡量算法性能的关键指标,也是校招面试中的常见考点。
综述由AI生成介绍利用 ChatGPT 进行文本与数据结构化的方法。涵盖中文排版序号规则、Markdown 语法(标题、列表、加粗)、以及 YAML 和 JSON 的数据结构示例。通过对比不同格式特点,展示如何提升文档可读性与数据可维护性,并提供了基于 Python 的 ChatGPT API 调用示例,帮助开发者高效管理信息。
通义万相 2.1 开源视频生成 AI 模型的核心能力。该模型在 VBench 排行榜上表现优异,超越 Sora 和 Runway。支持 1080P 分辨率输出,无时长限制,能模拟自然动作并还原物理规律。这些特性标志着 AIGC 领域的重大突破。
综述由AI生成python-okx 库作为 OKX 交易所 v5 API 的 Python 封装,旨在简化加密货币量化交易的 API 集成。内容涵盖环境配置、API 密钥设置、账户资金查询、现货交易自动化、衍生品合约风控、WebSocket 实时数据监控及多账户批量操作等核心功能。此外,文章还提供了错误处理最佳实践、性能优化建议以及网格交易等算法策略的实现示例,帮助开发者构建稳定高效的交易系统。
综述由AI生成介绍 Microi 吾码在服务器虚拟化中的应用,包括资源分配监控、调度优化、网络配置安全、高可用备份恢复及多平台集成。通过 Python SDK 示例演示了虚拟机创建、资源获取、流量限制及故障转移等操作,提供高效稳定的虚拟化解决方案。
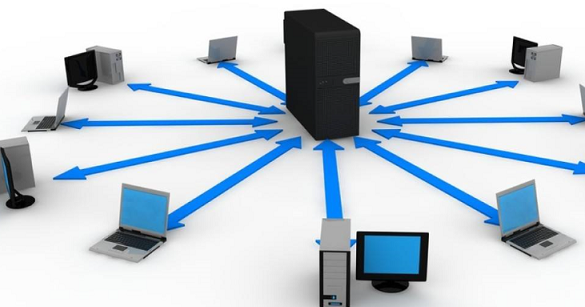
综述由AI生成详细阐述了服务器反爬虫的原因、常见爬虫类型及核心概念。重点分析了基于身份识别、爬虫行为和数据加密三大反爬方向的具体实现与应对策略。内容涵盖 Headers 检测、请求参数分析、频率限制、蜜罐陷阱及数据加密处理等技术细节,并提供了 Python 代码示例。文章最后总结了反爬虫的最佳实践,强调合规性与成本控制,旨在帮助技术人员构建更完善的反爬体系。
综述由AI生成2024 年中国 AI 算力行业在 AIGC 热潮下快速发展。GPT-4o 多模态能力与 OpenAI o1 推理能力提升显著,英伟达 Blackwell 架构降低了算力成本。AI for Science 获诺贝尔奖认可,应用端涵盖搜索、编程及 Agent 交互。开发者需掌握大模型系统设计、提示词工程、平台应用(如阿里云 PAI)、知识库构建(LangChain)及微调技术,以应对大数据时代的实际需求。行业未来将更注重系统工程能力与业务…
Windows 系统安装 vLLM 支持通过已发布的 wheel 包或源码构建两种方式。推荐使用 wheel 包,需确认 Python、PyTorch 及 CUDA 版本兼容性。源码构建需 Visual Studio 环境、CUDA 配置及特定环境变量,编译耗时较长且 Flash Attention v3 默认禁用。安装过程中需注意依赖冲突及路径设置问题。
Windows 系统下 vLLM 安装主要包含 wheel 包安装和源码构建两种方式。推荐优先使用已发布的 wheel 包,需确认 Python、PyTorch 及 CUDA 版本兼容性。源码构建需安装 Visual Studio 2019 及以上版本,配置 CUDA 环境变量,并处理 Flash Attention 等依赖。安装过程中需注意依赖冲突问题,必要时手动修复 triton_windows 或 xformers 等库。编译时需…
综述由AI生成Aurora 64B/66B 是 Xilinx 提供的高速串行通信协议 IP 核,适用于点对点数据传输。了 Vivado 中的配置流程、关键端口定义及例化方法,重点介绍了 framegen 和 framecheck 模块在测试中的作用,并给出了传输回环功能的实现步骤与调试技巧,帮助开发者快速验证链路完整性。
Llama-2-7b 模型在昇腾 Atlas 800T A2 NPU 上的性能基准测试覆盖首 Token 延迟、解码吞吐量及批量处理等六大场景。实测显示短输入延迟约 68ms,解码速度稳定在 64 tokens/s,高并发下吞吐量提升显著。建议实时交互应用优化 Prompt 以降低延迟,内容生成类应用利用批量处理提升效率,并配置至少 16GB 显存以支持 KV Cache 增长。
VSCode 调试大模型训练代码可通过直接启动、端口监听及命令行参数三种方式实现。直接启动法配合 torch.distributed.run 支持多卡且配置简单;端口监听法需修改代码注入 debugpy;命令行法无需改码但仅限单卡。推荐优先使用直接启动法,注意处理环境变量及端口冲突问题,可显著提升调试效率。此外,还需掌握条件断点、变量监视及常见报错排查技巧,以确保训练过程稳定可控。
综述由AI生成Gdspy 库的安装与环境配置方法。首先检查 Python 版本及依赖项如 Numpy。推荐使用 pip 进行一键安装,也可从源码编译。安装后通过导入模块并打印版本号验证。文档提供了字体渲染和光子电路示例代码。该工具适用于集成电路布局文件创建,支持多边形处理与布尔运算。