
PythonAI算法
基于 LangChain 封装自定义 LLM 及讯飞星火接入示例
综述由AI生成介绍了 LangChain 中 LLM 抽象层的概念,演示了如何通过继承基类实现自定义 LLM,并提供了基于讯飞星火 WebSocket API 的完整封装示例,包括鉴权逻辑与调用方法。
综述由AI生成介绍了 LangChain 中 LLM 抽象层的概念,演示了如何通过继承基类实现自定义 LLM,并提供了基于讯飞星火 WebSocket API 的完整封装示例,包括鉴权逻辑与调用方法。
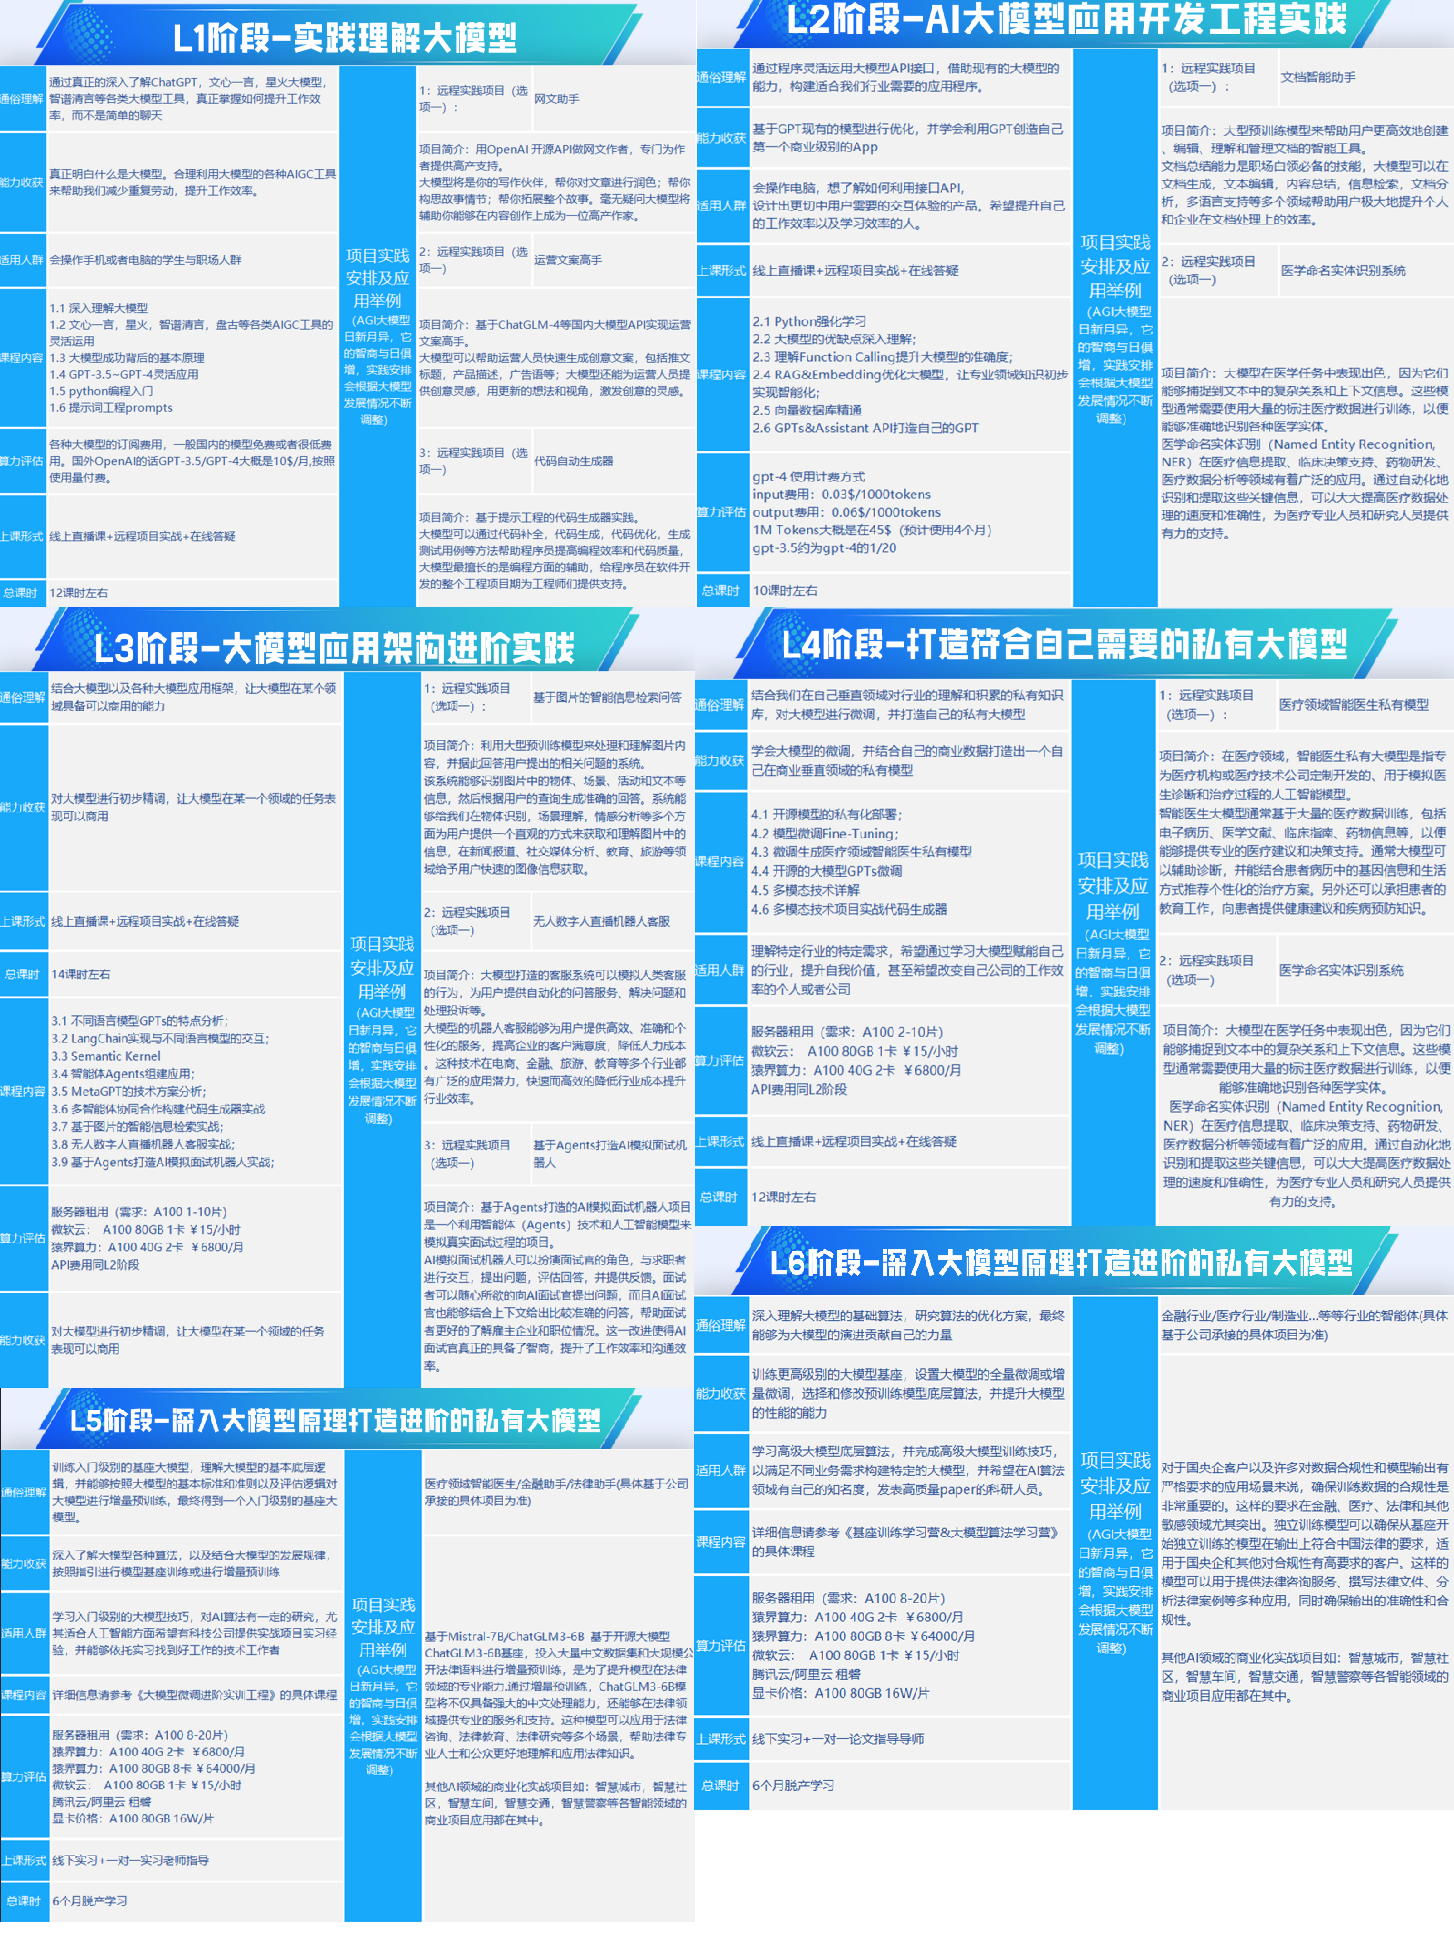
综述由AI生成新加坡国立大学尤洋教授所著《实战 AI 大模型》一书及其核心技术体系。内容涵盖 Transformer、BERT、GPT 等主流模型原理,重点解析了 ColossalAI 系统在数据、模型、流水线并行及内存优化方面的实现,支持在有限资源下高效训练大模型。文章还梳理了从基础理解、API 开发、架构实践到私有化部署的四阶段学习路线,为开发者提供系统化的 LLM 学习路径与技术参考。

综述由AI生成深入解析了人工智能及大语言模型的基础概念、核心技术架构与训练流程。内容涵盖 Transformer 原理、预训练与微调范式、主流开源与闭源模型生态对比,以及在实际业务中的落地场景如智能客服与代码辅助。同时探讨了当前面临的技术挑战、伦理安全问题及多模态与智能体未来的发展趋势,为读者提供全面的技术入门指南。

综述由AI生成详细记录了在 Mac 本地部署 ChatGLM-6B 和 ChatGLM2-6B 大模型的过程,包括环境配置、模型下载、量化部署及 Web 演示启动。文章进一步介绍了如何使用 LangChain 框架接入本地模型,实现 LLMChain、RetrievalQA 检索增强生成及 SQLDatabaseChain 等功能,并分析了小参数量模型在处理复杂提示时的局限性。最后展示了 langchain-ChatGLM 的本地知识库问答实践,为开…
综述由AI生成Meta 发布的 Llama3 开源大模型及其在中文场景下的部署方案。内容涵盖模型选型、量化技术(8bit/4bit/AWQ)的原理与选择、基于 Ollama 和 llama.cpp 的本地环境搭建步骤、Python API 调用示例以及 WebUI 可视化界面的配置方法。文章重点讲解了如何在无 GPU 环境下利用 CPU 运行量化模型,并提供了性能优化建议和常见问题排查指南,帮助开发者快速实现本地大模型应用。

综述由AI生成检索增强生成(RAG)通过将外部数据与基础模型结合,增强 LLM 能力,使 AI 回应更真实可靠。文章阐述了 RAG 工作原理、与传统模型区别及优势,如上下文相关性、事实核查等。同时分析了实施挑战,包括数据质量、可扩展性等。重点介绍了高级 RAG 架构,包括文档分块、CRAG 验证机制、RAG Fusion 融合查询、HyDE 虚拟答案技术及层次索引。此外提供了基于 LangChain 的基础实现代码示例,并探讨了 GraphRAG 等…

大模型算法岗位面试的 28 个核心问题,涵盖 RAG 技术体系、幻觉处理、微调方法(SFT/LoRA/RLHF)、主流开源模型架构(LLaMA/ChatGLM)、训练优化技巧(DeepSpeed/混合精度)及推理显存管理等内容。旨在帮助求职者系统掌握大模型关键技术点,提升面试通过率。

综述由AI生成大型机器学习模型是指具有大规模参数和复杂计算结构的深度学习模型,通常由数十亿至数千亿参数构成。文章详细阐述了大模型与小模型的区别,重点分析了涌现能力这一核心特征。内容涵盖大模型发展历程,从 CNN 到 Transformer 架构的演变,以及 GPT、BERT 等里程碑模型。同时介绍了大模型按数据类型分为语言、视觉和多模态三类,按应用层级分为通用、行业和垂直模型。最后深入探讨了模型泛化能力与微调技术,包括全量微调、LoRA、指令微调及…

综述由AI生成Transformer 模型的位置编码机制是区分序列顺序的关键。详细解析了三种主流编码方法:绝对位置编码利用正弦余弦函数为每个位置生成唯一向量,简单但泛化性弱;相对位置编码关注元素间距离,适合长距离依赖;旋转位置编码(RoPE)通过向量旋转嵌入位置信息,支持长序列外推。文章提供了 Python 和 PyTorch 代码实现及对比分析,指出绝对编码适用于短文本,相对编码适合翻译任务,而 RoPE 已成为大语言模型的首选方案。

综述由AI生成基于吴恩达 translation-agent 思路,在 Coze 平台上构建具备自我反思机制的长文本翻译智能体。通过工作流编排实现单文本块的翻译、反思与改进,利用 Bot API 结合 Python 代码处理长文本的分块与循环调用。文章详细展示了提示词优化、API 接入及 Token 分割逻辑,解决了长文本超出上下文限制的问题,实现了高质量的中英互译自动化流程,并提供了关于温度设置、重试机制及格式清洗的优化建议。
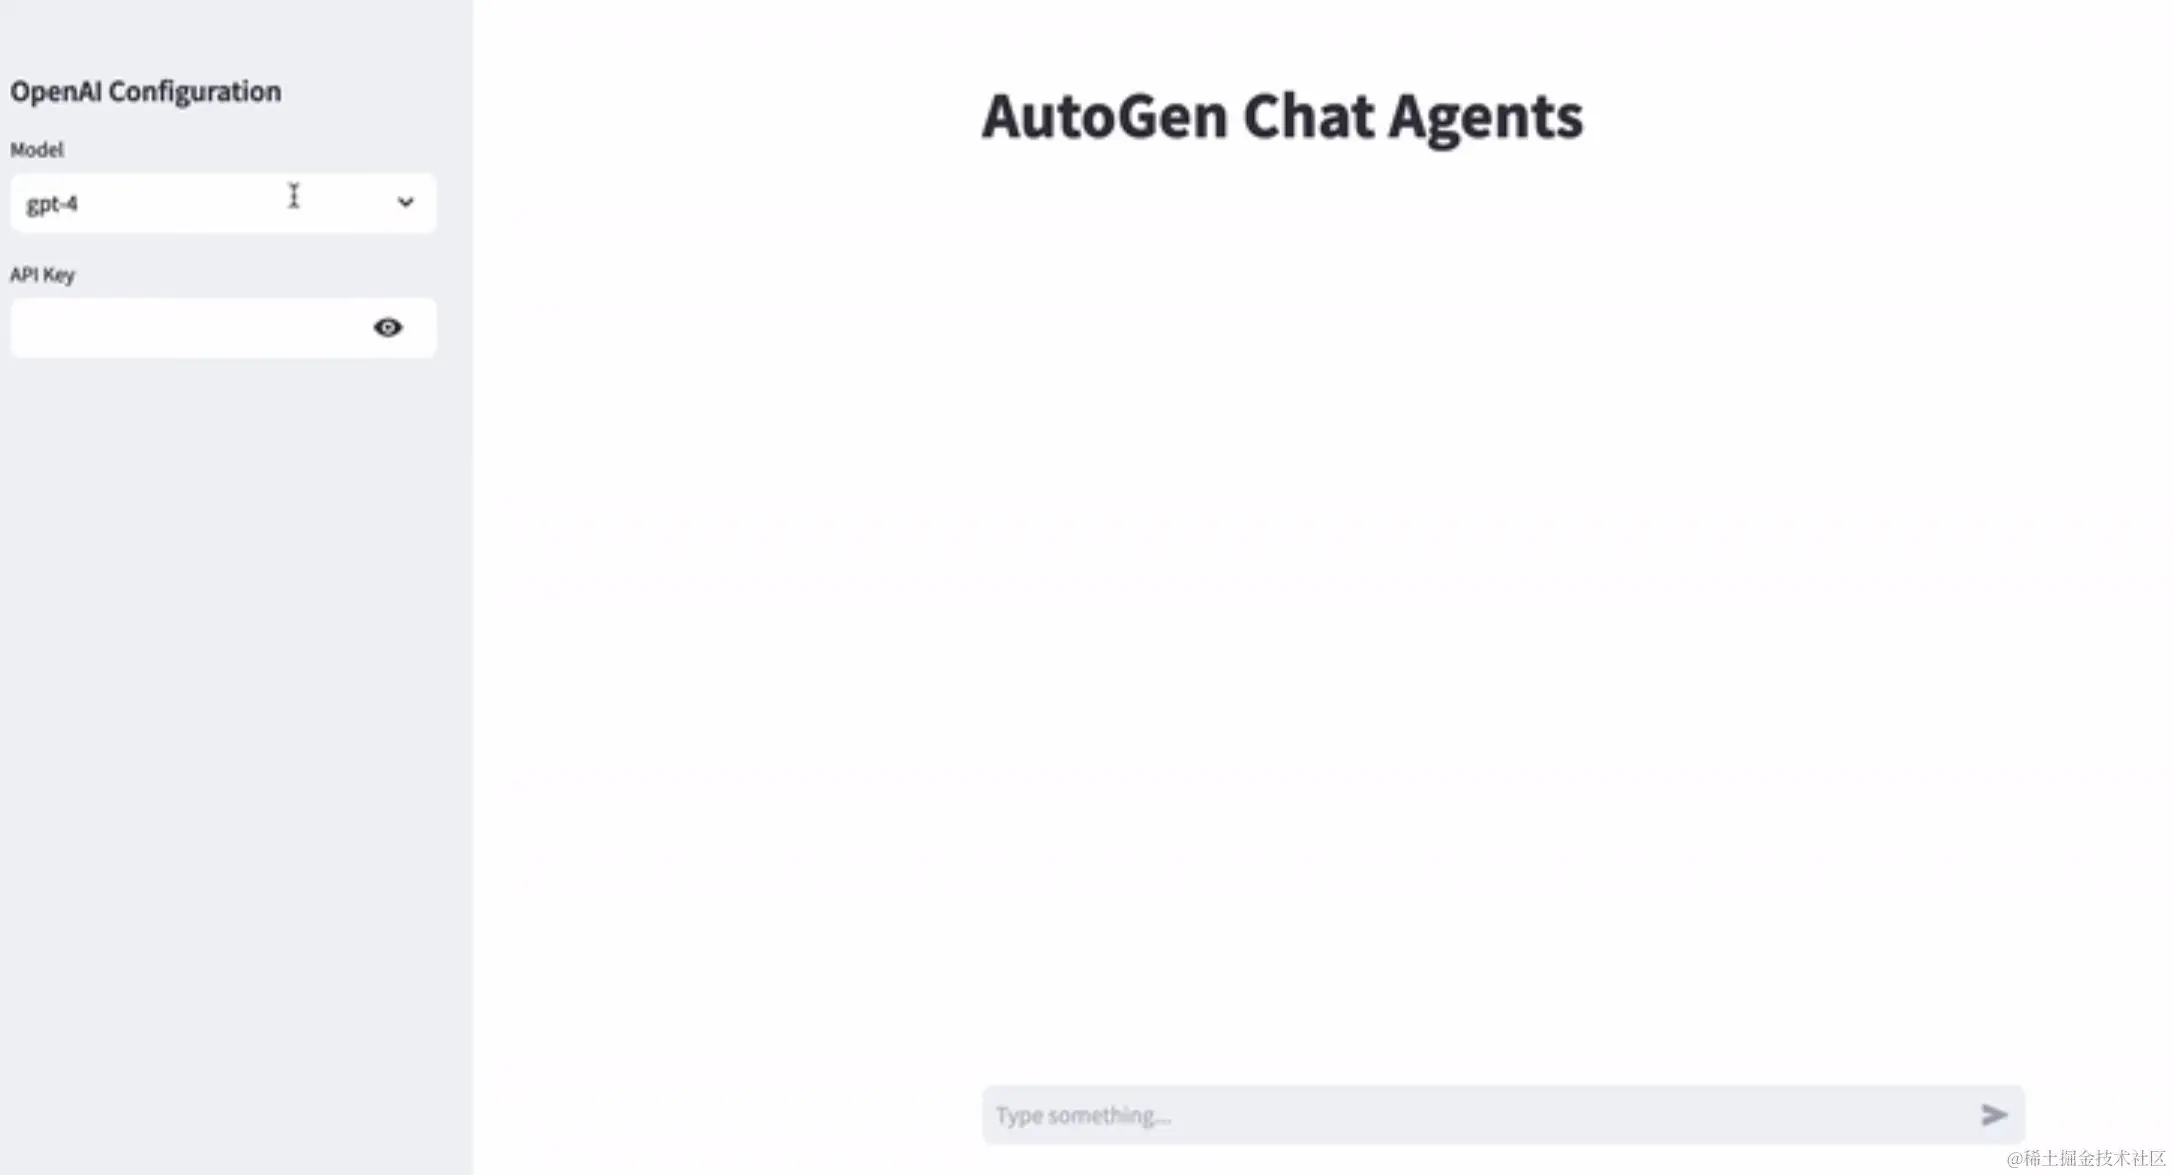
综述由AI生成如何使用 Streamlit 框架快速构建基于 AutoGen 的 AI Agent Web 应用。内容涵盖环境搭建、侧边栏配置、主聊天界面实现、自定义 Agent 类以支持消息渲染以及异步会话处理。通过重写 Agent 的消息处理方法,实现了对话内容在浏览器端的实时展示,解决了原生 Agent 无法直接对接 Web UI 的问题,为开发者提供了一种可视化的 Agent 工作流方案。同时补充了关于 Streamlit 状态管理和优化的建…

Safetensors 是一种用于安全存储张量的新格式,旨在替代不安全的 pickle 格式。它通过零拷贝技术提升加载速度,支持惰性加载以优化内存使用,并天然防止反序列化攻击。深入解析其内部结构、安全性优势及在 PyTorch 中的实践应用,涵盖文件头定义、数据偏移量机制以及与 HuggingFace 生态的集成方式,为开发者提供完整的模型权重存储解决方案。
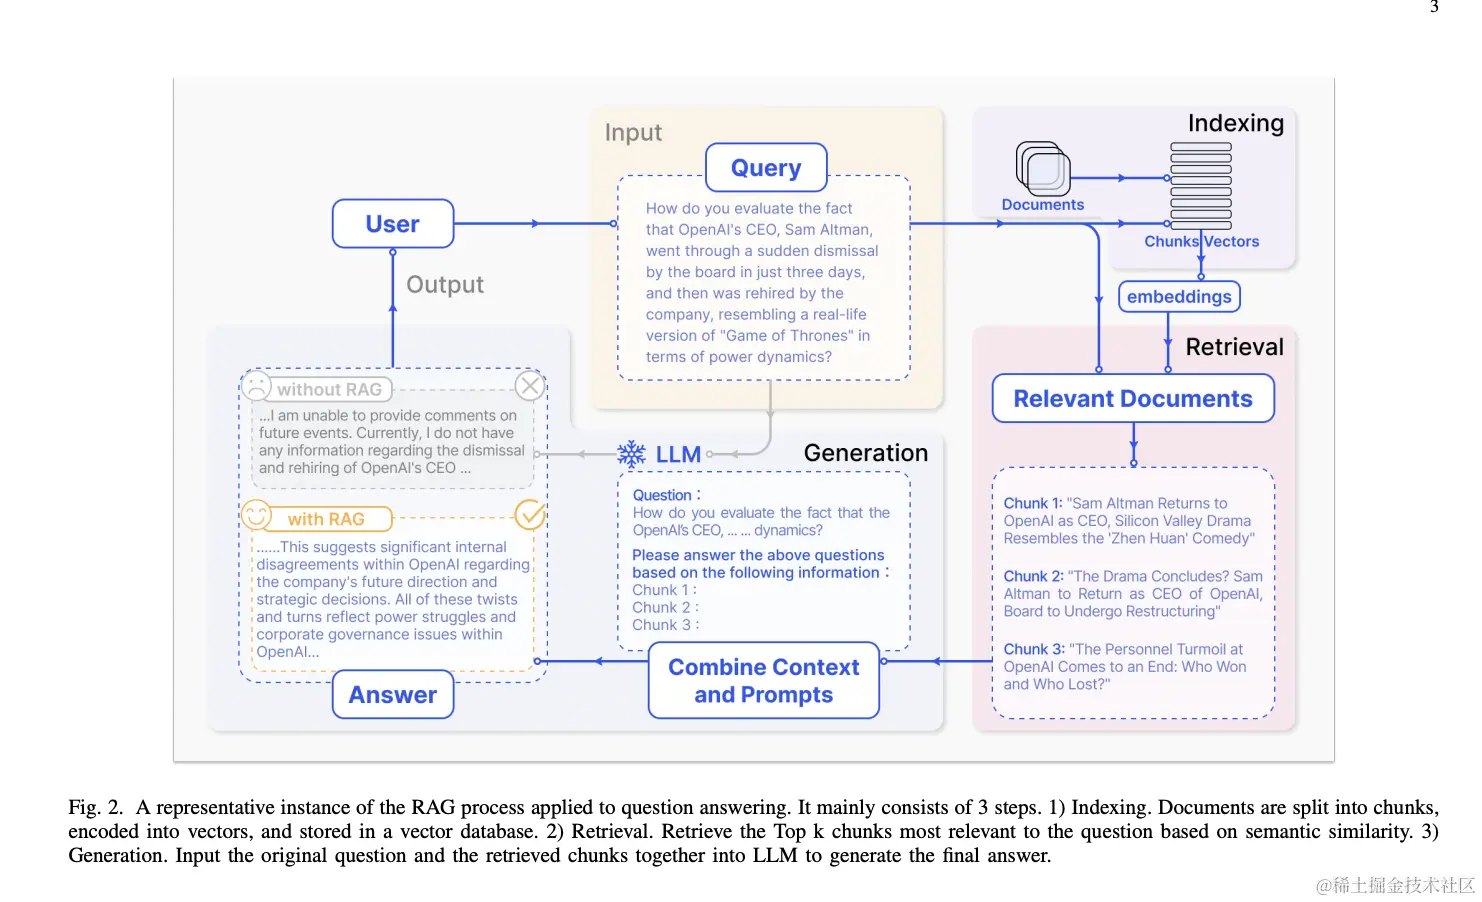
综述由AI生成检索增强生成(RAG)通过整合外部知识库解决大语言模型的幻觉与知识滞后问题。阐述了 RAG 技术的三个发展阶段:初级 RAG 采用标准检索 - 阅读流程但存在精度不足;高级 RAG 引入查询重写、重排序及混合检索优化召回率;模块化 RAG 则通过动态路由、记忆模块及多策略组合实现高度自适应。最终总结指出模块化架构已成为构建复杂 RAG 应用的标准范式,支持端到端训练与跨组件集成,显著提升了知识密集型任务的处理能力。

综述由AI生成基于 MetaGPT 框架构建 LLM 订阅服务的完整流程。通过自定义爬虫 Action 爬取 GitHub Trending 或 Huggingface 论文数据,结合 LLM 进行内容分析与总结,并利用 SubscriptionRunner 模块实现定时触发。最终通过 Discord 机器人或 QQ 邮箱回调函数将结果推送到用户端。文章涵盖了环境配置、代码实现细节及扩展方法,帮助开发者快速搭建自动化信息聚合 Agent。
AI 领域发展迅速,涵盖多模态大模型、可解释人工智能、扩散模型、深度生成模型、PyTorch 框架及图深度学习。精选 6 部名家著作,介绍技术原理、实战案例及应用场景,适合初学者到专业人士阅读,帮助读者系统掌握大模型时代的核心技术与开发实践。

综述由AI生成探讨了 AI 产品经理转型大模型领域的路径。内容包括评估自身是否适合该领域所需的基本素质和技能,如技术理解、数据分析、用户洞察等。提供了学习大模型原理、应用及优缺点的资源推荐,涵盖经典论文、开源框架及实践工具。此外,还阐述了如何寻找应用场景、与技术团队协同实现产品化商业化的方法,并总结了行业面临的机遇与挑战,为从业者提供系统的转行参考。

基于 GPT-4 和 ChatGPT 的大模型应用开发入门指南。内容涵盖 Python 开发环境搭建、OpenAI API 基础调用方法、提示词工程最佳实践、LangChain 框架的使用以及模型微调与部署流程。通过代码示例和步骤解析,帮助开发者快速上手构建智能应用,解决实际业务需求。
综述由AI生成介绍如何利用 Llama3 大模型和 LangChain 框架,结合 Weaviate 向量数据库构建本地私有知识库。通过 RAG 技术解决大模型时效性与幻觉问题。涵盖环境配置、语料加载分块、向量化存储、检索增强及问答链实现。修正了原代码参数错误,提供完整 Python 示例及常见问题排查指南,助力开发者快速上手本地化 AI 应用。

综述由AI生成探讨了在本地环境中高效部署大型语言模型(LLM)的六种主要策略。针对隐私保护和专有数据处理需求,开源模型提供了可行方案。文章对比了基于 Python 的 Hugging Face Transformers 和 LangChain 框架,以及高性能推理引擎 Llama.cpp、便携工具 Llamafile、服务化部署 Ollama 和桌面应用 GPT4ALL。每种方案在易用性、性能、硬件要求和功能支持上各有优劣,开发者可根据自身技术背景与…
综述由AI生成文档图像识别面临场景多样、设备不稳定、质量退化等技术挑战。通用大模型 GPT-4 虽具备多模态能力,但在中文识别、复杂版式解析及长文档处理上存在不足。垂直领域大模型如素级 OCR 统一模型 UPOCR 和 OCR 大一统模型 SPTS v3 通过统一任务处理和序列预测,提升了识别精度与效率。结合大型语言模型可实现智能检索、摘要生成及多模态理解,推动文档处理向智能化、自动化发展。