

PythonAI算法
机器学习模型评价与算法选择综述
综述由AI生成综述了机器学习中的模型评价与算法选择技术。重点讨论了泛化性能评估方法,包括留出法、交叉验证及自举技术,分析了偏差 - 方差权衡对 k 值选择的影响。文章强调了在小数据集上使用 Bootstrap 评估不确定性的必要性,并介绍了用于算法对比的统计检验方法,如 McNemar 测试和嵌套交叉验证。通过规范实验设计和统计推断,可有效避免过拟合,确保模型选择的科学性与可靠性。
综述由AI生成综述了机器学习中的模型评价与算法选择技术。重点讨论了泛化性能评估方法,包括留出法、交叉验证及自举技术,分析了偏差 - 方差权衡对 k 值选择的影响。文章强调了在小数据集上使用 Bootstrap 评估不确定性的必要性,并介绍了用于算法对比的统计检验方法,如 McNemar 测试和嵌套交叉验证。通过规范实验设计和统计推断,可有效避免过拟合,确保模型选择的科学性与可靠性。
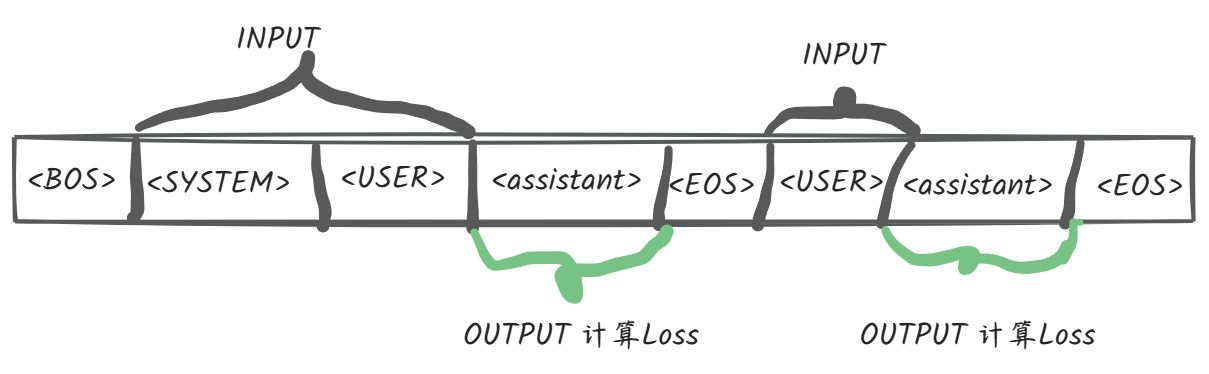
综述由AI生成GLM-4-9B 开源模型微调过程中,Loss 计算逻辑直接影响模型收敛效果。深入解析了基于对话格式的微调数据构建方法,重点阐述了在 process_batch 函数中如何通过角色掩码区分系统提示、用户输入与助手回复的权重。通过设置特定角色的 loss_mask 为 False 并将对应标签设为 -100,确保模型仅对助手生成的内容进行预测训练。同时对比了与其他框架如 InternLM、XTuner 的实现差异,提供了关于截断策略和 E…
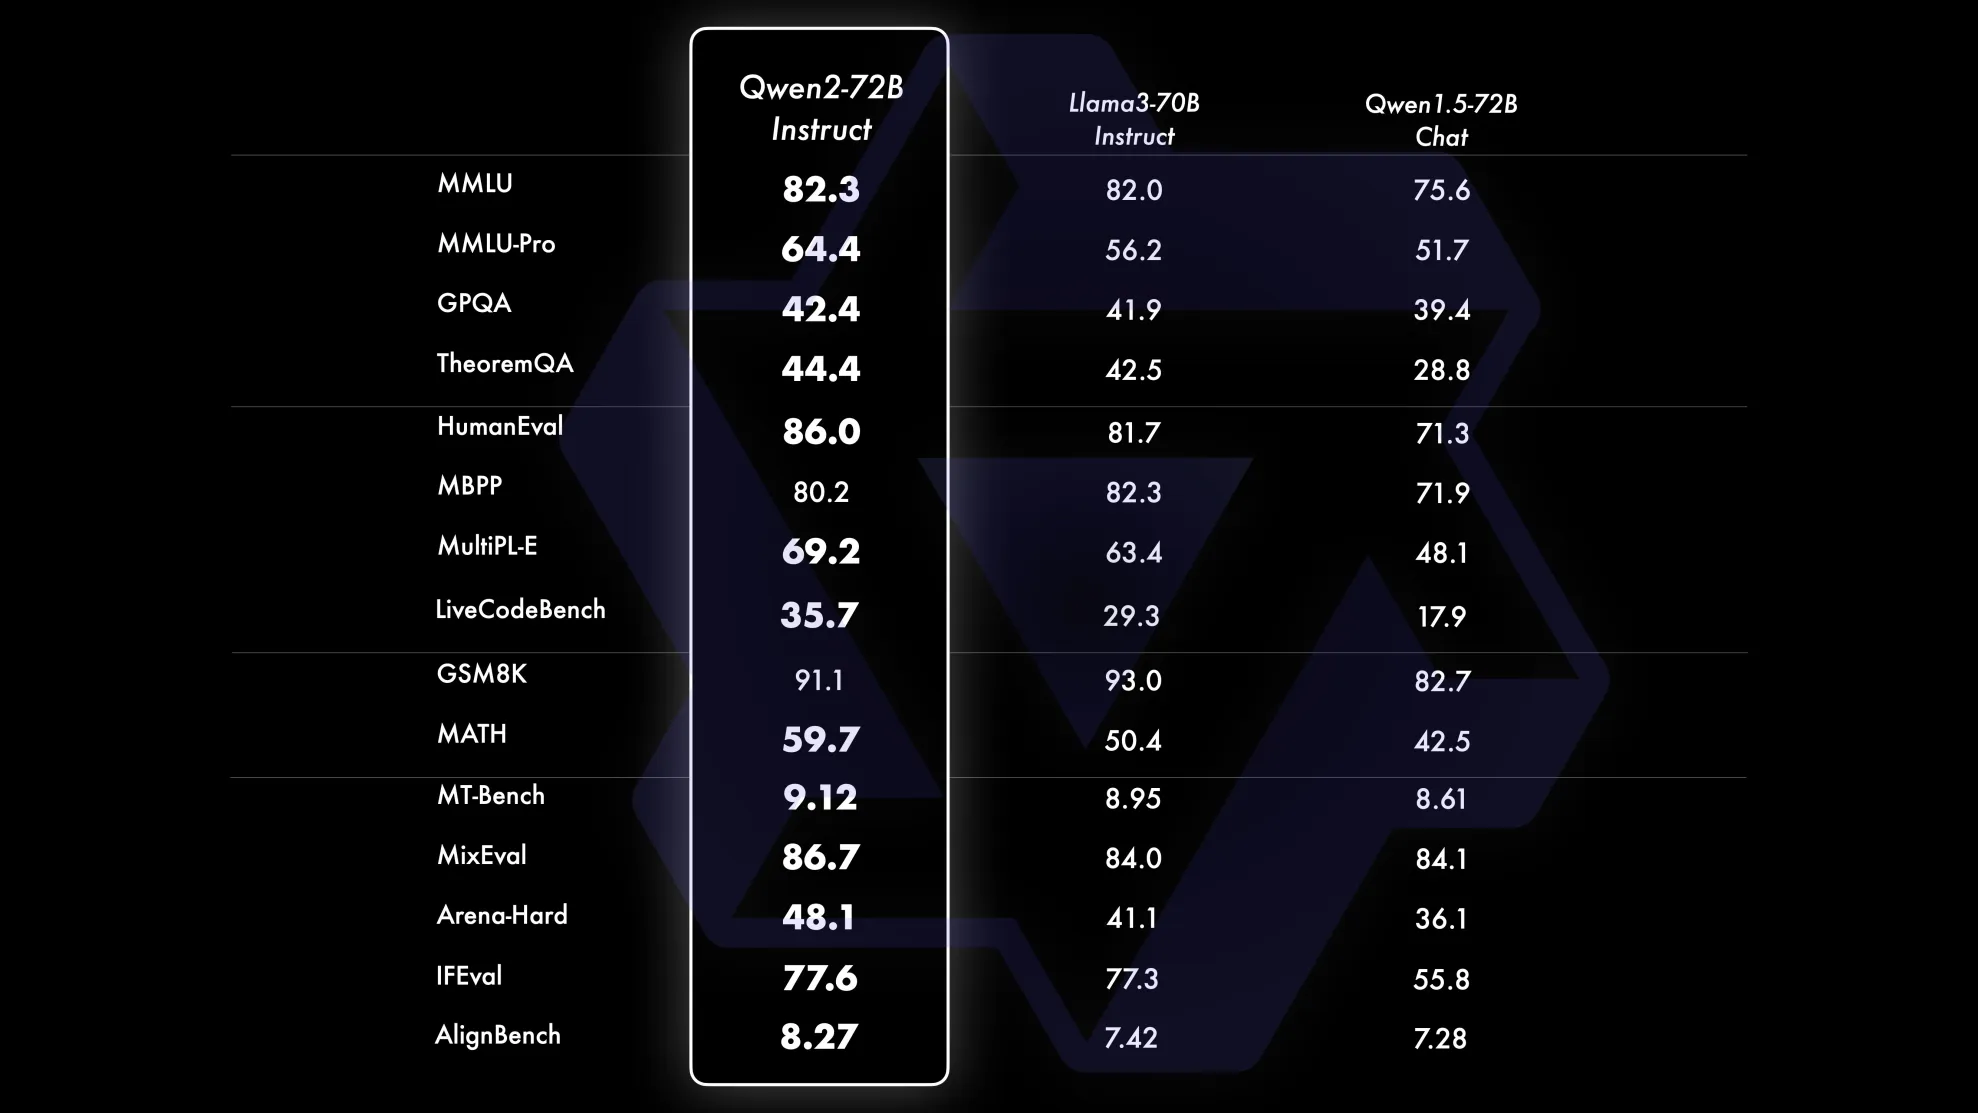
综述由AI生成阿里巴巴通义千问 Qwen2 系列开源模型的本地部署方法。主要涵盖通过 llama-cpp-python 启动服务、使用 Python 客户端进行命令行对话,以及利用 Ollama 工具配合 WebUI 实现可视化聊天界面。文中详细说明了环境依赖安装、模型文件下载、Modelfile 配置及 Web 工程启动步骤,并对比了 Qwen2-7B 与 Llama3-8B 的性能表现。

综述由AI生成如何利用本地部署的大语言模型结合检索增强生成(RAG)技术构建免费 AI 搜索问答助手。方案使用 Ollama 运行本地模型,通过搜索引擎获取最新网络信息,经解析、切片、向量化后存入 Chroma 数据库,最终由 LangChain 框架实现上下文问答。该方法无需付费 API,解决了大模型知识滞后问题,并提供环境搭建、核心代码实现及性能优化建议。

高斯过程是一种非参数贝叶斯学习方法,通过核函数度量数据相似性,擅长小样本回归与不确定性量化。深入解析其数学定义、协方差函数选择、超参数优化策略及稀疏近似方法,并结合 Python Scikit-learn 库提供完整的回归预测代码示例与可视化分析,帮助读者掌握 GP 在机器学习中的核心应用与扩展变体。内容涵盖从基础理论到工程实践的全流程,包括模型训练、超参数调整、置信区间可视化及常见问题解决方案。

综述由AI生成如何使用 OpenAI Python SDK 调用大模型工具功能。通过定义函数 Schema 和执行逻辑,实现了让大模型自主运行系统命令的能力。内容涵盖客户端初始化、工具定义、消息循环处理及结果解析,并提供了安全建议与最佳实践,帮助开发者构建具备行动能力的大模型应用。
综述由AI生成探讨了知识图谱在检索增强生成(RAG)系统中的应用,涵盖查询增强、数据块提取、递归查询、响应增强及访问控制等关键阶段。通过医学领域的实际案例,展示了如何利用结构化数据提升大模型回答的准确性与一致性,并讨论了个性化与权限管理的实现方式。文章还分析了图谱构建成本、延迟优化及技术挑战,为构建高可靠性的混合检索系统提供了理论依据与实践指南。

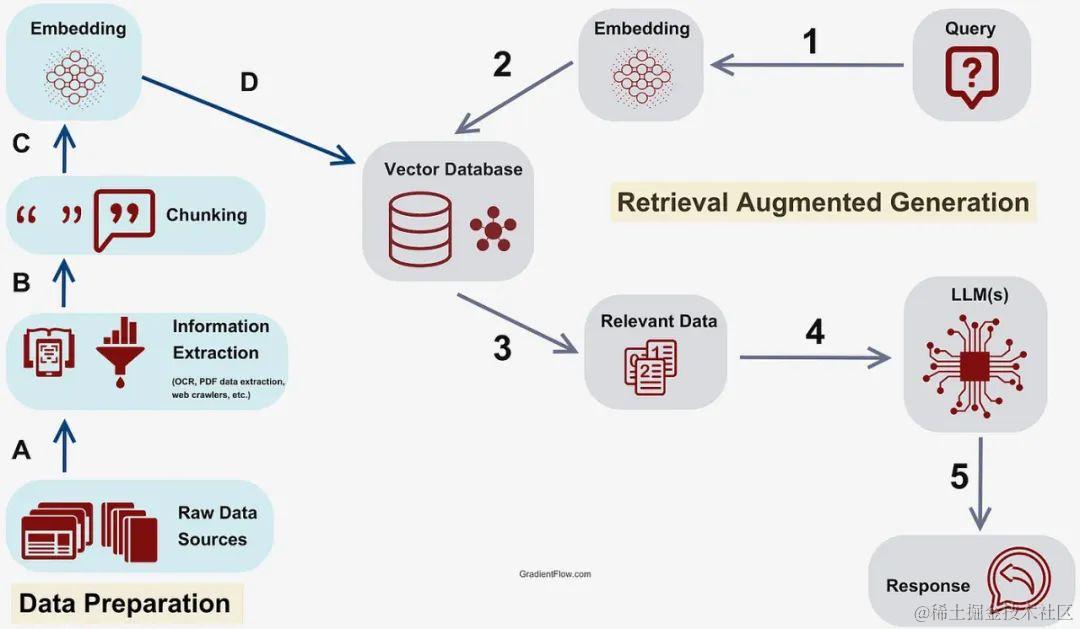
综述由AI生成检索增强生成(RAG)是一种为大模型提供外部知识源的技术,旨在解决模型幻觉和知识更新滞后的问题。文章详细阐述了 RAG 的工作原理,包括检索、增强和生成三个步骤,并基于 LangChain 框架演示了如何使用 OpenAI 模型和 Weaviate 向量数据库构建 RAG 管道。内容涵盖环境配置、数据加载分块、向量存储、检索器构建及链式调用,并补充了混合检索、重排序及评估体系等优化策略,为开发者提供了完整的理论指导与实战方案。
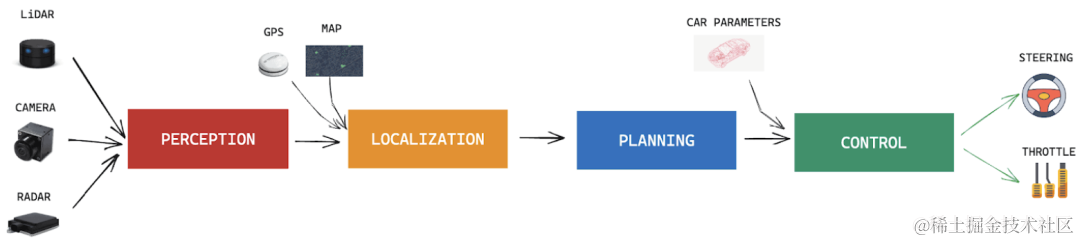
综述由AI生成探讨了大语言模型(LLMs)在汽车自动驾驶领域的应用。文章首先回顾了传统模块化自动驾驶架构的局限性,引出端到端学习和大模型的优势。接着详细介绍了 LLM 的核心概念,包括 Token 化、Transformer 架构及文本生成原理。随后重点分析了 LLM 在环境感知、决策规划和图像生成三大场景的具体应用,如多模态感知、思维链推理及世界模型仿真。最后讨论了模型幻觉等挑战及缓解方案,展望了自动驾驶大模型的未来发展趋势。
综述由AI生成深入解析向量数据库的核心原理,涵盖从 GPT Token 限制背景下的需求出发,介绍向量嵌入技术如何将非结构化数据转化为高维向量。详细阐述了相似性搜索算法如 K-Means、HNSW、LSH 及乘积量化 PQ 的实现机制与权衡。同时对比了欧几里得距离、余弦相似度等测量方法,探讨了元数据过滤策略。最后分析了分布式架构、安全性及 API 设计等选型要素,并列举了主流开源向量数据库与传统数据库扩展方案,为开发者构建 AI 应用提供技术参考。
综述由AI生成深入解析了大型语言模型(LLM)中 Token 的核心概念、映射机制及分词技术。内容涵盖 Token 的定义与长度估算、数值表示与嵌入、对模型上下文窗口及训练数据的影响,以及字节对编码(BPE)等主流分词方法。同时探讨了 Token 在应用中的状态监控、长度限制应对策略(如截断、重组、滑动窗口),并分析了大小写敏感、数字分块不一致等设计局限性。文章最后展望了多模态 Token 化趋势及未来优化方向,为开发者理解 LLM 底层逻辑及高效使…
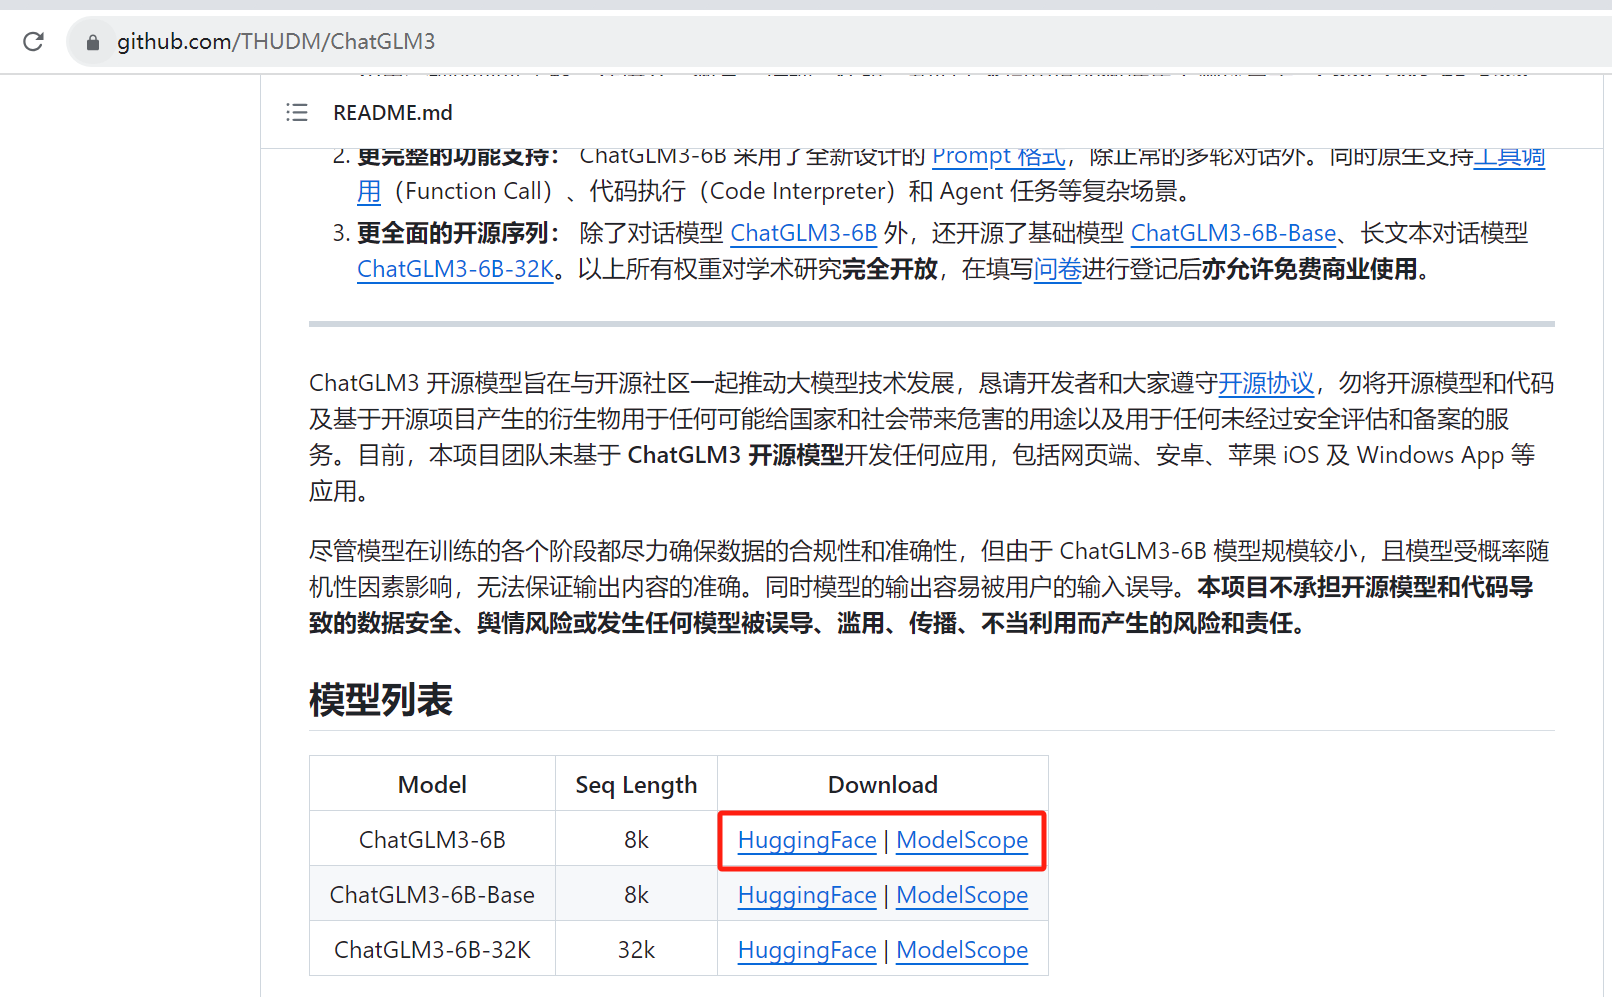
综述由AI生成国产大语言模型 ChatGLM3 的本地化部署全流程。涵盖源码获取、Conda 环境配置、PyTorch 依赖安装及 CUDA 版本匹配。重点讲解了显存优化方案,包括 FP16 与 4-bit 量化的区别与应用场景。提供了基于 Gradio 和 Streamlit 的 Web Demo 启动方法,并针对 GPU 识别失败等常见问题给出排查步骤。此外,还阐述了 OpenAI 兼容 API 的搭建方式及自定义工具扩展(Function Ca…

综述由AI生成探讨了 RAG 架构中检索后处理的重要性,重点介绍了 Rerank(重排序)技术。通过对比 Cohere 在线模型与 BGE-Reranker-large 本地模型,详细演示了基于 LlamaIndex 框架的集成方法。内容涵盖 Cohere API 调用、TEI 工具部署本地服务、自定义 Postprocessor 实现以及性能评估建议。旨在帮助开发者提升检索精度,优化大模型生成质量。

综述由AI生成探讨了大模型 RAG 应用中两种高级检索模式:融合检索与递归检索。融合检索通过多路检索(如问题重写、多索引类型)结合重排序算法提升召回精度,适用于对准确性要求高的场景。递归检索则通过层级链接(Chunk 到 Chunk、检索器、RAG 引擎或 Agent)实现深度探索,适合处理长文档或复杂结构化数据。文章分析了各模式的实现原理、关键技术及在 LangChain/LlamaIndex 中的落地方式,并提供了实施建议,帮助开发者根据业务需求…
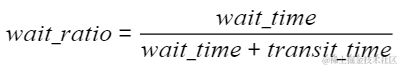
综述由AI生成详细阐述了 AI 大模型训练性能的定义、核心指标及优化策略。内容涵盖训练时间构成、吞吐率、线性度、算力利用率(MFU/HFU)等关键指标的计算与分析方法。深入探讨了分布式训练并行技术(数据、张量、流水线并行)及混合精度、重计算、FlashAttention 等优化手段。最后基于昇腾 910B3 硬件环境提供了具体的性能测试说明与数据参考,旨在帮助开发者理解 LLM 训练性能基准,识别瓶颈并进行针对性调优。

综述由AI生成大语言模型(LLM)是一种理解和生成人类语言的人工智能模型,其核心在于大型神经网络。解析了神经网络的权重机制,介绍了 LangChain 框架及检索增强生成(RAG)技术以应对 Token 限制和幻觉问题。教程详细演示了开发环境的配置步骤,涵盖 Git 密钥管理、Conda 虚拟环境创建、llm-universe 项目克隆、NLTK 资源本地化安装以及 JupyterLab 内核绑定,帮助开发者快速搭建大模型应用基础环境。

综述由AI生成记录了一名动物医学专业毕业生从宠物医院转行至互联网后端及 AI 大模型领域的真实经历。文章详细描述了转行前的职业倦怠、心理挣扎及裸辞决策过程,并梳理了转行初期的学习路径与困难。随后,文章提供了一份针对非科班出身者的 AI 大模型技术学习路线图,涵盖基础编程、提示词工程、RAG 应用开发、模型微调及多模态技术等内容。旨在为希望跨界进入人工智能行业的从业者提供可参考的经验分享与技术指引。
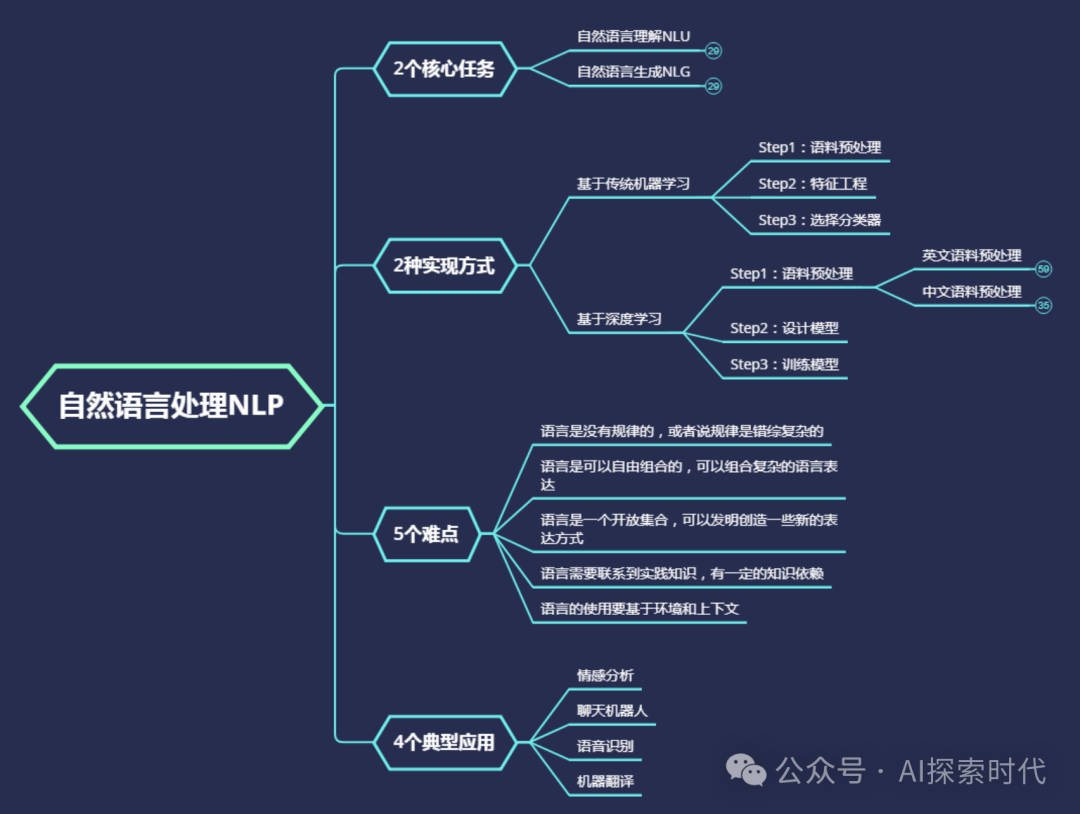
综述由AI生成详细梳理了大模型的核心任务类型与广泛应用场景。涵盖自然语言处理、计算机视觉、语音处理、多模态学习等基础领域,并延伸至推荐系统、数据分析、代码生成、科研及自动化控制等行业应用。通过解析各任务的技术特点与落地案例,帮助读者理解大模型能力边界,为技术选型与业务创新提供参考依据。同时指出幻觉、安全、成本与伦理等实施挑战,确保技术应用稳健可靠。
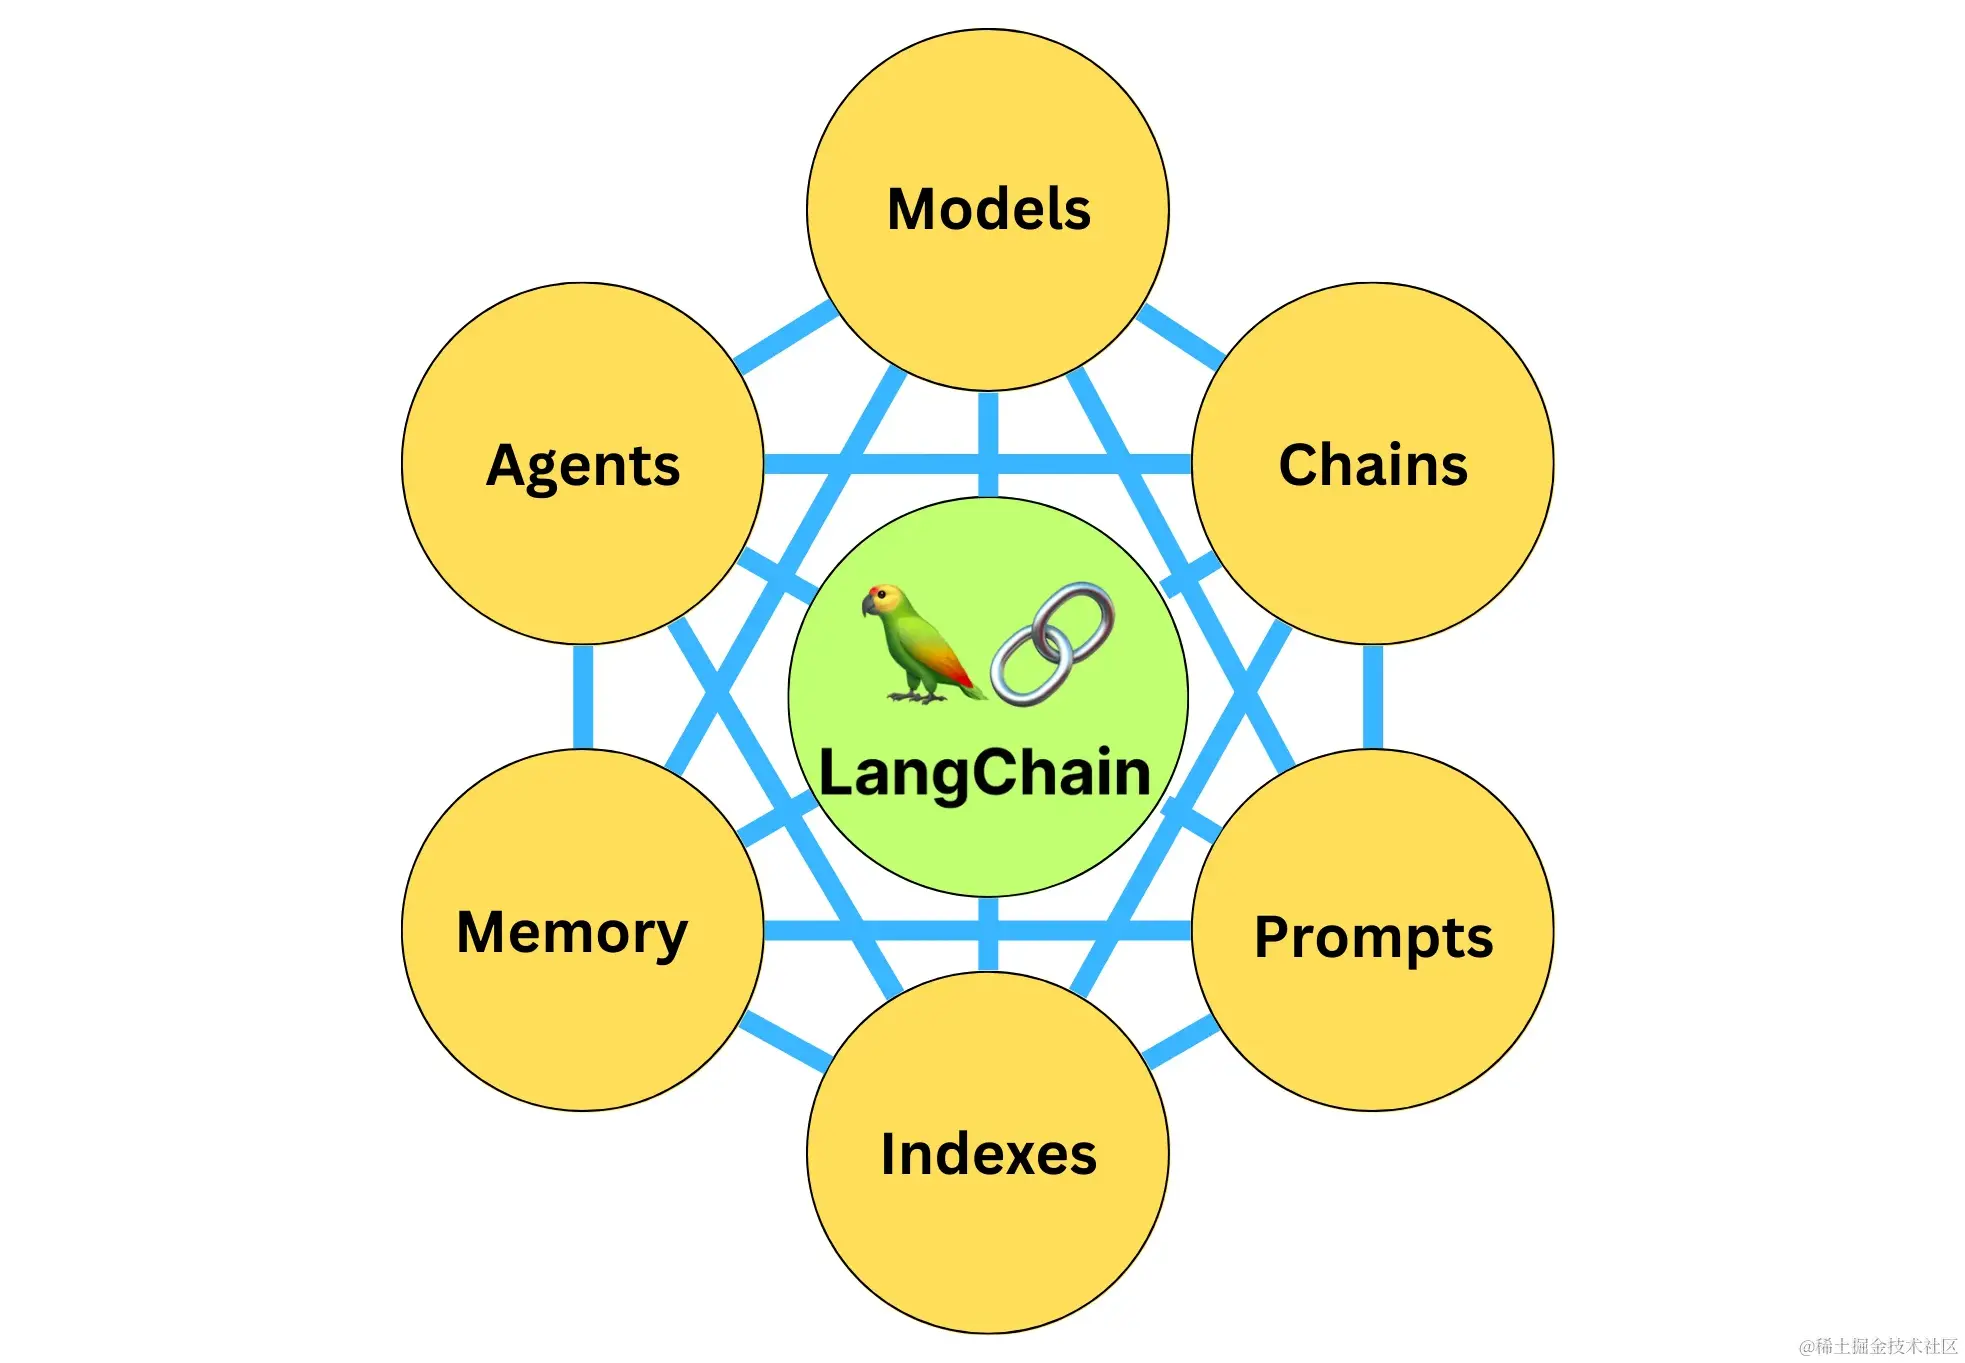
综述由AI生成LangChain 中 Agent 的核心概念及 ReAct 思维框架,详细讲解了如何通过代码实现基于搜索和计算的智能定价 Agent。内容涵盖 Agent 的组成部分、ReAct 原理、从零搭建 Agent 的完整流程、自定义工具方法以及多 Agent 协作模式。文章还分析了常见 Agent 类型的区别,提供了调试技巧和最佳实践,旨在帮助开发者利用大模型构建具备自主决策能力的智能应用。

综述由AI生成深入探讨了 LLM 反思工作流的三种典型技术:Self-Refine、CRITIC 和 Reflexion。Self-Refine 通过单一模型的迭代反馈优化输出;CRITIC 利用外部工具交互验证并修正结果;Reflexion 则引入语言强化学习和长期记忆机制,使 Agent 能从失败中积累经验。文章分析了各方法的原理、架构及在数学、编程等任务上的性能提升数据,并通过代码示例和对比表格展示了不同场景下的应用策略,强调了自我反思在提升大…